
SEO & GEO
Wat is een multimodaal model? Uitleg voor B2B

Kopieer voor AI
Een multimodaal model is een AI-model dat tekst, beeld, geluid en video samen verwerkt.
In plaats van alleen woorden te lezen, “ziet” en “hoort” het ook. Het is de technologie achter AI-tools waaraan je een foto toont en een vraag stelt in dezelfde beweging.
Het verdict: een multimodaal model leest je volledige pagina, tekst én beeld. Voor B2B blijft tekst de belangrijkste laag, maar beelden zonder uitleg zijn een gemiste kans.
Hieronder: wat het is, hoe het verschilt van een gewoon taalmodel en wat je er als B2B-marketeer mee doet.
Wat is een multimodaal model precies?
Een AI-model dat meerdere soorten input tegelijk verwerkt en er verbanden tussen legt.
Wat is een modaliteit?
Een modaliteit is een type input. Tekst is één modaliteit, beeld een andere, geluid nog een andere.
Een gewoon taalmodel werkt met één modaliteit: tekst.
Een multimodaal model verwerkt er meerdere tegelijk.
Volgens IBM verwijst multimodale AI naar systemen die informatie uit verschillende soorten data integreren tot één begrip.
De korte definitie staat ook in onze wiki onder multimodaal model.
Eén netwerk, geen bundel losse modellen
Belangrijk: het is geen verzameling losse modellen die naast elkaar draaien.
Het is één neuraal netwerk, getraind op gekoppelde data. Denk aan afbeeldingen met bijhorende bijschriften, of video’s met transcripties.
Zo leert het model wat bij elkaar hoort, zoals een beeld en zijn beschrijving.
Wat gebeurt er onder de motorkap?
Het model zet elke modaliteit om naar dezelfde interne taal: een reeks getallen die betekenis vasthoudt.
Die getallenreeksen heten embeddings. Een foto van een productverpakking, het woord “verpakking” en een gesproken vraag over die verpakking landen zo in dezelfde ruimte.
Daardoor kan het model ze koppelen:
Dit is dezelfde machine learning-logica als bij tekstmodellen, alleen breder toegepast.
De modaliteiten op een rij
Hieronder de gangbare modaliteiten en waarom ze voor B2B-content tellen.
| Modaliteit | Wat het model ermee doet | Waarom het telt voor B2B |
|---|---|---|
| Tekst | Leest en genereert taal, de basis van de meeste antwoorden | Blijft de belangrijkste laag voor citaties in AI-zoekmachines |
| Beeld | Herkent objecten, schema’s en tekst in afbeeldingen | Diagrammen en productfoto’s worden mee begrepen |
| Audio | Zet spraak om naar tekst en interpreteert toon | Relevant voor podcasts, webinars en voice-search |
| Video | Combineert beeld en audio over tijd | Demo’s en uitlegvideo’s worden inhoudelijk leesbaar |
Vuistregel: elke rij in die tabel is een plek waar je content leesbaar of onleesbaar kan zijn.
Hoe verschilt het van een gewoon taalmodel?
Een taalmodel leest alleen tekst; een multimodaal model plaatst meerdere inputsoorten in dezelfde ruimte.
Van tekst naar tekst plus beeld
Een large language model begrijpt alleen tekst.
Een multimodaal model bouwt daarop voort. Het kan inputsoorten vergelijken en combineren, en dat opent nieuwe mogelijkheden:
- Beeld beschrijven: je toont een foto, het model legt uit wat erop staat
- Vraag over een afbeelding: je uploadt een grafiek en vraagt de kernboodschap
- Combinaties genereren: van tekst naar beeld, of van beeld plus vraag naar tekst
Meer over hoe taalmodellen in marketing werken, lees je in wat een LLM is voor marketeers.
Bekende voorbeelden: GPT-4o en Gemini
GPT-4o van OpenAI kan tekst, beeld en audio in realtime aan.
Google Gemini is vanaf de basis opgezet om meerdere datatypes binnen één architectuur te verwerken.
Google schrijft zelf dat Gemini-modellen “built to be multimodal from the ground up” zijn. Ze doen beeldtaken als bijschriften schrijven, classificeren en vragen over een beeld beantwoorden (Gemini API-documentatie over beeldbegrip).
Ter illustratie: volgens diezelfde documentatie kost een kleine afbeelding van maximaal 384 bij 384 pixels 258 tokens. Grotere beelden worden opgeknipt in tegels van 768 bij 768 pixels, elk ook 258 tokens.
Een beeld wordt voor het model dus letterlijk een reeks tokens, net als tekst.
Zo ziet de Gemini-interface eruit wanneer je er een vraag aan stelt:
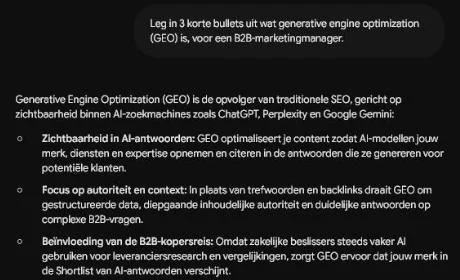 Gemini (Google Workspace-account, Flash-model), 17 oktober 2026: hier met een tekstvraag; hetzelfde model verwerkt ook beelden.
Hoe de grote assistenten van elkaar verschillen, staat in ChatGPT vs Gemini.
Deep learning en foundation models
Onder de motorkap gaat het nog steeds om deep learning, toegepast op meer dan alleen tekst.
Zulke modellen zijn doorgaans ook een foundation model: breed getraind en veelzijdig inzetbaar.
Waarom dit jou als B2B-marketeer aangaat
Omdat AI niet langer alleen je tekst beoordeelt.
AI kijkt mee naar je beelden
Als een AI-zoekmachine of assistent je pagina bekijkt, kan ze in principe ook je afbeeldingen, diagrammen en video meenemen.
Dus verdient visuele content dezelfde zorg als tekst.
Google bevestigt die combinatie voor zijn eigen zoekmachine. Het gebruikt alt-tekst “along with computer vision algorithms and the contents of the page” om te begrijpen waar een afbeelding over gaat (Google over afbeeldingen in Search).
Drie dingen die je concreet doet
Dit zijn de drie ingrepen met de meeste impact:
- Beschrijf je beelden goed: duidelijke bijschriften en alt-teksten
- Maak grafieken leesbaar: wat een mens snapt, moet ook een model snappen
- Zorg voor samenhang: tekst en beeld die elkaar versterken
Hoe je zo’n beschrijving schrijft, lees je in alt-teksten voor multimodale AI. De basis staat in onze wiki over de alt-tekst.
Voorbeeld van Google zelf: alt=“puppy” noemt Google “Better”, alt=“Dalmatian puppy playing fetch” noemt het “Best”. Specifiek wint van generiek.
De link met GEO
Dit alles sluit aan bij generative engine optimization, de nieuwe laag bovenop klassieke SEO.
Wil je dat AI je bedrijf als bron vermeldt, dan telt hoe goed je volledige content te begrijpen is, tekst én beeld.
Daar zetten we met onze GEO-agency aanpak op in. Waar je vandaag staat, test je snel met onze GEO-check.
Een concreet B2B-voorbeeld
Stel: een softwarebedrijf zet een vergelijkingstabel als afbeelding op zijn pricingpagina. Mooi vormgegeven, maar zonder tekstuele tegenhanger.
Een klassiek taalmodel ziet daar niets van. Voor de tekstlaag bestaat die tabel niet.
Een multimodaal model kan de afbeelding wél interpreteren. Maar dan nog blijft het risicovol om je belangrijkste boodschap enkel in beeld te stoppen.
Zet je diezelfde informatie ook als leesbare tekst neer, met een duidelijke alt-tekst bij de afbeelding? Dan begrijpt zowel een generatieve AI als een klassieke zoekmachine wat je aanbiedt.
In de praktijk: die dubbele leesbaarheid, tekst plus beeld, maakt het verschil tussen wel of niet geciteerd worden.
Veelgemaakte fouten
De meest voorkomende misvatting: denken dat “multimodaal” betekent dat je nu overal video en audio moet produceren. Dat is niet zo.
Dit zijn de drie echte missers:
- Info alleen in beeld: een infographic, tabel of screenshot zonder tekstuele tegenhanger
- Lege alt-teksten: “afbeelding1” of een leeg veld
- Inconsistentie: een grafiek die iets anders beweert dan de tekst eromheen
Bij de eerste fout vertrouw je erop dat elk systeem je beeld foutloos leest, en dat is een gok.
Bij de tweede mis je een kans. Een korte, feitelijke beschrijving helpt zowel bezoekers met een screenreader als AI om je beeld te plaatsen.
Meer technische tips voor beelden vind je in afbeeldingen optimaliseren voor SEO.
Hoeveel moet je hier nu al mee doen?
Minder dan de hype doet vermoeden. Tekst blijft voor de meeste B2B-bedrijven de belangrijkste laag.
Tekst eerst, beeld goed beschreven
Daar worden de meeste antwoorden en citaties uit gehaald. Je hoeft dus niet meteen een videostrategie op te tuigen omdat modellen multimodaal worden.
Wat wel loont: je bestaande beelden fatsoenlijk beschrijven. En geen belangrijke boodschap uitsluitend in een afbeelding verstoppen die niemand, mens noch model, kan lezen.
Dat is laaghangend fruit.
Wanneer video wel telt
Maak je al demo’s of webinars? Dan loont het om ze leesbaar te maken met een transcript en een duidelijke titel.
Hoe video in AI-antwoorden opduikt, lees je in video’s in AI Overviews. Voor de klassieke kant is er onze gids over video SEO.
Stuur op klanten, niet op trends
Zoals altijd geldt: stuur op klanten en omzet, niet op elke technische trend.
Als klein team dat snel beweegt, kiezen we de ingrepen met de meeste impact eerst. Dat is meestal helderheid, niet meer productie.
Dezelfde redenering geldt als je wil dat je merk opduikt in AI-assistenten. Hoe je gevonden wordt in ChatGPT draait vooral om heldere, goed gestructureerde content, niet om zoveel mogelijk mediaformaten.
Zo ziet een gewoon tekstantwoord van ChatGPT eruit, het formaat waarin de meeste B2B-vragen vandaag nog beantwoord worden:
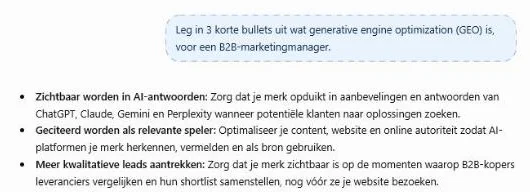 ChatGPT gratis (tijdelijke chat), 17 oktober 2026: drie bullets, ongeveer 70 woorden, geen bronnen.
Ook een model dat beelden kan lezen, antwoordt hier puur in tekst. Daarom blijft je tekstlaag de basis.
Veelgestelde vragen
Wat betekent “multimodaal”?
Het betekent dat het model meerdere soorten input tegelijk verwerkt: tekst, beeld, geluid en soms video. “Modaliteit” staat voor een type data.
Is een multimodaal model gewoon meerdere modellen samen?
Nee. Het is één neuraal netwerk dat getraind is op gekoppelde data, zodat het verbanden legt tussen bijvoorbeeld een afbeelding en de bijhorende tekst. Dat is net het verschil met losse modellen naast elkaar.
Welke tools zijn multimodaal?
Bekende voorbeelden zijn GPT-4o van OpenAI en Google Gemini. Ze kunnen tekst en beeld (en deels audio) binnen één systeem verwerken.
Wat betekent dit voor mijn content?
AI kan je beelden mee interpreteren, dus geef ze duidelijke bijschriften en alt-teksten. Stop geen kernboodschap uitsluitend in een afbeelding. Zo blijft je volledige content begrijpelijk voor mens en model.
Wil je klaar zijn voor AI-gedreven zoeken?
Begin met helderheid: leesbare tekst, beschreven beelden, geen boodschap die alleen in een afbeelding staat.
Vertel ons waar je staat met je content en zichtbaarheid. We zeggen je wat wel en niet loont, met concrete stappen die klanten opleveren en geen hype. Neem contact op.
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.