
SEO & GEO
Wat is een small language model (SLM)? B2B-uitleg

Kopieer voor AI
Een small language model (SLM) is een compact taalmodel met minder parameters dan een LLM.
Daardoor kan het goedkoper, sneller en zelfs lokaal draaien, op eigen hardware in plaats van in de cloud.
Het verdict: een small language model is dezelfde technologie als een large language model, op kleinere schaal. Het wint bij smalle, herhaalde taken waar privacy, snelheid en kosten zwaarder wegen dan brede kennis. Voor je zichtbaarheid in AI-zoekmachines blijven de grote modellen bepalend.
Wat is een small language model precies?
Een taalmodel dat tekst begrijpt en genereert, net als zijn grote broer, maar veel kleiner.
Waar een large language model tientallen tot honderden miljarden parameters telt, blijft een SLM doorgaans tussen enkele miljoenen en zo’n 7 miljard parameters.
Parameters zijn de interne getallen die het model tijdens de training leert. Meer parameters betekent meer capaciteit. Maar ook meer rekenkracht per antwoord.
Een korte definitie vind je ook in onze wiki: small language model.
Praktisch onderscheid, geen harde grens
Volgens IBM is het onderscheid vooral praktisch.
Een SLM is klein genoeg om op gewone of ingebouwde hardware te draaien, zonder dat je afhankelijk bent van een zware cloudverbinding. IBM spreekt van “a few million to a few billion parameters”, tegenover honderden miljarden of zelfs biljoenen bij LLM’s.
De grens schuift wel op. Microsoft noemt zijn Phi-4 met 14 miljard parameters nog steeds “a small size” (Microsoft over Phi).
Vuistregel: past het model op een laptop of een eigen server, dan spreekt men van een SLM.
Dezelfde techniek, compacter
De onderliggende techniek blijft dezelfde: het is machine learning in de vorm van deep learning, met een neuraal netwerk, alleen compacter.
Ook een SLM leest en schrijft in tokens, stukjes tekst van een paar letters. Vaak is het afgeleid van een groter foundation model.
Voorbeeld: DistilBERT is een gedistilleerde versie van BERT. Volgens IBM is het 40% kleiner en 60% sneller, en behoudt het 97% van het taalbegrip.
Kleiner hoeft dus niet dommer te zijn.
Waarom kleiner soms slimmer is
Groter is niet automatisch beter.
Kleine modellen hebben concrete voordelen:
- Lagere kosten. Minder rekenkracht betekent minder geld per gebruik, wat telt als je een model intensief inzet.
- Meer snelheid. Een compact model antwoordt sneller, handig voor realtime toepassingen.
- Privacy en controle. Een SLM kan lokaal of op eigen servers draaien, zodat gevoelige data je omgeving niet hoeft te verlaten.
- Gerichte prestatie. Voor een afgebakende taak, zoals interne documenten doorzoeken, haalt een goed getraind klein model vaak resultaten die dicht bij een groot model liggen.
IBM gaat nog verder: kleine modellen “can have comparable or even better performance than their large model equivalents”, op de taak waarvoor ze getraind zijn.
Bekende voorbeelden
Bekende voorbeelden zijn de Phi-modellen van Microsoft en de Gemma-modellen van Google, die bewust compact zijn gehouden en toch sterk presteren op hun schaal.
Hoe groot zijn ze precies? De omvang volgens IBM en Microsoft, in miljarden parameters:
Zelfs Phi-4 blijft een fractie van een LLM. Dat verschil verklaart de lagere kosten en de hogere snelheid.
Klein genoeg voor een gsm
Hoe klein is klein? Google geeft in zijn documentatie over Gemma concrete geheugencijfers (Google, Gemma-modellen).
De kleinste variant, Gemma E2B, heeft op mobiel ongeveer 1,1 GB geheugen nodig voor de gewichten. Een 12B-variant past in 4-bitsformaat in zo’n 6,7 GB.
Google mikt die kleinste varianten op gsm’s, edge-toestellen en de browser. Daarom kan een SLM lokaal draaien.
Klein model versus groot model: wanneer wat?
De taak beslist, niet de omvang.
Een groot model blinkt uit in brede, open kennis en complexe redeneringen. Een klein model is in het voordeel bij smalle, herhaalde taken waar snelheid, kosten of privacy doorwegen.
De vuistregel
Hoe specifieker en repetitiever de taak, hoe eerder een SLM volstaat.
Hoe breder en onvoorspelbaarder de vraag, hoe waardevoller een groot model wordt.
Vaak is de slimste opstelling een combinatie, waarbij een klein model het routinewerk doet en een groot model inspringt bij uitzonderingen.
De verschillen naast elkaar
De onderstaande tabel zet de belangrijkste verschillen naast elkaar, zodat je in één oogopslag ziet welk profiel bij welke taak past.
| Kenmerk | Small language model | Large language model |
|---|---|---|
| Omvang | Miljoenen tot ongeveer 7 miljard parameters | Tientallen tot honderden miljarden parameters |
| Kosten per gebruik | Laag | Hoog |
| Snelheid | Hoog, geschikt voor realtime | Lager |
| Waar het draait | Lokaal of op eigen hardware mogelijk | Doorgaans in de cloud |
| Sterkste kant | Afgebakende, herhaalde taken | Brede kennis en complex redeneren |
| Privacy | Data kan in je eigen omgeving blijven | Data gaat meestal naar een externe provider |
Waar een klein model tekortschiet
Kleine modellen onthouden minder feiten.
Microsoft schrijft zelf dat zijn Phi-3-modellen minder goed scoren op feitenkennis, omdat de kleinere omvang “less capacity to retain facts” geeft (geciteerd door IBM).
Daardoor is de kans op verzonnen antwoorden reëel.
Tip: geef een klein model je eigen documenten mee via RAG, zodat het antwoordt uit jouw bronnen in plaats van uit zijn geheugen.
Lees meer over dat risico in wat is een AI-hallucinatie.
Een voorbeeld uit de B2B-praktijk
Stel: een B2B-dienstverlener krijgt dagelijks tientallen aanvragen via één inbox.
Elke mail moet gelezen, gecategoriseerd en naar het juiste team gestuurd worden. Dat is precies zo’n smalle, terugkerende taak waar een klein model in uitblinkt.
Labelen zonder dat data vertrekt
Een compact model dat op de eigen server draait, kan elk bericht labelen zonder dat klantgegevens de organisatie verlaten.
De labels zijn bijvoorbeeld:
- offerteaanvraag
- supportvraag
- factuurvraag
Een groot model zou dit ook kunnen. Maar dan betaal je per bericht voor rekenkracht die je niet nodig hebt, en gaat gevoelige informatie naar een externe cloud.
Het kleine model doet het volume
In de praktijk zit de winst in het combineren. Zo verdeel je het werk:
Het kleine model handelt het volume af. Pas bij een twijfelgeval schakelt een mens of een groter model bij.
Wanneer zo’n automatisering de moeite loont, lees je in wanneer loont een AI-agent.
Bouwen we het voor je, dan valt het onder onze AI-agents en automatisering.
Wat betekent dit voor B2B?
Meestal is een SLM een keuze die achter een tool schuilgaat, geen doel op zich.
Toch is het nuttig om te weten dat het bestaat. Het opent praktische mogelijkheden.
Een compact model dat veilig op je eigen omgeving draait, kan bijvoorbeeld interne kennis ontsluiten of gestandaardiseerde vragen afhandelen. Gevoelige data gaat dan niet naar een externe cloud.
Let op: lokaal draaien helpt bij privacy, maar regelt de AVG niet vanzelf. Waar je data staat, lees je in EU-hosting en data residency.
Voor je zichtbaarheid tellen de grote modellen
Voor je externe zichtbaarheid blijven vooral de grote modellen relevant: die voeden de AI-zoekmachines waar je klanten hun vragen stellen.
Zo antwoordt zo’n groot model op een vraag over GEO. Let op de vorm van het antwoord:
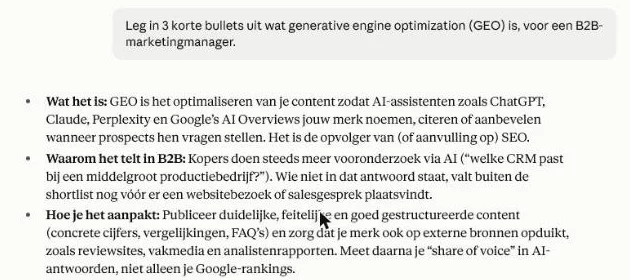 Claude, 17 oktober 2026, getest op een betaald plan in een incognitochat: drie bullets, ongeveer 130 woorden, geen bronnen.
Wil je in zulke antwoorden vermeld worden, dan draait het om generative engine optimization en sterke SEO.
Dat betekent heldere, betrouwbare content die een model makkelijk kan overnemen. Daar zetten we met onze GEO-agency aanpak op in.
Tip: test gratis of AI-assistenten je merk al noemen met onze GEO-check.
Veelgemaakte fouten met kleine modellen
Wie voor het eerst met compacte modellen werkt, loopt vaak tegen dezelfde valkuilen aan.
Drie die we het meest zien:
1. Een klein model op een brede taak zetten
Vraag je een SLM om open, gevarieerde vragen te beantwoorden, dan schiet het sneller tekort dan een groot model.
Kies een SLM alleen voor een afgebakende taak.
2. Denken dat lokaal draaien vanzelf goedkoper is
De rekenkosten per gebruik liggen lager. Maar het opzetten, hosten en onderhouden van een eigen model kost tijd en expertise.
Bij kleine volumes wint een bestaande cloud-tool vaak.
3. De modelkeuze belangrijker maken dan de datakwaliteit
Een klein model met scherpe, goed geordende data verslaat een groot model met rommelige input.
Begin bij je data, niet bij de omvang van het model.
Overschat de trend niet
“Klein en efficiënt” klinkt aantrekkelijk, maar een SLM is geen must voor elk bedrijf.
Als je vooral kant-en-klare AI-tools gebruikt, merk je van de onderliggende modelkeuze weinig.
Een eigen klein model opzetten heeft pas zin als je een concrete, terugkerende taak hebt waar privacy of kosten écht knellen.
Stuur op klanten, niet op techniek
Zoals altijd geldt onze rode draad: stuur op klanten en omzet, niet op de nieuwste techniek omdat ze efficiënt oogt.
Heb je te weinig verkeer of geen duidelijk probleem om op te lossen? Dan investeer je beter eerst in aanbod en zichtbaarheid.
Als klein team dat snel beweegt, kiezen we voor de eenvoudigste oplossing die werkt.
Veelgestelde vragen
Wat is het verschil tussen een SLM en een LLM?
Vooral de omvang. Een small language model heeft veel minder parameters (grofweg tot een paar miljard) en kan daardoor goedkoper, sneller en lokaal draaien. Een large language model is groter en breder inzetbaar, maar duurder en zwaarder.
Is een klein model minder goed?
Niet per definitie. Voor smalle, afgebakende taken presteert een goed klein model vaak dicht bij een groot model. Voor brede kennis en complexe redeneringen blijft een groot model sterker.
Kan een SLM lokaal draaien?
Ja, dat is net een groot voordeel. Doordat het compact is, kan het op gewone hardware of eigen servers draaien, waardoor gevoelige data je omgeving niet hoeft te verlaten.
Heb ik een SLM nodig voor mijn zichtbaarheid in AI?
Niet rechtstreeks. AI-zoekmachines draaien op grote modellen. Je zichtbaarheid daarin hangt af van je content, niet van welk klein model je zelf gebruikt.
Is een SLM altijd goedkoper?
Niet automatisch. De rekenkosten per gebruik zijn lager, maar een eigen model opzetten en onderhouden vraagt tijd en kennis. Bij lage volumes is een kant-en-klare tool vaak voordeliger; de winst komt pas bij een terugkerende taak op schaal.
Benieuwd wat AI voor jouw groei kan doen?
Vertel ons waar je staat, en we zeggen welke AI-keuzes wel en niet lonen voor jouw B2B-situatie.
Concrete stappen, geen hype. Neem contact op en je hoort binnen 24 uur wat we eerst zouden doen.
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.