
SEO & GEO
Wat is een large language model (LLM)? De definitie

Kopieer voor AI
Een large language model (LLM) is een AI-model dat taal begrijpt en genereert.
Het is getraind op enorme hoeveelheden tekst, en het is het type model achter ChatGPT, Google Gemini en Microsoft Copilot.
Het verdict: een LLM voorspelt tekst, het zoekt geen feiten op. Dat maakt het een sterk werktuig én een nieuw zoekkanaal, maar nooit een feitenbron.
Dit is de brede definitie: wat een LLM is, hoe groot ze zijn en waar ze passen in het AI-landschap.
Wil je precies weten hoe een LLM tot een antwoord komt? Onze uitleg over LLM’s voor marketeers gaat dieper op de werking in.
Wat is een large language model precies?
Een AI-systeem dat taalpatronen leerde uit een gigantische verzameling tekst, en die kennis gebruikt om nieuwe tekst te maken.
De drie woorden
De naam vat het samen:
- Large slaat op de schaal, zowel de hoeveelheid trainingstekst als de omvang van het model zelf.
- Language betekent dat het met taal werkt, dus met woorden en zinnen, niet met cijfers in een database.
- Model wil zeggen dat het een wiskundig systeem is dat patronen heeft geleerd en toepast op nieuwe vragen.
Wat IBM erover zegt
IBM noemt LLM’s een categorie deep learning-modellen, getraind op immense hoeveelheden data.
Die data bestaat uit miljarden tot biljoenen woorden. Denk aan boeken, artikels, websites en code.
In de kern is een LLM getraind om, op basis van context, telkens de meest waarschijnlijke volgende tekst te voorspellen.
Het bevat geen kant-en-klaar archief van feiten dat het opzoekt. Het bouwt elk antwoord ter plekke opnieuw op.
Hoe werkt een large language model?
In drie stappen: tekst opdelen in tokens, context wegen, en het volgende token voorspellen.
Stap 1: tekst wordt tokens
Een LLM leest geen woorden maar tokens: kleine stukjes tekst die een machine kan verwerken.
Een lang woord kan uit meerdere tokens bestaan. Wat een token precies is, leggen we apart uit.
Stap 2: de transformer weegt context
IBM schrijft dat LLM’s gebouwd zijn op een soort neuraal netwerk dat een transformer heet.
Een transformer weegt hoe de tokens in je vraag met elkaar samenhangen. Zo bepaalt hij welke woorden bij elkaar horen.
Stap 3: het volgende token voorspellen
Daarna voorspelt het model het meest waarschijnlijke volgende token. Dan het token daarna, en zo verder.
Zo ontstaat een volledig antwoord, woord na woord:
Daarom: een LLM klinkt altijd zeker, ook wanneer het fout zit.
Hoe het model leert
Eerst leert het model taal uit een enorme berg tekst. Daarna kan het verder getraind worden voor een specifieke taak, wat IBM fine-tuning noemt.
Een bekende extra stap heet RLHF.
Daarbij rangschikken mensen antwoorden. Het model leert de hoogst gescoorde antwoorden te verkiezen.
Hoe “large” is large?
Groot genoeg om miljarden interne getallen te tellen: dat onderscheidt een LLM van kleinere taalmodellen.
Parameters
De grootte druk je uit in parameters: de interne getallen die het model tijdens de training bijstelt.
GPT-3, het model dat de doorbraak inluidde, telde 175 miljard parameters. Zo staat het in het oorspronkelijke onderzoek van OpenAI, “Language Models are Few-Shot Learners”.
Volgens dezelfde paper was dat 10 keer meer dan elk eerder niet-sparse taalmodel. Moderne modellen zitten in dezelfde orde of hoger.
Groter is niet altijd beter
Meer parameters betekent grofweg meer capaciteit om nuance en patronen op te slaan. Maar ook meer rekenkracht en kosten.
Niet elk taalmodel hoeft groot te zijn. Een small language model is bewust compacter, zodat het goedkoper en lokaal kan draaien.
Vuistregel: de taak en de privacy-eisen bepalen de modelkeuze, niet het aantal parameters.
Waar past een LLM in het AI-landschap?
Een LLM is een foundation model voor tekst, gebouwd met deep learning.
Van breed naar specifiek
Even ordenen, want de termen lopen makkelijk door elkaar:
- Artificiële intelligentie is de brede noemer.
- Machine learning is de tak die leert uit data.
- Deep learning is machine learning met een neuraal netwerk met veel lagen.
- Een foundation model is een breed getraind basismodel dat je voor veel taken kan inzetten.
- Een large language model is een foundation model dat gespecialiseerd is in tekst.
Kortom: een LLM is een specifieke toepassing van deep learning op taal, gebouwd als foundation model.
De begrippen naast elkaar
De onderstaande tabel plaatst de begrippen naast elkaar, van breed naar specifiek.
| Begrip | Wat het is | Verhouding tot een LLM |
|---|---|---|
| Artificiële intelligentie | De brede noemer voor slimme systemen | Overkoepelend, veel breder dan een LLM |
| Machine learning | Systemen die leren uit data | Een LLM is hier een tak van |
| Deep learning | Machine learning met diepe neurale netwerken | De techniek waarop een LLM draait |
| Foundation model | Breed getraind basismodel voor veel taken | Een LLM is een foundation model voor tekst |
| Large language model | Foundation model gespecialiseerd in taal | Het model achter ChatGPT, Gemini en Copilot |
LLM versus generatieve AI
Generatieve AI is breder: het maakt ook beelden, audio of video. Een LLM is de tekstvariant.
Het verschil lees je in wat is generatieve AI.
Waarom gaat een LLM jou als B2B-marketeer aan?
Omdat je klanten hun vragen steeds vaker aan een LLM stellen in plaats van tien blauwe links te scannen.
Dat verandert twee dingen voor je marketing.
Een werktuig
Ten eerste is een LLM een werktuig. Je gebruikt het om sneller concepten, mails en analyses te maken.
Een nieuw zoekkanaal
Ten tweede, en belangrijker, is een LLM een nieuw zoekkanaal.
Wanneer een model een antwoord genereert, kiest het welke bronnen het vermeldt of citeert. Wil je daarin verschijnen, dan draait het om generative engine optimization.
Dat vraagt content die helder, betrouwbaar en goed gestructureerd is, in het verlengde van sterke SEO. Omdat een LLM leert uit tekst en patronen, is dat precies wat het beloont.
Daar zetten we met onze GEO-agency aanpak op in.
Niet elk LLM toont bronnen
We stelden op 17 oktober 2026 dezelfde GEO-vraag aan vier AI-assistenten. Het verschil in bronnen was groot:
Perplexity zet onder elke bullet een bronlabel:
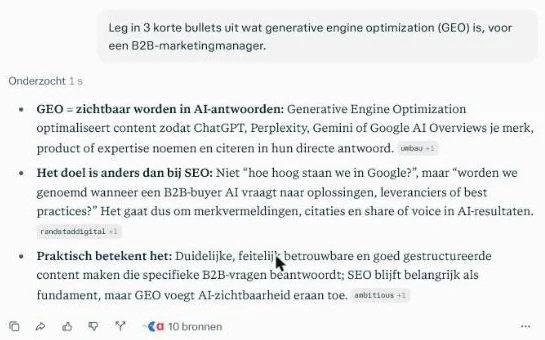 Perplexity met een gratis account, 17 oktober 2026: drie bullets, een bronlabel bij elke bullet en 10 bronnen in totaal.
ChatGPT gaf in de gratis versie een kort antwoord zonder bronnen:
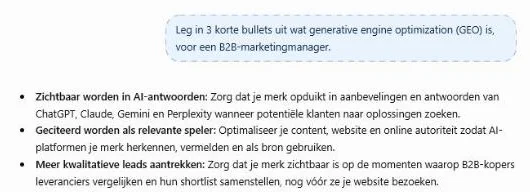 ChatGPT gratis (tijdelijke chat), 17 oktober 2026: drie bullets, ongeveer 70 woorden, geen bronnen.
Claude antwoordde langer, maar ook zonder bronnen:
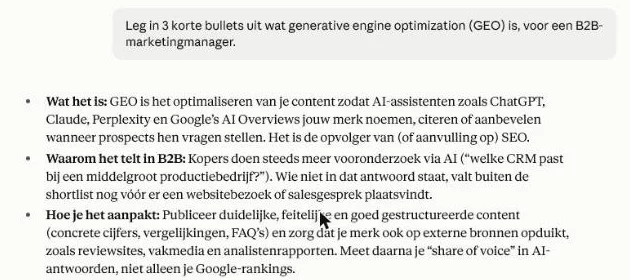 Claude, 17 oktober 2026, getest op een betaald plan in een incognitochat: drie bullets, ongeveer 130 woorden, geen bronnen.
En Gemini gaf een introzin plus drie bullets:
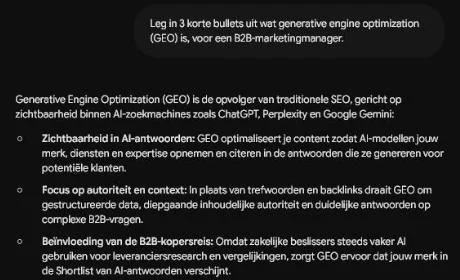 Gemini (Google Workspace-account, Flash-model), 17 oktober 2026: een introzin plus drie bullets, ongeveer 110 woorden.
Perplexity toonde 10 bronnen, de andere drie geen enkele. ChatGPT antwoordde in ongeveer 70 woorden, Gemini in 110 en Claude in 130.
De les: zonder bronnen moet een model jouw merk uit zijn training kennen. Met bronnen moet je bij die bronnen horen.
Hoe Google’s AI-antwoorden bronnen kiezen
Google’s AI Overviews en AI Mode draaien ook op taalmodellen.
Google schrijft dat ze een “query fan-out”-techniek kunnen gebruiken: meerdere verwante zoekopdrachten over subonderwerpen tegelijk.
Volgens Google zijn er geen extra vereisten om erin te verschijnen. Je pagina moet geïndexeerd zijn en met een snippet kunnen verschijnen.
Hoe je daar opduikt, lees je in gevonden worden in Google AI Overviews.
Een concreet B2B-voorbeeld
Neem een softwarebedrijf dat verkoopt aan HR-managers.
Vroeger begon de zoektocht van een prospect bij Google. Nu tikt diezelfde manager in ChatGPT:
“Welke tools helpen bij onboarding op afstand?”
De LLM stelt zijn antwoord ter plekke samen en noemt enkele aanbieders.
Of jouw bedrijf daartussen zit, hangt af van hoe consistent en verifieerbaar je online uitlegt wat je oplost en voor wie.
Een pagina die duidelijk het probleem, de doelgroep en het resultaat benoemt, geeft het model houvast. Vage marketingtaal geeft dat niet.
In de praktijk: wat mensen overtuigt, helpt ook een LLM om jouw naam aan de vraag te koppelen.
Veelgemaakte fouten rond LLM’s
Drie misverstanden kosten B2B-teams tijd en vertrouwen:
- Een LLM als feitenbron behandelen. Het model voorspelt tekst, het verifieert niets. Laat een mens altijd de feiten en de bronnen checken voordat iets naar buiten gaat.
- Denken dat groter altijd beter is. Voor veel taken volstaat een small language model dat goedkoper en lokaal draait. De taak en de privacy-eisen bepalen de keuze, niet het aantal parameters.
- Volume verwarren met waarde. Tien keer meer content genereren die niemand leest, helpt niet. Stuur op stukken die gekwalificeerde leads opleveren en die een model als betrouwbaar kan overnemen.
Waar zit de grens voor B2B?
Een LLM begrijpt niets zoals een mens: het rekent met waarschijnlijkheden.
Daarom kan het overtuigend een fout antwoord geven. Voor B2B wegen vertrouwen en correctheid zwaar.
Dus: gebruik AI als versneller, niet als eindredacteur. Laat een mens altijd de feiten en de toon bewaken.
Stuur op klanten, niet op tools
Ook hier geldt onze rode draad: stuur op klanten en omzet, niet op de nieuwste tool omdat iedereen erover praat.
Een LLM inzetten om tien keer meer content te produceren die niemand leest, is verspilling.
Onze ervaring: AI-modellen doen nu het meeste productiewerk. Maar goede output vraagt sterke input op drie niveaus: data, bedrijfsstrategie en bedrijfskennis.
Wil je dat een LLM je eigen documenten gebruikt in plaats van alleen zijn training?
Dan kom je bij RAG uit.
Veelgestelde vragen
Is een LLM hetzelfde als ChatGPT?
Nee. ChatGPT is een product; het large language model is de onderliggende technologie. Achter ChatGPT zit een LLM, maar dezelfde soort modellen voeden ook Gemini, Copilot en andere tools.
Wat betekenen “parameters” bij een LLM?
Parameters zijn de interne getallen die het model tijdens de training leert. Ze bepalen mee de capaciteit. GPT-3 telde er 175 miljard; grotere aantallen betekenen doorgaans meer capaciteit maar ook meer kosten.
Is een groter model altijd beter?
Niet per se. Voor veel taken volstaat een kleiner, goedkoper model dat lokaal draait. De keuze hangt af van de taak, het budget en privacy-eisen, niet van de grootte alleen.
Wat heeft een LLM met mijn vindbaarheid te maken?
AI-zoekmachines draaien op LLM’s die bepalen welke bronnen ze citeren. Heldere, betrouwbare content vergroot de kans dat een model jouw bedrijf noemt.
Wat is het verschil tussen een LLM en LLMO?
Een LLM is het model zelf.
LLMO is het optimaliseren van je content zodat zulke modellen je vermelden: zie wat is LLMO.
Wil je gevonden worden in AI-zoekmachines?
Vertel ons waar je nu staat.
We zeggen je wat wel en niet loont om zichtbaar te worden in AI. Concrete stappen, geen hype: neem contact op.
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.