
SEO & GEO
Wat is een large language model (LLM)? Uitleg voor marketeers

Kopieer voor AI
Een LLM is een AI-model dat tekst voorspelt, woord voor woord.
Een large language model, kortweg LLM, is getraind op gigantische hoeveelheden tekst.
Het bouwt antwoorden op door steeds te voorspellen welk stukje tekst logischerwijs volgt.
Het verdict: een LLM zoekt geen waarheid op, het berekent waarschijnlijke taal. Daarom wint heldere, consistente content in AI-antwoorden.
Het is de technologie achter tools als ChatGPT, Google Gemini, Microsoft Copilot en Perplexity.
Hieronder: hoe een LLM werkt, wat het kan en wat dat betekent voor je vindbaarheid.
Wat is een large language model precies?
Een computerprogramma dat taal verwerkt en genereert, getraind op patronen in een enorme verzameling tekst.
De drie woorden uitgelegd
De naam zegt het eigenlijk al:
- Large: de schaal, van de trainingstekst en van het model zelf
- Language: het werkt met woorden en zinnen, niet met cijfers in een database
- Model: een wiskundig systeem dat patronen leerde en ze toepast op nieuwe vragen
Google omschrijft een taalmodel in zijn cursus over large language models als een systeem dat de waarschijnlijkheid inschat van een token of reeks tokens binnen een langere reeks.
Een kortere definitie vind je in onze wiki over large language model. Kleinere varianten heten small language models.
Geen zoekmachine met een archief
Belangrijk om te onthouden: een LLM is geen zoekmachine met een kant-en-klaar archief van antwoorden.
Het bevat geen lijst feiten die het opzoekt.
Het leerde tijdens de training hoe taal in elkaar zit.
Welke woorden en ideeën bij elkaar horen, en welke zin doorgaans op welke volgt.
Op basis daarvan bouwt het elk antwoord ter plekke opnieuw op.
Hoe komt een LLM tot een antwoord?
Stukje voor stukje, door telkens het meest waarschijnlijke volgende tekstdeel te berekenen.
Google beschrijft LLM’s in zijn uitleg over transformers als een soort autocomplete die duizenden tokens kan voorspellen. Dat gebeurt grofweg in vier stappen:
Stap 1: je vraag wordt tokens
Eerst wordt je vraag opgeknipt in kleine stukjes tekst die tokens heten.
Een token kan volgens Google een woord, een deel van een woord of zelfs één teken zijn.
Google geeft als voorbeeld “unwatched”, dat in drie stukjes uiteenvalt: “un”, “watch” en “ed”.
Meer over die eenheid lees je in wat een token is en de korte wiki-uitleg over token.
Stap 2: kansen per volgend token
Vervolgens bekijkt het model die rij en berekent het een kans voor elk mogelijk volgend stukje tekst.
De vraag die het zich stelt: gegeven alles wat er staat, welk token volgt hier het logischst?
Zo kan dat er schematisch uitzien:
Stap 3 en 4: kiezen en herhalen
Het model kiest een token, plakt dat aan de zin en herhaalt de oefening.
Token voor token ontstaat zo het hele antwoord.
Daarom zie je in een chatbot de tekst vaak woord per woord verschijnen.
Hij wordt op dat moment letterlijk berekend.
Omdat het model niet altijd het meest waarschijnlijke token kiest, verschilt het antwoord soms per poging. Waarom dat zo is, lees je in de probabilistische aard van AI-antwoorden.
Statistiek, geen bedoeling
Die voorspellingen zijn geen giswerk.
Tijdens de training zag het model miljarden keren patronen en leidde het af welke woorden in welke context passen.
Het rekent niet met de bedoeling van een mens, maar met statistiek over taal.
Het weet bijvoorbeeld dat “offerte” vaak volgt op “een B2B-koper vraagt”, zonder te weten wat een offerte is.
Hoe AI betekenis verwerkt, lees je in wat embeddings zijn.
Hoe wordt een LLM getraind?
Door het tekst te laten lezen, het volgende woord te laten raden en het bij te sturen op fouten.
Raden, corrigeren, herhalen
Stel je een leerproces voor waarin het model een zin krijgt zonder laatste woord.
Het moet raden wat er hoort te staan.
Klopt het, dan blijft de aanpak.
Klopt het niet, dan worden de interne instellingen een tikje aangepast.
Google beschrijft het zo: tijdens de training leren LLM’s door tokens te raden die uit de trainingstekst zijn weggelaten.
Doe dat een onvoorstelbaar aantal keren op een gigantische berg tekst, en het model wordt steeds beter in het inschatten van taal.
Zo’n breed getraind basismodel heet ook een foundation model.
Twee gevolgen voor merken
Die trainingstekst komt grotendeels van het publieke internet: artikels, websites, fora en naslagwerken. Daaruit volgen twee dingen:
- Een afkappunt. Het model is getraind tot een bepaald moment en kent latere gebeurtenissen niet uit zichzelf.
- De hiaten van het web. Wat goed en consistent beschreven staat, leert het goed. Wat amper of tegenstrijdig beschreven staat, kent het slecht.
Dat laatste is precies waar je als merk invloed op hebt.
Wat kan een LLM goed, en wat niet?
Uitstekend in taal, zwak in feitelijke zekerheid.
Dat onderscheid bepaalt hoe je er verstandig mee omgaat.
Sterk in taalwerk
Een LLM blinkt uit in alles wat met taalvorm te maken heeft:
- samenvatten en herschrijven
- vertalen en toon aanpassen
- ideeën genereren
- lange teksten begrijpelijk maken
Voor dat soort werk is het een krachtige assistent. Welke tools marketeers daarvoor gebruiken, lees je in top AI-tools voor marketeers.
Zwak in feiten
De zwakte zit in de feiten.
Een model bouwt het meest waarschijnlijke antwoord op en zoekt geen waarheid op.
Daardoor kan het met volle overtuiging iets verzinnen dat plausibel klinkt maar fout is.
Denk aan een oprichtingsjaar, een prijs of een klantnaam die nergens op gebaseerd is. Dat heet hallucineren.
Google zegt het in zijn cursus ronduit: LLM’s hallucineren, hun voorspellingen bevatten vaak fouten.
Het model liegt niet bewust.
Het volgt het meest waarschijnlijke taalpatroon, ook als dat niet strookt met de werkelijkheid. Meer daarover in wat een AI-hallucinatie is.
Onze ervaring: kan een bedrijf zijn eigen positionering niet helder vertellen, dan vult het model het gat zelf in. Dan begint het te hallucineren over dat merk.
Bronnen ophalen verzacht het probleem
Veel moderne AI-tools laten het model tijdens het antwoorden actuele bronnen raadplegen.
Dan leunt het niet enkel op geheugen.
Die techniek heet retrieval-augmented generation. Uitleg vind je in wat RAG is voor marketeers.
Hoe bronnen aan een antwoord gekoppeld worden, lees je in onze uitleg over grounding: hoe AI bepaalt wat waar is.
Zelfde vraag, drie modellen
Je ziet het verschil tussen modellen meteen als je ze dezelfde vraag stelt. We vroegen ChatGPT, Claude en Gemini hoe je zichtbaar wordt in AI-antwoorden:
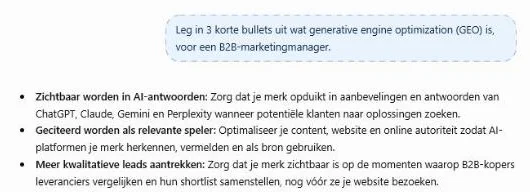 ChatGPT gratis (tijdelijke chat), 17 oktober 2026: drie bullets, ongeveer 70 woorden, geen bronnen.
Claude gaf op dezelfde vraag een langer antwoord, ook zonder bronnen:
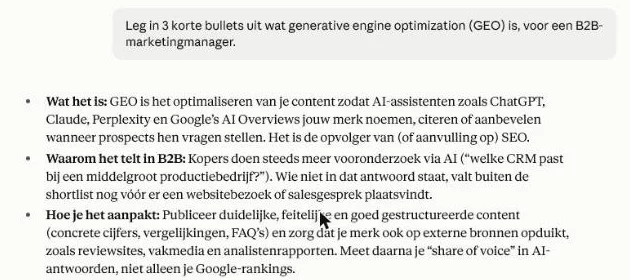 Claude, 17 oktober 2026, getest op een betaald plan in een incognitochat: drie bullets, ongeveer 130 woorden, geen bronnen.
En Gemini koos weer een andere opbouw:
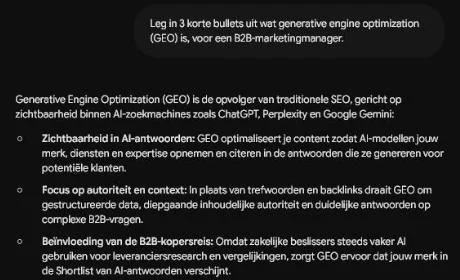 Gemini (Google Workspace-account, Flash-model), 17 oktober 2026: een introzin plus drie bullets, ongeveer 110 woorden.
Drie modellen, drie lengtes, drie formuleringen.
Een vergelijking van de grote modellen staat in ChatGPT vs Claude vs Gemini.
Waarom is een LLM relevant voor jou als marketeer?
Omdat een LLM nu beslist welke merken in het antwoord van je koper terechtkomen.
Van blauwe links naar één antwoord
Steeds meer mensen stellen hun vragen niet meer aan een klassieke zoekmachine.
Ze vragen het aan een AI die met taal antwoordt.
Vroeger streed je om een plek in een lijst blauwe links.
Nu gaat het om de vraag of jouw bedrijf überhaupt genoemd wordt.
Wat het model oppikt
Een LLM bouwt antwoorden op uit patronen in tekst.
En het leunt steeds vaker op bronnen die het op dat moment ophaalt.
Google zegt in zijn uitleg over AI-functies in Search dat AI Overviews en AI Mode meerdere verwante zoekopdrachten kunnen uitvoeren om een antwoord op te bouwen.
Een pagina kan daarin als ondersteunende link verschijnen als ze geïndexeerd is en met een snippet in Search mag staan. Speciale AI-optimalisaties zijn volgens Google niet nodig.
Onze ervaring: één ChatGPT-vraag wordt vaak opgesplitst in veel zoekvarianten. Sta je in de top drie op die varianten, dan stijgt je kans om geciteerd te worden. Meer in query fan-out.
Wat dat vraagt van je content
Content die helder, consistent en goed gestructureerd is, valt voor zo’n model makkelijker te begrijpen en te hergebruiken.
Content die dun, vaag of tegenstrijdig is, wordt genegeerd. Hoe je het verschil maakt, lees je in content schrijven die AI citeert.
GEO en LLMO
Het optimaliseren van je zichtbaarheid in AI-antwoorden heet GEO. Alles daarover staat in onze complete gids over generative engine optimization.
Content specifiek afstemmen op taalmodellen heet ook wel LLMO. Wat LLMO (large language model optimization) precies inhoudt, lees je apart.
Wil je weten of jij al opduikt? Test het met onze gratis GEO-check of lees hoe je gevonden wordt in ChatGPT.
Wat telt voor B2B
Wij kijken daarbij niet naar ijdele cijfers.
De vraag is: word je genoemd wanneer een potentiële B2B-klant een aankoopvraag stelt aan een AI?
Dat is geen kwestie van trucjes, maar van betrouwbare, vindbare content.
Zo werken we aan vindbaarheid in AI-zoekmachines.
De korte samenvatting
Een LLM is een AI dat getraind is op enorme hoeveelheden tekst.
Het bouwt antwoorden op door het meest waarschijnlijke volgende stukje tekst te voorspellen.
Het begrijpt niets zoals een mens: het rekent met kansen over taal.
Daardoor is het sterk in taalwerk en zwak in harde feiten.
Omdat zulke modellen achter moderne AI-zoekmachines zitten, bepaalt de helderheid van je content of jouw merk in hun antwoorden terechtkomt.
Vraag ons hoe AI jouw merk vandaag beschrijft: we tonen je wat ChatGPT, Gemini en Perplexity over je bedrijf zeggen.
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.