
SEO & GEO
Grounding: hoe AI bepaalt wat waar is (en waarom het je zichtbaarheid bepaalt)

Kopieer voor AI
Grounding is wanneer een AI-model live webbronnen ophaalt om zijn antwoord te onderbouwen.
Zonder grounding antwoordt het model uit zijn eigen geheugen.
Dat verschil bepaalt of jouw content ook maar een kans maakt om genoemd te worden.
Ons oordeel: optimaliseer eerst voor de vragen waarbij een model zeker grondt. Bij geheugen-antwoorden valt er met content weinig te winnen.
Bron 1: parametrische kennis
Een antwoord kan uit twee compleet verschillende bronnen komen. De eerste is parametrische kennis: alles wat het model tijdens zijn training heeft opgeslagen in zijn gewichten.
Vraag “Wat is de hoofdstad van Frankrijk?” en het model hoeft niets op te zoeken.
Het weet het gewoon, want die associatie zit ingebakken.
Bron 2: grounding
De tweede bron is grounding: informatie die het model op het moment zelf van het web ophaalt.
Het zoekt relevante bronnen, haalt er passages uit en verwerkt die in zijn antwoord.
Die kennis komt dus niet uit de training, maar uit wat er nu online staat.
Precies daar ligt jouw kans:
- Parametrische kennis: niets te optimaliseren, want het model weet al wat het weet.
- Grounding: het model selecteert actief uit beschikbare bronnen, en jouw content kan daartussen zitten.
Dat ophalen heet ook wel retrieval, de kern van RAG.
Meet het zelf: check hoe citeerbaar je pagina is met de gratis GEO-check.
Beslist het model zelf of het grondt?
Ja: een model grondt niet altijd, en het kiest zelf wanneer.
Dit verrast veel mensen.
De beslissing valt automatisch en onzichtbaar, voor jij iets ziet.
Google beschrijft het zo voor Gemini: het model analyseert de prompt en bepaalt of zoeken het antwoord kan verbeteren (Google over grounding).
Zelfzekerheid stuurt de beslissing
Die keuze hangt af van hoe zeker het model is van zijn eigen kennis.
- Zelfverzekerd: het antwoordt meteen uit het geheugen.
- Twijfel: het triggert grounding om te verifiëren of aan te vullen.
Zo werkt het bij Gemini en Claude
Google documenteert dit mechanisme openlijk voor de Gemini API.
Bij Grounding with Google Search bepaalt het model zelf of een Google-zoekopdracht het antwoord kan verbeteren. Zo ja, dan schrijft en draait het zelf een of meer zoekopdrachten.
Oudere Gemini-modellen gebruikten daarvoor een aparte retrieval-tool. De huidige beslissen zelf.
Claude doet hetzelfde
Anthropic zegt het zo over Claude: “Claude determines when to search based on the prompt” (documentatie van de web search tool).
Een eenvoudige feitvraag kost volgens Anthropic meestal 1 tot 3 zoekopdrachten. Vergelijkend onderzoek over meerdere bedrijven kan 10 of meer vragen.
Hoe dat bij elk model uitpakt, lees je in hoe Gemini zijn bronnen kiest en hoe Claude zijn bronnen kiest.
Je ziet het niet gebeuren
Er is geen laadbalkje dat zegt “even zoeken”.
De beslissing valt, het ophalen gebeurt wel of niet, en jij krijgt gewoon een vloeiend antwoord.
Je concurreert dus niet alleen om geselecteerd te worden.
Gevolg: je hangt ook af van de vraag óf er überhaupt gezocht wordt.
Wanneer triggert grounding (bijna) altijd?
Bij vragen naar actuele, specifieke of vergelijkende informatie.
Uit praktijk en testen komen duidelijke patronen naar boven.
Sommige vraagtypes zetten retrieval bijna altijd in gang, andere bijna nooit.
Vragen die grounding triggeren
Zes types zetten het model bijna altijd aan het zoeken:
- Recente gebeurtenissen en actuele info. “Wat deden de beurzen vandaag?” Dit kan het model onmogelijk uit training kennen.
- Specialistische en commerciële vragen. “Wat is het beste enterprise-SEO-platform voor bedrijven met meerdere vestigingen?”
- Precieze, veranderlijke feiten. Denk aan actuele inwonersaantallen, rentevoeten en prijzen.
- Vergelijkende en evaluerende vragen. Woorden als “beste”, “top”, “vergeleken met” of “aanbevolen”.
- Lokale en tijdsgebonden info. “Beste restaurants in de buurt” of openingsuren.
- Onbekende entiteiten. Een merk of product dat nauwelijks in de trainingsdata zat.
Bij de commerciële vraag signaleert de specificiteit dat algemene kennis tekortschiet. Bij veranderlijke cijfers vertrouwt het model zijn geheugen niet.
Anthropic bevestigt dat patroon voor Claude.
Het zoekt bij recente gebeurtenissen, actuele prijzen en statistieken, en bij info over organisaties of producten die veranderd kan zijn.
Vragen die meestal uit het geheugen komen
Stabiele feiten blijven zonder zoekopdracht:
- Stabiele feiten: “Wat is fotosynthese?”
- Conceptuele uitleg: “Hoe werkt samengestelde interest?”
- Historische feiten en basisdefinities
Die staan stevig in de trainingsdata. Het model is zelfverzekerd en zoekt niet.
Welke formuleringen ChatGPT wel aan het zoeken zetten, lees je in prompts die ChatGPT search activeren.
De grijze zone
Tussen die twee uitersten ligt een grijze zone. Daar is het gedrag minder voorspelbaar.
Twee voorbeelden:
- “Wat zijn de beste praktijken voor SEO?” Conceptueel, maar het vakgebied evolueert snel.
- “Wie is de CEO van Apple?” Een bekend feit, maar bestuurders wisselen.
Het model kan dan zelfverzekerd uit zijn geheugen antwoorden. Of toch even verifiëren.
Waarom antwoorden zo schommelen, leggen we uit in de probabilistische aard van AI-antwoorden.
Onze aanpak voor de grijze zone
Die grijze zone zorgt voor onzekerheid.
Onze aanpak is daarom tweeledig:
- Vragen die duidelijk grounden: content agressief optimaliseren.
- Grijze zone: op beide fronten werken.
Dat betekent sterke content voor wanneer grounding wél triggert.
En merkbekendheid voor wanneer het niet gebeurt.
Hoe breng je je vragenportfolio in kaart?
Schat per belangrijke vraag de kans op grounding in, en verdeel je inspanning daarop.
Neem de vragen die er voor jouw business toe doen.
Die oefening toont meteen waar contentoptimalisatie de meeste hefboomwerking heeft.
Zo ziet die verdeling eruit:
| Grounding-kans | Voorbeeldvragen | Strategie |
|---|---|---|
| Grondt zeker | ”Beste [categorie] tools 2026”, “[jouw merk] vs [concurrent]”, “reviews van [merk]“ | Content agressief optimaliseren |
| Grondt waarschijnlijk | ”Hoe kies je [categorie]?”, “best practices in [sector]“ | Content optimaliseren |
| Grondt misschien | ”Wat doet [merk]?”, “[categorie] uitgelegd” | Content én merkbekendheid |
| Grondt waarschijnlijk niet | ”Wat is [basisbegrip]?”, “[gekend historisch feit]“ | Aanwezigheid in trainingsdata |
Lees de tabel van boven naar onder
De bovenste 2 rijen zijn je primaire optimalisatiedoelen.
De onderste rij vraagt een ander spel: aanwezig zijn in de trainingsdata in plaats van in ophaalbare content.
Een voorbeeld uit B2B
Stel bijvoorbeeld dat je een Belgische HR-softwareleverancier bent. “Beste HR-software voor KMO’s 2026” grondt zeker. “Wat is een loonstrook?” grondt waarschijnlijk niet.
Hoe je dat hele plaatje aanpakt, lees je in de ultieme GEO-handleiding.
Hoe test je grounding-gedrag?
Stel dezelfde vraag een paar keer en kijk naar de signalen in het antwoord.
Observeren is de directste methode.
Je hebt er geen tool voor nodig.
Tekenen van grounding
Deze signalen wijzen op een opgehaald antwoord:
- bronvermeldingen of links in het antwoord
- heel actuele info en specifieke cijfers met attributie
- een melding dat er gezocht is
- variatie in de aangehaalde bronnen over meerdere antwoorden
In onze eigen test stelden we dezelfde GEO-vraag aan Perplexity. Kijk naar “Onderzocht” bovenaan en de bronlabels bij elke bullet:
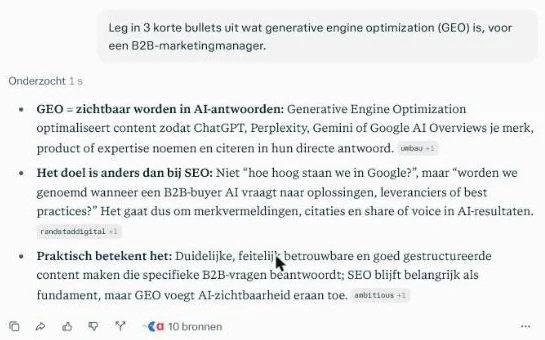 Perplexity met een gratis account, 17 oktober 2026: een bronlabel bij elke bullet en 10 bronnen in totaal.
Dat is grounding in actie: het model zocht eerst en verankerde elke bewering aan een bron.
Tekenen van een geheugen-antwoord
Deze signalen wijzen op parametrische kennis:
- geen bronnen
- algemene conceptuele uitleg
- stabiele antwoorden bij herhaling
- een zelfverzekerde toon zonder slag om de arm over actualiteit
Dezelfde soort vraag in ChatGPT gratis gaf een heel ander beeld:
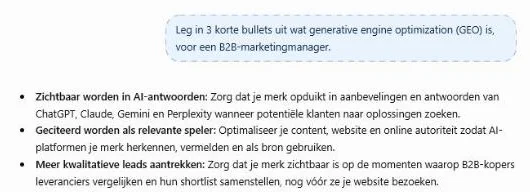 ChatGPT gratis (tijdelijke chat), 17 oktober 2026: drie bullets, ongeveer 70 woorden, geen bronnen.
Geen enkele bron dus. Daar had jouw pagina geen kans om geciteerd te worden.
Varieer de formulering
Slimmer wordt het als je randgevallen aftast. Kleine versheidssignalen kantelen de beslissing vaak:
- “SEO best practices” (grondt misschien niet)
- “SEO best practices 2026” (grondt waarschijnlijk)
- “Huidige SEO best practices” (grondt waarschijnlijk)
- “Nieuwste SEO-strategieën” (grondt vrijwel zeker)
Een handmatig logboek volstaat, zoals in AI-zichtbaarheid meten zonder dure tools.
Tip: noteer per vraag of er bronnen verschijnen.
Welke kwaliteitssignalen wegen bij grounding?
Grounding geeft je alleen een kans; zes kwaliteitssignalen beslissen of je effectief geciteerd wordt.
Na het ophalen weegt het model je content af.
Pas daarna neemt het je op in het antwoord.
De zes signalen
Dit zijn de belangrijkste:
- Autoriteit. Domeinreputatie, herkenbare auteursexpertise en verwijzingen van betrouwbare bronnen.
- Versheid. Voor tijdsgevoelige vragen wint recente content.
- Relevantie. Hoe direct beantwoordt je content de vraag?
- Volledigheid. Grondige bronnen verslaan dunne fragmenten.
- Consistentie. Spreek je andere opgehaalde bronnen tegen, dan kan dat afgestraft worden als uitschieter.
- Extraheerbaarheid. Heldere, goed gestructureerde uitspraken zijn makkelijker te plukken dan dichte lappen tekst.
Een artikel uit 2024 over “best practices” verliest het zo van eenzelfde stuk uit 2026.
En zijdelings gerelateerde tekst scoort lager dan een direct antwoord.
Autoriteit bouw je niet in één pagina op. Lees daarvoor wat E-E-A-T is en waarom merkvermeldingen zwaarder wegen dan backlinks.
Van vraag tot vermelding
Het helpt om die hele route als één trechter te zien.
Na elke stap valt er iets af, tot enkel de bronnen overblijven die alles goed doen:
Ook opgehaalde bronnen halen niet altijd het antwoord. De documentatie van xAI zegt het letterlijk:
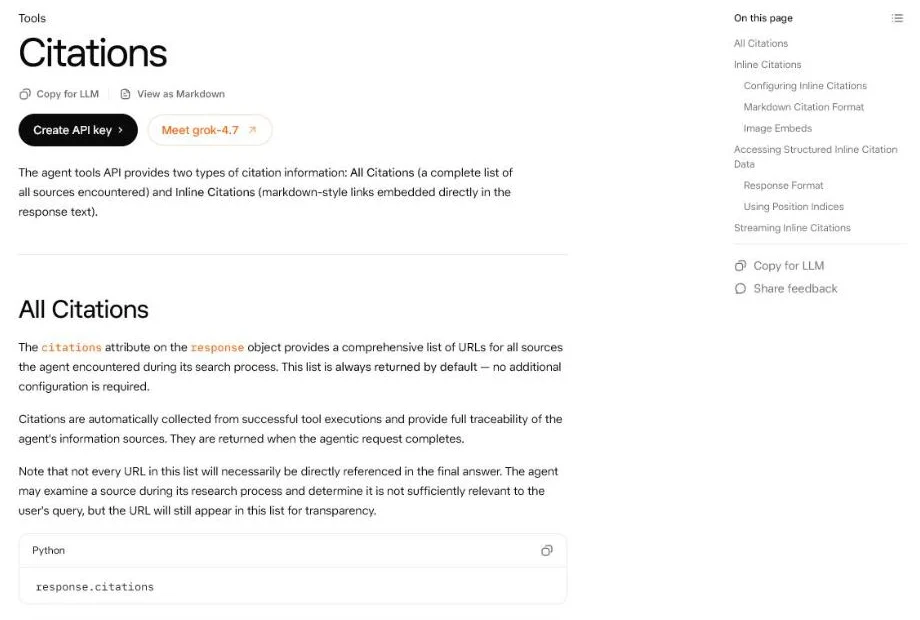 De developer docs van xAI over citations, oktober 2026. Een bron kan bekeken en daarna geschrapt worden als niet relevant genoeg.
Stap 3 en stap 5 zijn dus niet hetzelfde. Opgehaald worden is nog geen vermelding.
Versheid werkt op meerdere niveaus
Versheid verdient extra aandacht, omdat ze vaak onderschat wordt.
Het signaal zit in:
- de publicatiedatum en een “laatst bijgewerkt”-datum
- inhoudelijke markers, zoals “in 2026” of een recente lancering
- soms zelfs datums in de URL
Ook de tools zelf kijken ernaar. Elk zoekresultaat dat Claude terugkrijgt, bevat een veld page_age: wanneer de site het laatst bijgewerkt is.
De les: ververs belangrijke content regelmatig, niet pas wanneer ze fout is.
Twee verdiepingen:
- hoe vaak je verversen moet: content freshness voor AI
- welke passages het model plukt: grounding snippets
Schrijf passages die los kunnen staan
Extraheerbaarheid is het signaal dat je het snelst verbetert.
Zet het antwoord in de eerste zin onder elke kop, en houd paragrafen kort.
Gebruik tabellen voor vergelijkingen, zoals in content chunking voor AI-zoekmachines.
Is grounding een vertrouwenssysteem en een slotgracht?
Ja: grounding beperkt fouten van het model, en vaste bronnen bouwen er een duurzame voorsprong mee op.
Grounding als vertrouwenssysteem
Taalmodellen zijn van nature onzeker.
Ze klinken vlot en overtuigend, en zitten toch soms volledig fout.
Ze hallucineren en mengen feiten verkeerd. Wat dat voor je merk betekent, lees je in wat een AI-hallucinatie is.
Grounding is in essentie een vertrouwenssysteem. Google noemt zelf drie voordelen (Google AI Studio):
- minder hallucinaties, door antwoorden te baseren op echte informatie
- antwoorden over recente gebeurtenissen
- meer vertrouwen, doordat het model zijn bronnen toont
Door antwoorden te verankeren aan opgehaalde bronnen, leunt het model minder op zijn mogelijk gebrekkige geheugen.
Opgehaald én vertrouwd worden
Voor jou betekent dat: je wil niet alleen opgehaald worden.
Je wil ook vertrouwd worden zodra dat gebeurt.
Signalen die zeggen “deze bron is betrouwbaar” wegen even zwaar als signalen die zeggen “deze bron is relevant”.
Grounding als slotgracht
Daar zit ook een verdedigbaar voordeel in.
Voor vragen die consequent naar een kleine set bronnen gronden, bouwen die bronnen een duurzame voorsprong op:
- het model leert hun betrouwbaarheid
- gebruikers verwachten ze
- het merk raakt verweven met het onderwerp
Word jij zo’n vaste grounding-bron, dan kan een concurrent je niet zomaar “boven jou ranken”.
Hij moet je uit dat aangeleerde vertrouwen verdringen.
Dat is een ander soort slotgracht dan de klassieke SEO-moat van links en volledige content.
Voor de bredere verschuiving lees je het stuk over GEO vs SEO.
Veelgestelde vragen
Wat is grounding bij AI precies?
Grounding is het proces waarbij een AI-model live externe bronnen ophaalt en verwerkt om zijn antwoord te onderbouwen, in plaats van enkel te putten uit de kennis die tijdens de training in zijn gewichten is opgeslagen. Het model zoekt relevante documenten, haalt er passages uit en verweeft die in het antwoord. Alleen bij grounding maakt jouw content nog een kans om geciteerd te worden.
Hoe weet ik of ChatGPT of Gemini mijn vraag groundt?
Let op de signalen in het antwoord. Bronvermeldingen of links, heel recente cijfers met attributie, een expliciete melding dat er gezocht is en variatie in de aangehaalde bronnen wijzen op grounding. Komt het antwoord zonder bronnen, blijft het algemeen en is het stabiel als je het herhaalt, dan put het model waarschijnlijk uit zijn geheugen. Veel platformen tonen intussen ook brontegels of een zoek-indicator wanneer er gegrond werd.
Waarom grondt een model niet bij elke vraag?
Omdat grounding tijd en rekenkracht kost. Zoeken en ophalen voegen merkbare vertraging toe, dus modellen zoeken alleen wanneer dat het antwoord waarschijnlijk verbetert. Volgens Google bepaalt het model eerst of een zoekopdracht het antwoord kan verbeteren. Zoeken kost ook geld: Anthropic rekent voor zijn web search tool USD 10 per 1.000 zoekopdrachten, bovenop de tokenkosten (gecontroleerd 4 november 2026). Dat oordeel hangt bovendien af van de context, dus dezelfde vraag kan in de ene situatie wel en in de andere niet grounden.
Hoe word ik zichtbaar in gegronde antwoorden?
Richt je op de vragen die betrouwbaar grounden in jouw domein (vergelijkende, recente en specifieke vragen) en zorg dat je content scoort op de kwaliteitssignalen: autoriteit, versheid, relevantie, volledigheid en extraheerbaarheid. Houd belangrijke pagina’s actueel met expliciete versheidsmarkers, structureer je tekst zodat heldere passages makkelijk te plukken zijn, en bouw vertrouwenssignalen op zoals verwijzingen van andere gezaghebbende bronnen. Wie zo consequent opduikt, bouwt een voorsprong die blijft, ook als individuele artikels verouderen.
Hulp nodig met grounding?
Begin bij de vragen die zeker grounden, en meet waar je vandaag wel en niet geciteerd wordt.
Wil je dit vertalen naar uitvoering? Bekijk hoe we dit aanpakken met AI-vindbaarheid.
100 GEO-tips om genoemd te worden in ChatGPT en Google AI
- 10 hoofdstukken:van robots.txt en Bing tot meten
- Copy-paste:regex voor Search Console en GA4
- Sjablonen:koopvragen per fase en een 30-dagenplan
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.