
SEO & GEO
Primary bias: waarom AI-modellen sommige merken standaard vertrouwen

Kopieer voor AI
Primary bias is het vertrouwen dat een AI-model al in je merk heeft.
Het bestaat nog voor het model iets opzoekt, en het bepaalt of je merk standaard genoemd wordt.
Het verdict: primary bias is het onderbuikgevoel van de AI, en je bouwt het alleen op via vermeldingen in gezaghebbende bronnen, over jaren.
Stel twee vragen aan ChatGPT: “Welk CRM kies ik voor mijn enterprise?” en “Welke leverancier neem ik voor klantenfeedback in de Benelux?”
Bij de eerste rolt er meteen een rijtje namen uit, vol vertrouwen, zonder dat het model iets opzoekt.
Bij de tweede aarzelt het. Of het noemt namen die niets met jou te maken hebben.
Dat verschil heeft een naam: primary bias. Hieronder leg ik uit hoe die voorkeur ontstaat, waarom ze je AI-zichtbaarheid stuurt, en hoe je ze meet en opbouwt.
Check je eigen pagina: krijg een GEO-score met concrete tips via onze gratis GEO-check.
Wat is primary bias precies?
Het inherente vertrouwen van een model in een entiteit, nog voor er enige retrieval of grounding plaatsvindt.
Noem het het “onderbuikgevoel” van de AI: een wereldbeeld dat vastligt in de trainingsdata.
Komt een model jouw merknaam tegen, dan begint het niet bij nul. Het vertrekt vanuit de associaties die zijn trainingsdata hebben gevormd.
De vier soorten associatie
Die associaties vallen grofweg in vier categorieën:
- Sterk en accuraat: bekende merken met een heldere positionering.
- Sterk en onjuist: merken die met de verkeerde categorie worden geassocieerd.
- Zwak: merken die nauwelijks in de trainingsdata voorkomen.
- Afwezig: merken die het model nog nooit is tegengekomen.
Wat primary bias bepaalt
Primary bias werkt vooraf, los van het selectieproces dat speelt wanneer een model wel live zoekt.
Het bepaalt vier dingen:
- of het model geneigd is je merk überhaupt te noemen
- welke eigenschappen het aan je koppelt
- hoe stellig het over je praat
- of je naam opkomt bij relevante vragen
Het is letterlijk een vooroordeel: een voor-oordeel op basis van patroonherkenning in historische data.
Wat een taalmodel daarbij precies doet, lees je in wat een LLM is voor marketeers.
Hoe ontstaat primary bias in de trainingsdata?
Door herhaalde associaties: komt je merk vaak naast een concept voor, dan leert het model die koppeling.
Taalmodellen trainen op gigantische hoeveelheden tekst: webpagina’s, boeken, artikels, forums en documentatie.
Een groot deel van het open web komt uit Common Crawl. Dat corpus telt “over 300 billion pages spanning 15 years”, met 3 tot 5 miljard nieuwe pagina’s per maand (Common Crawl).
Welke pagina’s daarin echt meetellen, lees je in de rol van Common Crawl in je ChatGPT-zichtbaarheid.
Voorbeeld: een gevestigde naam
Neem Salesforce. De trainingsdata bevatten duizenden artikels over Salesforce als CRM.
Daarbij komen documentatie, tutorials, nieuwsberichten, forumdiscussies en vergelijkingen met concurrenten.
Daaruit leert het model sterke associaties: Salesforce gelijk aan CRM, aan enterprise, aan cloud computing.
Vraag je dan “Welk CRM kies ik voor enterprise?”, dan neigt het model naar Salesforce nog voor het iets opzoekt. Die voorkeur zit ingebakken.
Voorbeeld: een nieuwkomer
Een nieuwer bedrijf in dezelfde markt staat er anders voor. Misschien heeft het uitstekende producten en sterke actuele content.
Maar is het gelanceerd na de trainingscutoff, of werd het weinig besproken in het corpus? Dan is zijn primary bias zwak of afwezig.
Het model heeft geen neiging naar hem toe. Elke vermelding moet hij verdienen via grounding.
Wat is het verschil tussen primary bias en grounded knowledge?
Primary bias zit in de gewichten van het model, grounded knowledge wordt live opgehaald.
Het onderscheid is cruciaal voor je strategie. Het zijn twee verschillende krachten.
| Kenmerk | Primary bias (parametrisch) | Grounded knowledge (opgehaald) |
|---|---|---|
| Ontstaat | tijdens de training | in real time via een zoekactie |
| Verandert | pas bij hertraining | mee met je webcontent |
| Geldt voor | alle vragen rond je merk | alleen als grounding start |
| Bij te sturen met content | niet rechtstreeks | wel rechtstreeks |
| Zichtbaarheid | basis, los van je content | hangt af van je contentkwaliteit |
Hoe de grounding-kant werkt, lees je in grounding: hoe AI bepaalt wat waar is.
Twee soorten antwoorden
Je ziet het verschil soms aan het antwoord zelf. Kijk naar dit ChatGPT-antwoord: er staan geen bronnen bij.
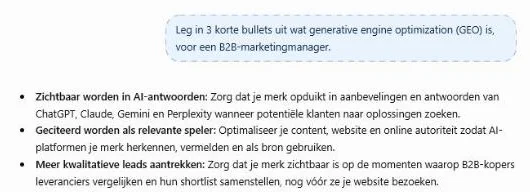 Antwoord van ChatGPT op onze GEO-vraag, oktober 2026. Geen bronnen onder het antwoord.
Zo’n antwoord zonder bronnen leunt vooral op wat het model al weet.
Vergelijk het met Perplexity, dat zijn bronnen wel toont:
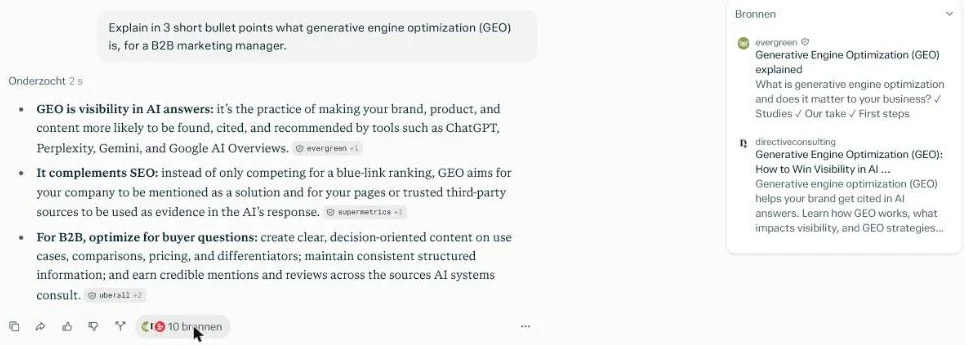 De 10 bronnen achter het antwoord van Perplexity, één klik vanaf de voettekst, oktober 2026.
Hier speelt grounding mee. Wanneer een model wel gaat zoeken, lees je in prompts die ChatGPT Search activeren.
Wanneer telt welke kracht?
Triggert een vraag een zoekactie, dan spelen beide samen. Primary bias zet een initiële neiging, grounding versterkt of corrigeert die.
Triggert een vraag geen zoekactie, dan telt alleen primary bias. Het model antwoordt vanuit zijn gewichten, niet vanuit jouw laatste blogpost.
Vier strategische posities
Combineer je beide krachten, dan krijg je vier posities:
| Primary bias | Content | Positie |
|---|---|---|
| Sterk | Sterk | Dominant, moeilijk te verdringen |
| Sterk | Zwak | Kwetsbaar, grounding kan concurrenten bevoordelen |
| Zwak | Sterk | Kans, content moet harder werken |
| Zwak | Zwak | Onzichtbaar, fundamentele herpositionering nodig |
Het volledige speelveld van generative engine optimization (GEO) behandel ik in de ultieme GEO-handleiding.
Hoe meet je primary bias?
Met gerichte tests zonder grounding, herhaald over meerdere modellen.
Primary bias is niet rechtstreeks zichtbaar. Drie aanpakken werken goed.
Completietesten
Geef het model prompts zonder grounding en kijk wat het genereert. Bijvoorbeeld:
- “Wanneer bedrijven klantenfeedback willen verzamelen, kiezen ze vaak voor…”
- “De leidende aanbieders in deze markt zijn…”
Draai zo’n prompt vele keren om sampling-variatie op te vangen. Tel hoe vaak welke merken opduiken.
Vuistregel: hoe vaker je merk ongevraagd verschijnt, hoe sterker je primary bias.
Stel: je draait dezelfde prompt 20 keer in een nieuw gesprek en noteert elke keer de genoemde merken.
Je merk verschijnt in 4 van de 20 antwoorden, een concurrent in 15.
Dan weet je waar je staat: die concurrent heeft de sterkere ingebakken voorkeur.
Herhaal dezelfde test na 3 maanden. Pas over meerdere metingen zie je of er iets verschuift.
Let op: schakel webzoeken uit waar het platform dat toelaat. Anders meet je grounding in plaats van primary bias.
Associatietesten
Test wat het model met je merk verbindt:
- “[Jouw merk] staat bekend om…”
- “Bedrijven gebruiken [jouw merk] wanneer ze…”
- “[Jouw merk] vergeleken met concurrenten is…”
De aanvullingen tonen welke associaties in de gewichten zitten.
Die kunnen accuraat, verouderd, onvolledig of fout zijn. Maar het is wel wat het model “gelooft” over jou. Ook de toon telt; zie sentiment in AI-merkvermeldingen meten.
Bidirectioneel testen
Test de associatie in beide richtingen:
- Voorwaarts: “Beste oplossingen voor [categorie]”. Verschijnt je merk?
- Achterwaarts: “[Jouw merk]”. Welke categorie koppelt het model eraan?
Sterke primary bias toont zich in beide richtingen.
Bij zwakke bias kent het model je merk misschien wel, maar legt het de link met de relevante categorie niet.
Meet over meerdere platformen
Google, OpenAI en Anthropic trainen op verschillende data. Je primary bias kan sterk zijn op het ene model en zwak op het andere.
Hoe de modellen verschillen, lees je in ChatGPT vs Claude vs Gemini. Een vaste set prompts bouw je met onze gids over een promptset samenstellen.
Deze meetlogica sluit aan bij hoe je brand salience meet voor AI. Je kijkt of, hoe vaak en in welke context een model je merk spontaan oproept.
Zonder betaalde tool begin je met AI-zichtbaarheid meten zonder tools.
Wat is het voordeel, en de keerzijde, van sterke primary bias?
Sterke bias geeft een structurele voorsprong, maar kan verouderde kennis vastzetten.
Drie voordelen
Merken met een sterke, accurate primary bias genieten:
- Basiszichtbaarheid: ook met middelmatige content blijft het model geneigd hen te noemen.
- Selectievoorkeur: bij grounding wordt hun content gunstiger beoordeeld, een vorm van confirmation bias.
- Compound-effect: genoemd worden levert meer content op, wat de volgende trainingsdata versterkt.
Dat compound-effect is een zichzelf versterkende lus. Hoe zichtbaarder een merk vandaag is, hoe sterker zijn positie in de volgende trainingsronde.
En hoe moeilijker het voor nieuwkomers wordt om ertussen te komen:
Zwakke bias: elke vraag vanaf nul
Zwakke of afwezige primary bias creëert het omgekeerde. Je voelt tegenwind bij de selectie.
Je zichtbaarheid hangt dan volledig af van of grounding getriggerd wordt.
Word je toch genoemd, dan vaak met twijfel: “Ik vond een bedrijf dat…” in plaats van een stellige vermelding. Die onzekerheid vertaalt zich naar perceptie bij de gebruiker.
De paradox: te sterke bias
Heel sterke primary bias kan tegen je werken.
Is het model zeer overtuigd over een entiteit, dan triggert het minder snel een zoekactie. Het “weet” het antwoord al.
Gevolg: je geoptimaliseerde actuele content wordt niet opgehaald. Het model antwoordt vanuit mogelijk verouderde trainingskennis.
Voor bekende merken is dat een uitdaging: hoe corrigeer je een verouderd beeld?
Twee dingen helpen: tijdsgebonden formuleringen die grounding forceren, en content die het oude beeld expliciet tegenspreekt.
Hoe bouw je primary bias op?
Via vermeldingen in gezaghebbende bronnen, en met geduld: het is een lang spel.
Als primary bias in de trainingsdata zit, kun je ze dan beïnvloeden? Ja, langs vier wegen.
1. Aanwezigheid in trainingsbronnen
Modellen trainen op gezaghebbende, vaak gecrawlde bronnen. Denk aan Wikipedia, gevestigde nieuwsmedia, vakpublicaties, academisch werk en populaire forums.
Genoemd worden in die bronnen, niet alleen op je eigen site, bouwt aanwezigheid in toekomstige trainingsdata op.
Of een Wikipedia-pagina voor jouw bedrijf haalbaar is, lees je in een Wikipedia-pagina voor een B2B-bedrijf.
2. Consistente entiteitsassociatie
Associaties ontstaan door herhaling. Word je consequent naast je doelconcepten genoemd, dan versterkt die koppeling.
Verspreide, inconsistente boodschappen creëren net verwarde associaties; zie entiteitsconsistentie.
3. Autoriteitssignalen
Niet alle trainingsdata weegt even zwaar. Een vermelding in een groot medium telt waarschijnlijk meer mee dan tientallen vermeldingen op obscure blogs.
Kwaliteit naast kwantiteit. Hoe je die vermeldingen verdient, lees je in digital PR voor AI-citaties.
Onze ervaring: voor AI zijn backlinks vooral een vertrouwenssignaal. De vraag is of anderen je beschrijven zoals jij jezelf beschrijft.
4. Tijdshorizon
Primary bias verandert pas bij hertraining. Bij grote commerciële modellen gebeurt dat periodiek, met maanden tot jaren ertussen.
Denk dus in jaren, niet in maanden. Bouw nu aan aanwezigheid voor de volgende trainingsrondes.
Earned media voedt je bias
Daarom leg ik in merkvermeldingen verslaan backlinks zo sterk de nadruk op earned media.
Het zijn precies de vermeldingen in gezaghebbende bronnen die je primary bias op termijn voeden.
Verwaarloos intussen je grounded zichtbaarheid niet. Optimaliseer je content voor de korte termijn terwijl je aan de lange termijn bouwt.
Veelgestelde vragen
Wat is het verschil tussen primary bias en grounding?
Primary bias is de vaste, ingebakken kennis van een model over je merk, gevormd tijdens de training. Grounding is de live zoekactie waarmee een model actuele informatie ophaalt op het moment van de vraag: Google omschrijft grounding with Google Search als het verbinden van het model met realtime webcontent, zodat het verder kan kijken dan zijn knowledge cutoff. Primary bias geldt altijd, ook zonder zoekactie; grounding speelt alleen wanneer het model effectief gaat zoeken. Voor je strategie tellen ze allebei, maar je beïnvloedt ze op verschillende manieren.
Kan een klein of nieuw merk überhaupt primary bias opbouwen?
Ja, maar het kost tijd en gebeurt niet via je eigen website. Je bouwt het op door vermeld te worden in gezaghebbende externe bronnen die meetellen in toekomstige trainingsrondes: vakmedia, persaandacht, Wikipedia, expert-roundups. Omdat modellen maar periodiek hertraind worden, zie je geen direct resultaat. Intussen win je zichtbaarheid via sterke, grounded content die de selectie wint ondanks de tegenwind.
Hoe weet ik of mijn primary bias accuraat of fout is?
Doe associatietesten: vraag het model waar je merk voor bekend staat en wanneer bedrijven je inschakelen. Vergelijk de antwoorden met je eigen positionering. Klopt het beeld, dan moet je het vooral versterken. Associeert het model je met de verkeerde categorie of met verouderde informatie, dan heb je een correctiestrategie nodig, en dat is lastiger dan vanaf nul beginnen, want het model moet eerst afleren.
Verschilt mijn primary bias per AI-platform?
Ja. ChatGPT, Gemini en Claude trainen op verschillende data, met verschillende cutoffdatums en bronweging: Anthropic publiceert bijvoorbeeld per Claude-model een eigen training data cutoff, die van model tot model verschilt. Je kunt sterk scoren op het ene model en zwak op het andere. Daarom meet je je positie altijd over meerdere platformen heen, en stem je je strategie per platform af: leun op je sterke kanten waar je al een voorsprong hebt, en zet in op grounded zichtbaarheid waar je achterloopt.
Hulp nodig?
Primary bias bouw je over jaren, grounded zichtbaarheid win je per pagina.
Wil je dit vertalen naar uitvoering? Bekijk hoe we dit aanpakken met AI-vindbaarheid.
100 GEO-tips om genoemd te worden in ChatGPT en Google AI
- 10 hoofdstukken:van robots.txt en Bing tot meten
- Copy-paste:regex voor Search Console en GA4
- Sjablonen:koopvragen per fase en een 30-dagenplan
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.