
SEO & GEO
Hoe de nieuwe AI-zoekarchitectuur werkt (retrieval, generatie en RAG)

Kopieer voor AI
AI-zoeken haalt eerst bronnen op en schrijft daarna pas een antwoord.
Die AI-zoekarchitectuur heet retrieval plus generatie, of RAG. Ze zit achter AI Overviews, AI Mode en ChatGPT met zoekfunctie.
Het verdict: je content wordt niet “gerankt” maar opgehaald, gefilterd, in stukken geknipt en geselecteerd. Wie elke alinea zelfstandig leesbaar maakt, maakt de meeste kans.
Als je een vraag stelt aan AI Overviews of ChatGPT, voelt het antwoord ogenblikkelijk.
Maar onder de motorkap gebeurt iets dat fundamenteel verschilt van klassieke zoekmachines.
Dit is de technische basis onder de ultieme GEO-handleiding, waarbij GEO staat voor generative engine optimization.
Direct toepassen: laat onze GEO-check zien welke AI-signalen je pagina mist.
Waarom bestaat AI-zoeken? Het hallucinatieprobleem
Omdat een taalmodel alleen kent wat in zijn trainingsdata zat.
Grote taalmodellen (LLM’s) zijn getraind op enorme hoeveelheden tekst.
Ze leren patronen en verbanden, waardoor ze vlot klinkende antwoorden genereren.
Wat een LLM voor marketeers betekent, leggen we apart uit.
Een model weet niet wat het niet weet
Daar zit meteen de beperking.
Een model heeft geen betrouwbare manier om te weten of het iets écht weet of iets aannemelijks verzint.
Dat is het hallucinatieprobleem. Vraag een model naar een gebeurtenis na zijn trainingsdatum, en het verzint mogelijk een geloofwaardig maar fictief antwoord.
De vloeiende stijl zegt niets over de juistheid.
De oplossing: grounding
Voor creatief schrijven is dat beheersbaar. Voor zoeken, waar mensen accurate en actuele informatie verwachten, is het onaanvaardbaar.
De oplossing heet grounding. Het model vult zijn parametrische kennis (wat in de gewichten zit) aan met opgehaalde kennis (wat in realtime uit externe bronnen komt).
Een gegrond antwoord zegt eigenlijk: “Ik heb dit net gevonden, bij deze bronnen, en ik vat het voor je samen.”
Van taalmodel naar research-assistent
Grounding maakt van een taalmodel iets dat lijkt op een research-assistent. Het kan:
- actuele info raadplegen
- bronnen citeren
- toegeven dat het iets niet weet
Dit is de architectuur achter AI Overviews en elke serieuze AI-zoekimplementatie. Dieper ingaan op dit mechanisme? Lees ons artikel over grounding.
Waar RAG in het plaatje past
De bredere techniek waarin opgehaalde kennis en generatie samenkomen, heet RAG.
Google stelt RAG gelijk aan grounding en zet het in om de kwaliteit, accuraatheid en versheid van AI-antwoorden te verbeteren.
Wat RAG (retrieval-augmented generation) voor marketeers betekent, leggen we apart uit.
Hoe werkt query fan-out: hoe googelt AI zichzelf?
AI-zoeken zoekt bij een complexe vraag niet één keer, maar vele keren.
Bij klassiek zoeken matcht je exacte zoekopdracht tegen een index. Eén zoekopdracht, één zoekactie, één resultatenset.
Eén vraag wordt vijf deelvragen
Neem deze vraag: “Wat zijn de beste strategieën om zichtbaarheid in AI-zoeken te verbeteren voor e-commerce merken?”
Een AI-systeem herkent dat die vraag meerdere dimensies heeft. Het breekt ze op in deelvragen, bijvoorbeeld:
- Wat is AI-zoeken?
- Hoe verschilt AI-zoeken van klassiek zoeken?
- Welke uitdagingen hebben e-commerce merken specifiek?
- Welke optimalisatiestrategieën bestaan er voor AI-zichtbaarheid?
- Welke voorbeelden of cases tonen succes aan?
Wat er daarna gebeurt
Het model voert die deelvragen uit, soms na elkaar en soms parallel, tegen een zoekinfrastructuur.
Elke deelvraag levert eigen resultaten op. Daarna synthetiseert het model alles tot één antwoord.
Dit heet query fan-out: de vraag “waaiert uit” naar meerdere zoekacties. Google omschrijft het zelf als je vraag opsplitsen in subthema’s en tegelijk een reeks zoekopdrachten uitsturen.
Ook Google’s documentatie over AI-functies zegt dat AI Overviews en AI Mode deze techniek kunnen gebruiken om een bredere set ondersteunende links te tonen.
Waarom dit je optimalisatie verandert
De impact is groot. Vroeger optimaliseerde je voor specifieke keyword-zoekopdrachten.
Nu kan jouw content opgehaald worden voor vragen die je nooit had voorzien.
Je pagina over “conversieoptimalisatie in webshops” kan opduiken in een antwoord over “AI-zichtbaarheidsstrategieën”.
Het model legde gewoon een relevant verband.
Vuistregel: het optimalisatie-oppervlak is veel breder dan je zoekwoordenlijst. Hoe je deelvragen per intentie ordent, lees je in query fan-out en intentieclassificatie.
Hoe werkt de retrieval-pijplijn van duizenden URL’s naar één antwoord?
Als een trechter met vier fasen die elk de kandidaten verder terugsnoeit.
Van duizenden URL’s die relevant kunnen zijn, blijft een handvol passages over. Die vormen uiteindelijk het antwoord.
Google documenteert de interne lagen niet. Zie deze vier fases dus als een werkmodel, geen specificatie.
Fase 1: snelle retrieval
De deelvragen raken een zoekinfrastructuur. Denk aan een eerste veeg: verzamel alles wat relevant kan zijn, kwaliteit komt later.
Bij Google moet een pagina geïndexeerd zijn en met een snippet getoond mogen worden om als ondersteunende link te dienen.
Deze fase levert mogelijk duizenden kandidaat-URL’s op, veel meer dan ooit gebruikt kan worden.
Dat ChatGPT daarbij ook op zoekindexen leunt, lees je in ChatGPT gebruikt de Google-index.
Fase 2: filteren
Een classifier beoordeelt die kandidaten en filtert ze tot een hanteerbare set. Dat gebeurt op basis van:
- relevantie
- autoriteit
- versheid
- andere kwaliteitssignalen
Maar het is geen klassieke ranking. Het is eerder triage: bepalen welke kandidaten een diepere blik verdienen.
Waarom fase 2 wordt onderschat
Pagina’s die goed scoren in klassiek zoeken, vallen hier soms af. Ze halen de kwaliteitsdrempel voor grounding niet.
Omgekeerd halen pagina’s die in klassiek zoeken laag staan de filter wél, omdat hun content goed gestructureerd is voor extractie.
De filtercriteria zijn dus niet identiek aan rankingcriteria.
Daarom vertelt klassieke rank tracking maar een halve waarheid over je AI-zichtbaarheid.
Fase 3: content extractie
Voor de pagina’s die de filter overleven, haalt het systeem de inhoud op en knipt het relevante passages eruit.
Hier wordt je zorgvuldig ontworpen pagina herleid tot tekstblokken (chunks).
Hoe je je content daarop voorbereidt, staat in content chunking voor AI-zoekmachines.
Wat het model in fase 3 mist
Het model ziet je pagina niet zoals een bezoeker. Geen hero-afbeelding, geen merkkleuren, geen navigatie.
Het krijgt iets dat dichter bij ruwe tekst ligt, soms met basis-HTML-structuur zoals headers en vetgedrukte tekst.
Maar in essentie gewoon woorden.
Hangt je betekenis af van visuele context, zoals een infographic zonder alt-tekst?
Dan vangt het model die betekenis niet op.
Fase 4: selectie en synthese
Tot slot beoordeelt het model de geëxtraheerde passages tegen de oorspronkelijke vraag.
Het kiest welke het opneemt in het antwoord.
Dat is het selectiemoment: wordt jouw content deel van het antwoord, of blijft ze ongebruikt?
Selectie is niet binair
Het model heeft meerdere opties met je passage:
- je uitgebreid citeren als hoofdbron
- één zin overnemen, vermengd met vijf andere bronnen
- je passage ophalen en toch voor een alternatief kiezen
Zo wordt selectiegraad meetbaar: hoe vaak wordt je content, eens opgehaald, ook echt geselecteerd?
Ophalen is nog geen citeren
Ook xAI zegt het in zijn ontwikkelaarsdocumentatie. Kijk naar de zin over “All Citations”:
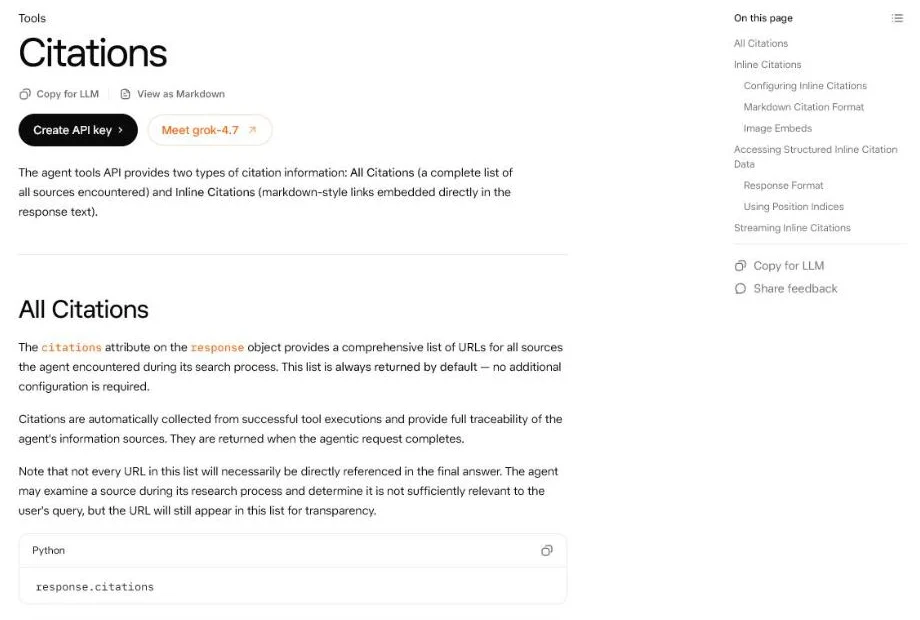 De documentatie van xAI over citaties (Engelse interface), oktober 2026. Een bekeken bron kan alsnog afvallen als niet relevant genoeg.
Een bekeken URL is dus nog geen geciteerde URL. Dat is precies het verschil tussen fase 1 en fase 4.
Wat ziet het model echt van je pagina?
Tekst, geen screenshot.
Dit punt wordt vaak verkeerd begrepen, en dat leidt tot foute optimalisatie.
Veel mensen denken dat AI een soort screenshot van je pagina maakt.
Dat klopt niet. Het model ziet tekst, specifiek tekst die door de pijplijn is gehaald en van visuele opmaak is ontdaan.
Wat overleeft en wat niet
Zo ziet de verdeling eruit:
| Element | Overleeft extractie? |
|---|---|
| Lopende tekst | Ja |
Koppen (<h2>) en vetgedrukte tekst | In sommige implementaties |
| Lijsten | In sommige implementaties |
| Fonts, kleuren, spacing | Nee |
| Afbeeldingen zonder alt-tekst | Nee |
| Schema-markup | Grijze zone |
De grijze zone van schema
Schema-markup en gestructureerde data zitten in een grijze zone.
Google zegt dat er geen speciale schema.org-markup nodig is voor AI Overviews of AI Mode.
Gestructureerde data moet wel overeenkomen met de zichtbare tekst.
Wil je schema-markup toch inzetten, zorg dan dat het zegt wat je tekst zegt.
De praktische les
Inhoudelijke kwaliteit telt meer dan visuele afwerking. Een mooi vormgegeven pagina met middelmatige tekst verliest van een lelijke pagina met uitstekende tekst.
De AI kijkt door de designlaag heen naar de inhoud eronder.
De valkuil van contextuele instorting
Op een goed opgebouwde website bestaat content in context.
Een productpagina vermeldt de productnaam in de header. De bodytekst kan dan voornaamwoorden gebruiken: “Het beschikt over geavanceerde ruisonderdrukking.”
Dat werkt voor een mens die de hele pagina ziet. Het faalt volledig bij AI-extractie.
Waarom de context niet meereist
Wanneer het model een passage uit het midden van je pagina haalt, krijgt het enkel die passage.
Staat er “Het beschikt over geavanceerde ruisonderdrukking”, dan weet het model niet waar “het” naar verwijst.
De context reisde niet mee.
Ik noem dit contextuele instorting.
Zo voorkom je het
De oplossing is content waarin elke sectie en elke alinea op zichzelf staat. Herhaal in elke logische eenheid:
- de entiteitsnaam
- de productnaam
- het expliciete onderwerp
Dat voelt repetitief als je de pagina in zijn geheel leest.
Maar de AI leest nooit het geheel: ze leest losse chunks, en die moeten zelfstandig leesbaar zijn.
Koppen helpen ook. Lees waarom koppen als vragen de AI-extractie helpen, en hoe entiteitsconsistentie je merk herkenbaar houdt.
Hoe werkt multi-bron synthese: van positie naar aandeel?
AI-zoeken combineert stukken uit meerdere bronnen in één antwoord.
Klassiek zoeken gaf je een lijst bronnen. De gebruiker koos welke te bezoeken, en elke bron stond op zichzelf.
Eén alinea, drie bronnen
AI-zoeken synthetiseert over bronnen heen. Eén alinea AI-antwoord kan bijvoorbeeld combineren:
- een statistiek uit bron A
- een uitleg uit bron B
- een voorbeeld uit bron C
Perplexity maakt dat zichtbaar. Klik onder een antwoord op de bronnen en je ziet alle pagina’s die erin verwerkt zijn:
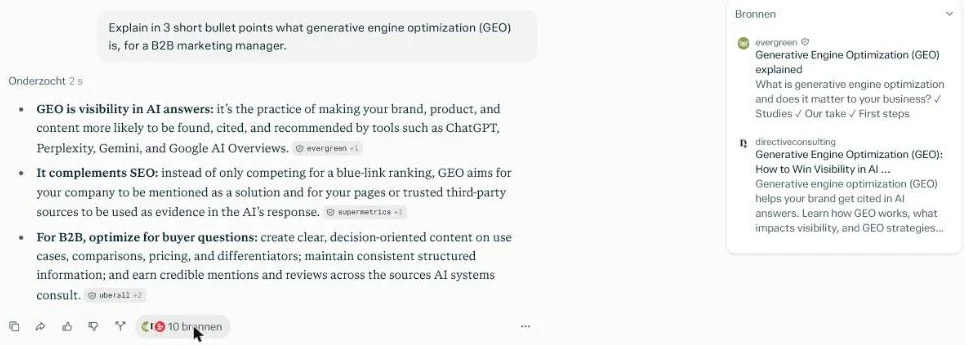 De 10 bronnen achter het antwoord van Perplexity, één klik vanaf de voettekst, oktober 2026.
Tien bronnen voor één antwoord: elke bron levert een stukje, maar niet elke bron evenveel.
Je strijdt om aandeel, niet om positie
Dat creëert een nieuwe concurrentiedynamiek. Vroeger streed je om positie, nu strijd je om aandeel in de synthese.
Stel dat een antwoord vijf bronnen gebruikt. Zo kan het aandeel verdeeld zijn:
De hoofdbron vangt onevenredig veel waarde: merkzichtbaarheid, mogelijke doorklik en autoriteit. De kleine bronnen zijn vrijwel onzichtbaar.
Selectiegraad is niet genoeg
Daarom is selectiegraad alleen een onvolledige maatstaf.
Je wil ook integratiediepte meten: hoe substantieel draagt je content bij wanneer ze geselecteerd wordt?
Hoe je zulke content schrijft, lees je in citatiewaardige content schrijven voor AI.
Platformverschillen
De architectuur verschilt per platform, en dat is relevant voor je strategie:
| Platform | Groundingpatroon | Gevolg voor optimalisatie |
|---|---|---|
| Eén feit, meerdere bronnen die elkaar bevestigen (consensus) | Content wint bij claims die andere autoriteiten ook maken | |
| OpenAI (ChatGPT) | Eén claim, één bron (winner-take-all) | Differentiatie telt: de enige beste bron zijn voor een claim |
Wat dat in de praktijk betekent
Google beloont overeenstemming en goed gestructureerde content met duidelijke hiërarchie.
ChatGPT beloont eerder uitgebreide, onderscheidende content die als primaire bron kan dienen. Zie het in een ChatGPT-antwoord op een CRM-vraag:
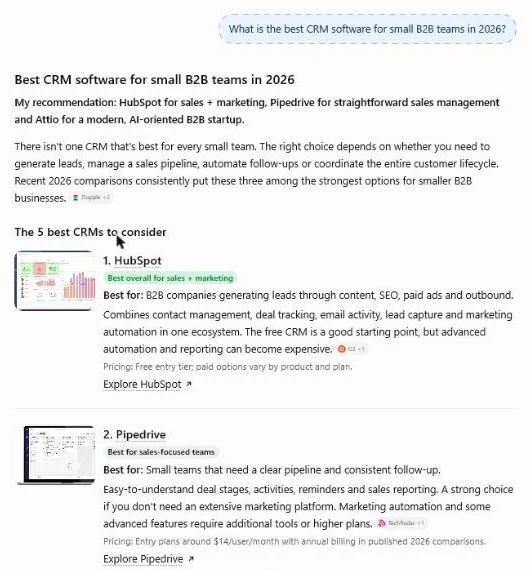 Gratis ChatGPT, Engelse vraag over CRM-software, 17 oktober 2026. Elke aanbeveling leunt op één bronlabel.
“AI-zoeken” is dus niet één ding.
Hoe je per platform zichtbaar wordt, lees je in gevonden worden in Google AI Overviews en gevonden worden in ChatGPT.
Triggert elke vraag retrieval? De groundingbeslissing
Nee: niet elke vraag activeert grounding.
Vraagt een gebruiker iets waar het model zeker van is, zoals basisfeiten of breed verspreide kennis?
Dan antwoordt het mogelijk uit parametrische kennis alleen.
Geen zoekactie, geen retrieval, geen kans voor jouw content om geselecteerd te worden.
Wanneer het model wel gaat zoeken
Vraagt iemand iets waar het model minder zeker over is, zoals recente gebeurtenissen of actuele info? Dan triggert het grounding.
Het zoekt, haalt op en synthetiseert. Die beslissing valt automatisch, op basis van het zelfvertrouwen van het model.
Vragen met hoge en lage grounding
Vragen die meestal grounding triggeren:
- Recente gebeurtenissen en actuele informatie
- Gespecialiseerde of technische onderwerpen
- Vragen om specifieke feiten of cijfers
- Vergelijkende vragen (“beste”, “top”, “aanbevolen”)
- Lokale of tijdgevoelige informatie
Vragen met lage grounding:
- Vastgestelde feiten (“Wat is de hoofdstad van Frankrijk?”)
- Conceptuele uitleg binnen de training van het model
- Algemene kennis die breed in de trainingsdata zit
Wat dat betekent voor je doelvragen
Vallen jouw doelvragen in de lage-groundingcategorie? Dan heeft contentoptimalisatie beperkte impact. Het beïnvloeden van de trainingsdata zelf is dan je enige, veel langzamere pad.
Vallen ze in de hoge-groundingcategorie?
Dan kan optimalisatie meteen effect hebben: elke vraag is een kans om opgehaald en geselecteerd te worden.
Omdat die beslissing per keer kan verschillen, is AI-zoeken inherent grillig.
Meer daarover lees je in mijn artikel over de probabilistische aard van AI-antwoorden.
Wat doe je met deze architectuur per fase?
Per fase van de pijplijn hoort één concrete actie aan jouw kant.
Zo vertaal je het werkmodel naar je contentplan:
| Fase | Wat de AI doet | Wat jij doet |
|---|---|---|
| Retrieval | Haalt kandidaat-URL’s op | Zorg dat je pagina geïndexeerd is en een snippet mag tonen |
| Filteren | Triage op relevantie, autoriteit en versheid | Houd je pagina actueel en onderbouw claims met bronnen |
| Extractie | Knipt de pagina in passages | Maak elke alinea zelfstandig leesbaar |
| Selectie en synthese | Kiest de beste passages | Geef het directe antwoord in de eerste zin onder elke kop |
Een voorbeeld uit de praktijk
Stel: je schrijft een pagina over de kosten van een CRM-implementatie.
In fase 1 en 2 helpt het dat de pagina recent is bijgewerkt en geïndexeerd staat.
In fase 3 helpt het dat elke alinea de term “CRM-implementatie” zelf noemt.
In fase 4 wint de passage die de vraag in één zin beantwoordt, met een concreet bedrag of een bron erbij.
Vuistregel: schrijf elke alinea alsof ze de enige is die de AI te zien krijgt.
Wil je weten waar je pagina’s vandaag afvallen? Een AI-zichtbaarheidsaudit loopt deze vier fasen per pagina na.
Waarom is de AI je nieuwe eerste lezer?
Omdat de AI je content leest en selecteert vóór een mens iets ziet.
Twee decennia lang dachten we aan twee doelgroepen: mensen en zoekmachines. AI-zoeken introduceert een nieuwe primaire lezer: de AI zelf.
De AI is de poortwachter
De AI leest, evalueert, extraheert en synthetiseert jouw content.
Selecteert ze je content niet, dan komt de mens ze nooit tegen.
Maar de AI leest anders. Ze ervaart je design niet en telt niet zomaar keywords.
Ze begrijpt betekenis, beoordeelt kwaliteit en oordeelt over bruikbaarheid, maar ontdaan van alle visuele en emotionele context.
Wat wordt ontmaskerd en wat beloond
Deze content valt door de mand:
- content die leunt op visuele context
- voornaamwoorden zonder antecedent
- de aanname dat de lezer de hele pagina zag
Content die met precisie en helderheid communiceert, wordt beloond.
Een hogere lat, ook voor mensen
Dat is een hogere lat dan klassieke SEO vroeg.
Op een vreemde manier dwingt de AI-lezer ons om betere communicators te worden.
Wie aan haar eisen voldoet, voldoet meestal ook beter aan de eisen van menselijke lezers.
Wil je dit afzetten tegen de oude aanpak, lees dan GEO vs SEO.
Veelgestelde vragen
Wat is query fan-out precies?
Query fan-out is het mechanisme waarbij een AI-zoeksysteem jouw ene vraag opsplitst in meerdere deelvragen en die elk apart uitvoert tegen een zoekinfrastructuur. Vervolgens combineert het de resultaten van al die deelvragen tot één samenhangend antwoord. Daardoor kan jouw content opduiken voor vragen die je nooit letterlijk had geoptimaliseerd.
Ziet een AI-model mijn pagina zoals een bezoeker?
Nee. Het model ziet vooral tekst, niet je design. Soms overleeft basis-HTML-structuur zoals koppen en vetgedrukte tekst, maar fonts, kleuren, afbeeldingen en layout verdwijnen. Daarom telt de inhoudelijke kwaliteit van je tekst zwaarder dan de visuele afwerking van je pagina.
Wat is contextuele instorting en hoe vermijd ik het?
Contextuele instorting gebeurt wanneer de AI een passage uit het midden van je pagina haalt zonder de omringende context. Voornaamwoorden zoals “het” of “wij” worden dan betekenisloos. Je vermijdt het door elke sectie en alinea zelfstandig leesbaar te maken: herhaal entiteits- en productnamen en zeg expliciet waar je het over hebt.
Triggert elke zoekvraag retrieval in AI-zoeken?
Nee. Bij vragen waar het model zeker van is, antwoordt het soms uit zijn eigen parametrische kennis zonder iets op te halen. Pas bij onzekere, actuele of gespecialiseerde vragen triggert het grounding en haalt het externe bronnen op. Alleen bij die grounded vragen kan jouw content meedingen om geselecteerd te worden.
Hulp nodig?
Wil je dit vertalen naar uitvoering? Bekijk hoe we dit aanpakken met AI-vindbaarheid: we zoeken uit welke van je doelvragen grounding triggeren en waar je content afvalt.
100 GEO-tips om genoemd te worden in ChatGPT en Google AI
- 10 hoofdstukken:van robots.txt en Bing tot meten
- Copy-paste:regex voor Search Console en GA4
- Sjablonen:koopvragen per fase en een 30-dagenplan
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.