
SEO & GEO
De probabilistische aard van AI-antwoorden (en wat dat betekent voor je zichtbaarheid)

Kopieer voor AI
AI geeft op dezelfde vraag telkens een ander antwoord, en dat is zo ontworpen.
Dat is de probabilistische aard van AI-antwoorden: andere bronnen, andere merken, een andere structuur, zonder dat er iets veranderde.
Het verdict: meet AI-zichtbaarheid als kans over een cluster van vragen, niet als positie voor één prompt. Eén dagelijkse momentopname meet vooral ruis.
Twintig jaar lang leefde SEO met een geruststellende fictie: zoeken was deterministisch.
Je typte een query, je kreeg een resultaat, en morgen kwam datzelfde resultaat terug. “Wij staan derde voor dit keyword” voelde concreet.
| Klassiek zoeken | AI-zoeken | |
|---|---|---|
| Zelfde vraag, morgen | Zelfde resultaat | Mogelijk een ander antwoord |
| Wat je meet | Positie | Kans |
| Eén meting zegt | Veel | Weinig |
AI-zoeken maakt korte metten met dat idee. Stel een vraag, stel hem opnieuw, en je krijgt mogelijk een ander antwoord.
Die variatie is geen bug. Ze zit ingebakken in hoe deze systemen werken.
En ze verandert alles aan hoe je zichtbaarheid meet: “kans” is de metric die nog telt.
Meet het zelf: zie hoe klaar je pagina is om door AI geciteerd te worden met de gratis GEO-check.
Wat betekent “probabilistisch” hier eigenlijk?
Dat een taalmodel elk woord kiest uit een kansverdeling, in plaats van een vast antwoord op te halen.
Een taalmodel haalt geen kant-en-klaar antwoord uit een database. Het genereert tekst token per token.
Een token is een woord of een stukje van een woord. Elk token wordt gekozen op basis van een kansverdeling over alle mogelijke volgende tokens.
Een voorbeeld
Stel dat het model “De beste aanpak om te…” heeft geschreven en het volgende woord moet kiezen.
Het berekent kansen voor elk woord in zijn vocabulaire. “Optimaliseren” krijgt misschien 15%, “verbeteren” 12%, “versterken” 8%, en zo verder over duizenden mogelijkheden.
En hier komt de willekeur binnen: het model kiest niet altijd het meest waarschijnlijke token.
Het sampelt uit de verdeling. Hoge-kanstokens worden vaker gekozen, maar lage-kanstokens blijven mogelijk.
Diezelfde kansverdeling zie je hieronder. Het waarschijnlijkste woord wint het vaakst, maar het model grijpt geregeld naar een minder waarschijnlijk woord:
Precies daar sluipt de variatie binnen.
De rol van temperatuur
Dat samplen wordt gestuurd door een parameter die “temperatuur” heet:
- Temperatuur nul: het model kiest altijd het meest waarschijnlijke token. In theorie deterministisch, in de praktijk niet.
- Hogere temperatuur: de verdeling vlakt af, lagere-kanstokens worden waarschijnlijker. Meer variatie, meer creativiteit.
Zelfs op nul varieert het antwoord. In een test van Thinking Machines Lab leverden 1.000 runs van dezelfde prompt op temperatuur 0 nog 80 verschillende antwoorden op.
De oorzaak: serverbelasting verandert hoe verzoeken gebundeld worden.
Een bewuste ontwerpkeuze
Productiesystemen draaien bijna altijd op een temperatuur boven nul, en dat is bewust.
Deterministische antwoorden voelen robotachtig en repetitief. Variatie maakt het gesprek menselijker.
Maar diezelfde keuze heeft grote gevolgen voor meting.
Dezelfde vraag geeft dan een ander antwoord, terwijl de data gelijk bleef.
Waarom leidt kleine variatie tot grote verschillen?
Omdat elke kleine sampling-keuze zich opstapelt over honderden tokens.
Neem een antwoord van 500 tokens. Elk token is een sampling-beslissing.
Zelfs als elke beslissing 95% kans heeft om hetzelfde uit te vallen, is de kans op een identiek antwoord 0,95 tot de macht 500.
Dat is in de praktijk nul.
Tien keer dezelfde vraag
Vraag tien keer “wat zijn de beste AI-SEO-strategieën?” en je krijgt tien betekenisvol verschillende antwoorden. Ze verschillen in:
- geciteerde bronnen
- genoemde merken
- structuur en formulering
- accent op verschillende strategieën
- detailniveau per punt
Dat zijn geen kleine verschillen in woordkeuze.
Het ene antwoord noemt jouw merk prominent, het volgende terloops, het derde laat je weg. Allemaal vanuit exact dezelfde vraag.
Wat grootschalig onderzoek toont
SparkToro en Gumshoe.ai lieten 600 vrijwilligers 12 prompts 2.961 keer draaien in ChatGPT, Claude en Google’s AI (SparkToro).
Twee resultaten springen eruit:
- Zelfde lijst: minder dan 1 kans op 100 dat ChatGPT of Google’s AI twee keer dezelfde merkenlijst geeft.
- Zelfde volgorde: eerder 1 op 1.000 runs voor twee lijsten in dezelfde volgorde.
Claude herhaalde een lijst volgens het onderzoek net iets vaker. Let wel: het is geen peer-reviewed studie, en Gumshoe.ai verkoopt zelf AI-tracking.
Hetzelfde onderwerp, andere modellen
Daarbovenop verschillen de modellen onderling.
Stel ChatGPT een vraag naar het beste CRM voor kleine B2B-teams, en je krijgt drie namen:
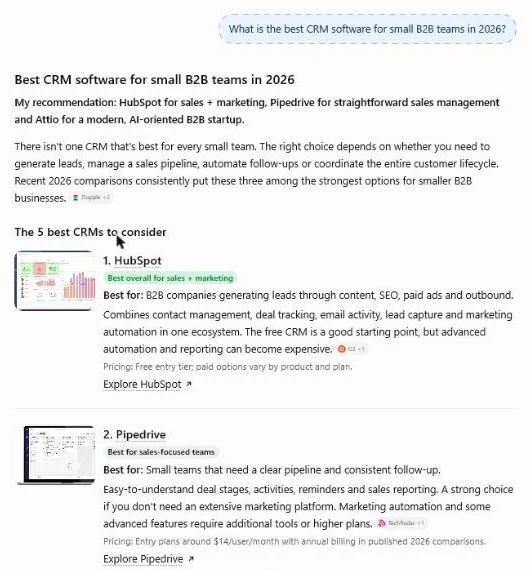 ChatGPT (gratis), 17 oktober 2026: drie CRM-leveranciers in één antwoord, met een reviewplatform als bron.
Perplexity noemde dezelfde dag op die vraag een andere set, met eigen bronnen:
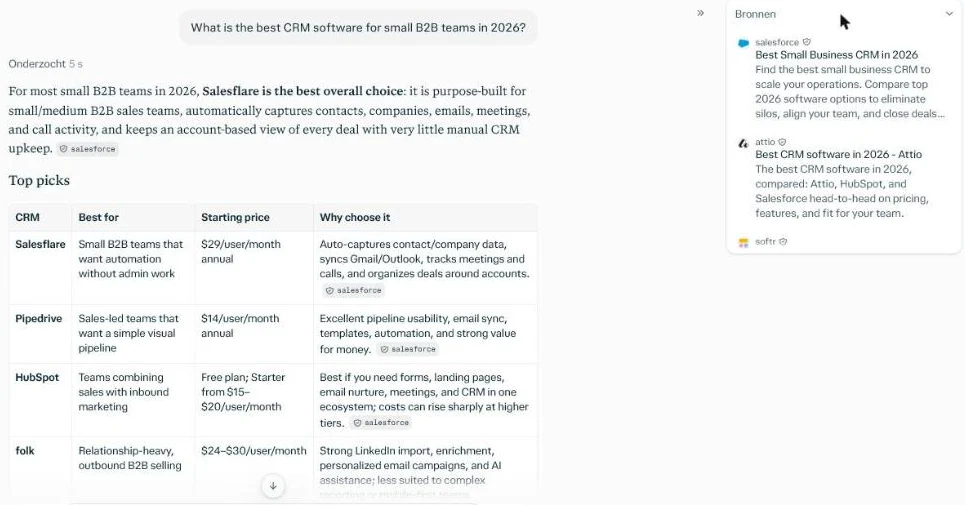 Perplexity, 17 oktober 2026: vijf merken en 11 bronnen, onder meer vendorblogs van Salesforce, Attio en Softr.
Twee van de vijf merken overlappen met ChatGPT. Wie maar één model volgt, ziet maar één verdeling.
De tweede bron van variatie: grounding
Er is nog een tweede bron van variatie, los van het samplen.
Het grounding-proces, het opzoeken en selecteren van bronnen, introduceert zijn eigen onzekerheid. Hoe die fan-out en selectie werken, lees je in hoe AI-zoekarchitectuur werkt.
De kern: het model splitst je vraag op in deelzoekopdrachten. Google noemt dat zelf “query fan-out”, en die opsplitsing is zelf niet deterministisch.
Een korte definitie staat in wat is query fan-out.
Drie lagen van grounding-variatie
| Bron | Waarom het varieert |
|---|---|
| Query fan-out | Het model splitst dezelfde vraag op maandag anders op dan op dinsdag, omdat het tussenliggende redeneren anders sampelt |
| Timing van retrieval | Het web verandert constant: nieuwe pagina’s, updates, een nieuwsmoment dat bepaalde bronnen tijdelijk omhoogstuwt |
| Selectiedrempel | Selectie is geen harde ja/nee maar een kans: een bron met 60% selectiekans zit er soms wel en soms niet bij |
Het gevolg: je zichtbaarheid kan veranderen zonder dat jij iets deed.
Denk aan een concurrent die iets nieuws publiceert, of een freshness-signaal dat verschuift. Je verschijnt dan vandaag minder vaak dan gisteren.
Waarom faalt prompt-tracking?
Omdat één dagelijkse run één toevallig punt uit een kansverdeling meet.
De eerste generatie AI-zichtbaarheidstools paste de oude rank-tracking toe op AI-antwoorden. Het recept:
- Definieer een set prompts.
- Draai die prompts dagelijks tegen de AI-systemen.
- Noteer of het merk in het antwoord verscheen.
- Volg dat over tijd als een soort “ranking”.
Het voelt intuïtief en het lijkt op meten. Maar het meet het verkeerde.
Eén punt uit een verdeling
Volg je een prompt dagelijks, dan sampel je één punt uit een kansverdeling.
Vandaag verscheen het merk, morgen niet. Was dat omdat je zichtbaarheid veranderde, of omdat je toevallig een ander punt trok?
Je kan het niet weten. De metric is zo ruizig dat ze betekenisloos wordt.
Rand Fishkin van SparkToro zegt het scherp: elke tool die een “ranking position in AI” geeft, is volgens hem “full of baloney”.
Vals vertrouwen
Erger nog: het wekt vals vertrouwen.
“Merk vermeld: ja” in je dashboard betekent niet dat je zichtbaar bent voor die vraag. Misschien verschijn je maar 30% van de tijd, en was vandaag toevallig een van die keren.
Ik heb teams “verbeteringen” zien vieren die niets anders waren dan ruis. En teams zien panikeren over “dalingen” die gewoon een terugkeer naar het gemiddelde waren.
Wat prompt-monitoring wel kan, lees je in prompt-monitoring uitgelegd.
Het steekproefprobleem
“Prima”, zeg je dan, “dan draaien we elke prompt honderd keer en nemen we het gemiddelde.”
Dat helpt, maar het brengt drie nieuwe problemen:
- De economie schaalt niet. Honderd runs per prompt, over honderden prompts en meerdere platformen, regelmatig herhaald: de API-kosten lopen snel op.
- Je meet nog steeds maar specifieke prompts. Gebruikers herformuleren, stellen vervolgvragen en gebruiken synoniemen. De ruimte aan vragen is praktisch oneindig.
- Je promptkeuze introduceert bias. Teams kiezen van nature vragen waar ze goed verwachten te scoren.
Onze ervaring: 30 prompts is waarschijnlijk niet genoeg voor een betrouwbaar beeld. Werk met een grotere promptset.
Hoe je zo’n set opbouwt, staat in een promptset samenstellen voor monitoring.
Van positie naar kans: hoe ziet de mentale omslag eruit?
Stop met denken over positie, begin te denken over kans.
Bij klassiek zoeken was de vraag: “welke positie hebben we voor deze query?”.
Bij AI-zoeken wordt de vraag: “wat is de kans dat we verschijnen in antwoorden binnen dit topiccluster, en hoe prominent zijn we dan?”.
Die verschuiving raakt ook je mediakeuzes. AI-search vervaagt de grens tussen betaald en organisch, en dat heeft gevolgen voor hoe je je budget verdeelt.
Drie dingen veranderen tegelijk
Die herformulering verandert drie dingen:
- Van rankings naar verdelingen. Je volgt een kansverdeling. Bijvoorbeeld: je verschijnt in 45% van de relevante antwoorden, met een gemiddelde prominentie van 0,6.
- Van keywords naar topicclusters. Je volgt zichtbaarheid over een cluster van verwante vragen, als geaggregeerd verschijningspercentage.
- Van momentopnames naar verwachte waarde. Verschijn je in 50% van de vragen maar minder prominent dan voorheen? Alleen verwachte-waarde-berekeningen zeggen of je zichtbaarheid steeg.
Ook SparkToro komt tot die conclusie. Een zichtbaarheidspercentage over tientallen tot honderden prompts, meermaals gedraaid, noemen ze “a reasonable metric”.
Zo ziet een kans eruit in de praktijk
Wij meten onze eigen zichtbaarheid zo. In Perplexity volgen we 125 prompts waarin iemand een bureau kiest:
Onze ervaring: Perplexity noemt Customer Impact nu in 16 van de 125 prompts, tegenover 7 eerder.
Dat is geen positie. Het is een kans van ongeveer 13%.
Reken je een betrouwbaarheidsinterval uit, dan ligt de echte kans bij 16 op 125 ruwweg tussen 8 en 20%. Precies daarom heb je een grote steekproef nodig.
Brand salience
Wil je dieper in deze meetmethode duiken, dan helpt brand salience meten je verder.
Brand salience meet hoe sterk een model jouw merk associeert met relevante onderwerpen, los van een specifieke vraag.
Het is een eigenschap van de kennis en bias van het model, niet van één antwoord.
Meer meetpunten: nieuwe metrics voor AI-zichtbaarheid.
Waarom is onzekerheid goed nieuws (echt)?
Omdat voordelen in een probabilistisch systeem robuuster zijn dan in een ranking.
Geen binaire omslag
In deterministische systemen zijn voordelen fragiel. Je staat derde, een concurrent verbetert zijn pagina, en plots sta je vierde.
In probabilistische systemen zijn voordelen robuuster.
Bijvoorbeeld: je hebt 45% verschijningskans, een concurrent verbetert zijn content, en je kans zakt naar 42%.
De verandering is evenredig met de verbetering, geen binaire omslag.
Consistentie wint van trucjes
Probabilistische systemen belonen bovendien consistentie boven trucjes.
In klassieke SEO kon een slimme hack je tijdelijk omhoogstuwen. In AI-zoeken komt duurzame zichtbaarheid uit echte kwaliteit en autoriteit, want die sturen de kansverdeling over tijd.
Wie altijd al begreep dat SEO over kans en invloed ging, voelt zich gevalideerd.
Hoe bouw je een probabilistisch meetsysteem?
In vijf stappen, van cluster tot segment.
Als kans de fundamentele metric is, ziet een degelijk meetsysteem er in grote lijnen zo uit.
Stap 1: Definieer topicclusters
Elk cluster is een ruimte van semantisch verwante vragen.
Maak ze compleet (dekt wat zakelijke waarde drijft), distinct (minimale overlap) en meetbaar (klein genoeg voor statistische significantie).
Stap 2: Sampel met diverse formuleringen
Genereer per cluster niet alleen keywords, maar natuurlijke vragen, herformuleringen en verschillende intenties.
Noteer per query drie dingen: of je verscheen, hoe prominent, en welke concurrenten verschenen.
Stap 3: Analyseer de verdeling
Aggregeer tot verschijningspercentage, prominentieverdeling en competitieve positie.
Hoe je dat per merk vergelijkt, lees je in AI-zichtbaarheid meten met share of voice.
Stap 4: Volg trends met statistiek
Omdat je verdelingen meet, heb je betrouwbaarheidsintervallen nodig om echte verandering van ruis te scheiden.
Een sprong van 45% naar 47% is mogelijk niet significant. Van 45% naar 55% waarschijnlijk wel.
Stap 5: Segmenteer
Splits zichtbaarheid op per platform, cluster, intentie en taal, zoals Google versus ChatGPT.
Je kan sterk staan op Google maar zwak in ChatGPT.
Waarom segmenteren per platform geen detail is
Modellen verschillen sterk in welke merken ze kennen en hoe ze antwoorden.
Daarom is cross-model analyse een vast onderdeel van een volwassen meetaanpak.
Welke tools je daarbij helpen, staat in ons overzicht van AI-zichtbaarheidstools.
Zonder budget? Begin met AI-zichtbaarheid meten zonder tools.
Hoeveel onzekerheid is er nog?
Veel: we staan nog vroeg in het begrijpen van probabilistische AI-zichtbaarheid.
De frameworks die ik beschrijf, steunen op zorgvuldige observatie. Maar ze zijn nog niet uitgekristalliseerd.
De tools worden nog gebouwd. De benchmarks bestaan nog niet.
Valse zekerheid is erger
Het alternatief is doen alsof AI-zoeken deterministisch is, en de oude trackingmethodes toepassen.
Dat geeft geen echte zekerheid. Het geeft valse zekerheid: cijfers die concreet voelen maar ruis zijn.
Open onzekerheid is beter dan zelfverzekerd fout.
Wie nu probabilistisch meet, bouwt een voorsprong die zich opstapelt.
Veelgestelde vragen
Waarom geeft AI elke keer een ander antwoord op dezelfde vraag?
Omdat het model tekst genereert door token per token uit een kansverdeling te samplen, gestuurd door een temperatuur boven nul.
Het kiest niet altijd het meest waarschijnlijke woord, waardoor kleine variaties zich opstapelen tot betekenisvol verschillende antwoorden. Daarbovenop introduceert het opzoeken en selecteren van bronnen extra variatie.
Is prompt-tracking dan helemaal nutteloos?
Als ranking-metric is het misleidend, omdat je elke dag één toevallig punt uit een variabele verdeling sampelt.
Het kan wel waarde hebben als kwalitatieve check: wat zegt het model precies, welke bronnen citeert het? Voor een betrouwbare zichtbaarheidsscore heb je voldoende steekproef en statistische analyse nodig.
Wat is een topiccluster en waarom is het belangrijk?
Een topiccluster is een groep semantisch verwante vragen die klanten rond hetzelfde onderwerp stellen.
Omdat de ruimte aan formuleringen praktisch oneindig is, meet je zichtbaarheid niet per keyword. Je meet een geaggregeerd verschijningspercentage over het hele cluster. Dat geeft een veel stabieler en zakelijk relevanter beeld.
Hoeveel prompts heb je nodig?
Meer dan de meeste teams denken. In onze ervaring is 30 prompts waarschijnlijk te weinig; wij volgen bijvoorbeeld 125 prompts voor één vraag als bureaukeuze.
SparkToro noemt tientallen tot honderden prompts, meermaals gedraaid, een redelijke basis.
Hoe begin ik concreet met probabilistisch meten?
Definieer eerst enkele topicclusters die echte zakelijke waarde drijven.
Genereer per cluster een diverse set vraagformuleringen, en draai die met voldoende herhaling tegen de relevante AI-platformen. Aggregeer tot een verschijningspercentage met prominentie en concurrentiepositie, en volg dat met betrouwbaarheidsintervallen.
Hulp nodig?
Wil je dit vertalen naar uitvoering? Bekijk hoe we dit aanpakken met AI-vindbaarheid.
100 GEO-tips om genoemd te worden in ChatGPT en Google AI
- 10 hoofdstukken:van robots.txt en Bing tot meten
- Copy-paste:regex voor Search Console en GA4
- Sjablonen:koopvragen per fase en een 30-dagenplan
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.