
SEO & GEO
Grounding snippets: de atomaire eenheid van AI-zichtbaarheid

Kopieer voor AI
Een grounding snippet is de passage die een AI uit je pagina haalt.
Soms is dat één zin, soms een paragraaf, soms een paar paragrafen. Maar het is nooit je hele pagina.
Kort oordeel: grounding snippets zijn de atomaire eenheid van AI-zichtbaarheid. Wat niet als losse passage overeind blijft, telt voor die vraag niet mee.
Een AI vat je pagina niet samen: hij extraheert.
Je intro, je navigatie en je call-to-action bestaan voor die ene query simpelweg niet.
Dit stuk hoort bij de ultieme GEO-handleiding, waarin generative engine optimization (GEO) van fundament tot meting aan bod komt.
Hoe scoort jouw pagina? Check je GEO-readiness met onze gratis GEO-tool.
Wat is het 32%-probleem?
Gemiddeld komt maar ongeveer 32% van je paginacontent in AI-antwoorden terecht.
Dat cijfer komt uit de analyse van DEJAN. Ze legden 883.262 snippets uit 7.060 zoekopdrachten in Google Gemini naast 2.275 bronpagina’s.
Grofweg een derde overleeft het extractieproces. Twee derde van je zorgvuldig geschreven content wordt voor die query nooit gebruikt.
Geen fout, maar de werking
Dat is geen inefficiëntie. Het is hoe AI-zoeken werkt.
Het model destilleert je argument niet en vat je betoog niet samen.
Het pikt de passages eruit die het antwoord dienen dat het op dat moment bouwt.
De rest blijft onzichtbaar, hoe goed geschreven ook.
Van pagina’s naar extraheerbare eenheden
Dus schrijf je niet langer pagina’s, maar losse eenheden. Elke eenheid moet:
- op zichzelf functioneren
- concurreren om geselecteerd te worden
- de compressie overleven als meerdere bronnen meedoen
Hoe werkt het extractieproces?
Een AI-systeem doorloopt vijf stappen voor het een snippet kiest. Elke stap versmalt de content verder.
Onderstaand schema volgt die trechter van complete pagina tot geselecteerde snippet:
Stap 1: document retrieval
De AI haalt kandidaat-documenten op via zijn zoekproces.
Daarvoor moet je pagina volgens Google geïndexeerd zijn en in aanmerking komen om met een snippet in Search te verschijnen.
Je pagina zit dan in de selectie: gevonden, geopend en geëvalueerd.
Stap 2: content parsing
Het systeem stript navigatie, advertenties en boilerplate weg. Wat overblijft, is het eigenlijke contentlichaam.
Let op: tekst die alleen in een afbeelding of achter een klik zit, valt hier vaak al weg.
Stap 3: chunk-identificatie
De content wordt opgedeeld in potentiële brokken: paragrafen, secties onder koppen of semantische eenheden.
Hoe dat opdelen werkt, staat uitgewerkt in content chunking voor AI-zoekmachines.
Stap 4: relevantiescoring
Elke chunk krijgt een score. Die hangt af van:
- semantische gelijkenis met de query
- aanwezigheid van relevante termen
- informatiedichtheid
- structurele signalen zoals koppen
In de DEJAN-data loopt die betrouwbaarheidsscore per chunk van 0,1 tot 1,0.
Stap 5: selectie en extractie
Het model kiest welke chunks het echt gebruikt. Die keuze balanceert relevantie, bronnendiversiteit, de lengtegrens van het antwoord en redundantie.
De les: een hoge relevantiescore is nodig, maar niet genoeg. Je passage moet ook winnen van alternatieven én in de beperkte ruimte passen.
Waarom overleeft de meeste content niet?
Omdat een query één behoefte dient, en het grootste deel van je pagina die behoefte niet raakt.
Vijf oorzaken komen steeds terug:
Query-specificiteit
Je pagina dekt misschien tien onderwerpen, maar de vraag draait om één.
Een snippet toont volgens Google precies de paginacontent die het best bij die specifieke zoekopdracht past.
De andere negen worden niet geëxtraheerd, niet omdat ze slecht zijn, maar omdat ze dit antwoord niet dienen.
Structurele overhead
Intro’s, overgangen, conclusies en auteursbio’s zijn nuttig voor de menselijke lezer. Voor extractie zijn ze ballast.
Informatieredundantie
Goed schrijven herhaalt een kernpunt voor de nadruk. De AI heeft maar één formulering nodig.
Contextafhankelijke content
Neem de zin “deze aanpak lost, zoals hierboven besproken, het eerste probleem op”. In isolatie is die betekenisloos.
Welke aanpak? Welk probleem?
Concurrentie van andere bronnen
Zelfs relevante content sneuvelt als een concurrent hetzelfde beter verwoordt.
De ruimte in het antwoord is beperkt. Niet iedereen doet mee.
Wat is het compressie-effect?
Hoe meer bronnen een antwoord gebruikt, hoe korter elke snippet wordt. Dat is het compressie-effect, en het volgt een machtswet.
Zwakker dan je denkt
Maar dat effect is zwak. In de DEJAN-analyse heeft de curve een exponent van amper 0,07.
De gemiddelde snippet wordt van één naar tien bronnen maar zo’n 15% korter.
Een enkele grounding chunk telt gemiddeld ongeveer 15,5 woorden.
De echte knijp zit in de rangschikking
De grotere knijp zit in de volgorde van de bronnen. Elke query krijgt een grounding-budget van ongeveer 2.000 woorden (mediaan 1.929), en dat wordt ongelijk verdeeld:
| Positie van de bron | Gegronde woorden (mediaan) | Aandeel van het budget |
|---|---|---|
| Bron 1 | 531 | 28% |
| Bron 2 | 433 | 23% |
| Bron 3 | 378 | 20% |
| Bron 4 | 330 | 17% |
| Bron 5 | 266 | 13% |
Bron: DEJAN, grounding-analyse van Google Gemini.
De eerste bron krijgt dus ongeveer twee keer zoveel ruimte als de vijfde.
Wat dat betekent voor jou
Je concurreert niet alleen om geselecteerd te worden. Je concurreert om ruimte binnen een begrensd antwoord.
En hoe competitiever de query, hoe minder ruimte je krijgt, zelfs als je erin staat.
Dat dwingt tot informatiedichtheid: elk woord moet zijn plaats verdienen.
Langere pagina’s, kleiner aandeel
Er is nog een patroon.
Het aantal gegronde woorden per pagina vlakt af rond 540 woorden, hoe lang de pagina ook is.
Daardoor daalt het gebruikte aandeel scherp bij langere pagina’s:
Vuistregel: een lange pagina is geen probleem, maar dan moet elke sectie een eigen vraag beantwoorden. Anders betaal je voor woorden die nooit meedoen.
Hoe ziet een sterke snippet eruit?
Een sterke snippet staat op zichzelf, noemt zijn onderwerp bij naam en zegt iets concreets.
Uit passages die consistent geëxtraheerd worden, komen vaste kenmerken naar boven. Dit is de anatomie van een goede grounding snippet:
| Kenmerk | Wat het betekent |
|---|---|
| Zelfstandige betekenis | De passage klopt zonder omringende context, zonder “het bovenstaande” of “zoals genoemd”. |
| Expliciete entiteiten | Merken, producten en begrippen worden bij naam genoemd, niet met “het” of “ze”. |
| Informatiedichtheid | Geen vulwoorden (“het is belangrijk om op te merken dat”), geen overbodige kwalificaties. |
| Directe bewering | ”Pagina’s met heldere kopstructuur worden vaker geselecteerd” wint van een omfloerste, voorwaardelijke variant. |
| Structurele grenzen | De snippet valt samen met een volledige paragraaf of sectie, niet halverwege een gedachte. |
Voorbeeld: zelfstandig versus contextafhankelijk
Een zelfstandige snippet benoemt expliciet waar het over gaat:
- Extraheerbaar: “Selection Rate meet hoe vaak AI-systemen een specifieke bron kiezen uit de opgehaalde kandidaten.”
- Niet extraheerbaar: “Deze metriek, die we in de vorige sectie introduceerden, verschilt op enkele punten.”
De tweede zin heeft de vorige sectie nodig. Die reist niet mee.
Zie het in een echt antwoord
Perplexity toont welke pagina’s elk deel van een antwoord dragen. Kijk in het bronnenpaneel welke passages het overnam:
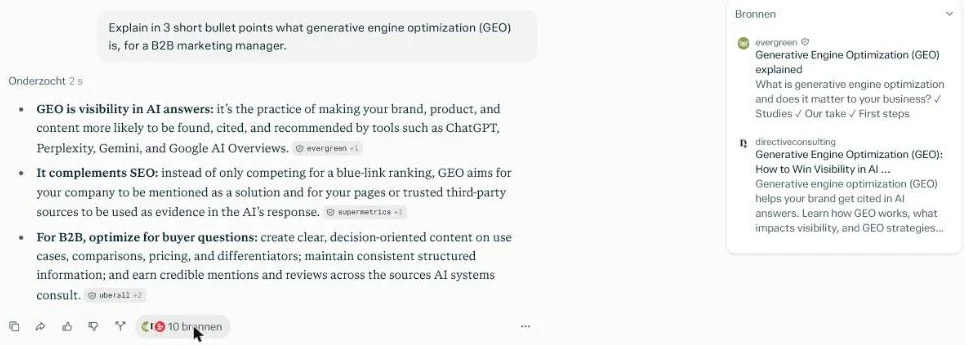 Het bronnenpaneel van Perplexity voor onze eigen testprompt, 17 oktober 2026: 10 webpagina’s achter één antwoord.
Elke bron in die lijst leverde minstens één passage. De rest van die pagina’s deed niet mee.
Meer over het schrijven van zulke passages lees je in citatiewaardige content schrijven voor AI.
Wat zijn contextuele instorting en semantische compressie?
Contextuele instorting is wat er gebeurt als een passage zijn betekenis verliest zodra hij uit de pagina wordt gehaald.
Het is de meest voorkomende oorzaak van mislukte extractie. We noemen het zo omdat de opgebouwde context in één keer wegvalt.
Waarom het gebeurt
Een mens die je pagina leest, bouwt context op terwijl hij scrolt. Voornaamwoorden verwijzen naar wat net genoemd is.
Relatieve termen als “deze aanpak” kloppen omdat de lezer de context heeft.
Maar wanneer de AI een snippet extraheert, reist die context niet mee.
“De eerste uitdaging is het lastigst op te lossen” is voor een mens helder.
In isolatie weet niemand welke uitdaging dat is.
Het tegengif: semantische compressie
Het tegengif is semantic compression: de betekenis zit in elke extraheerbare eenheid, niet verspreid over de pagina.
Concreet benoem je de entiteit expliciet, ook al noemde je hem net. Bijvoorbeeld:
“Zichtbaarheidsmeting is de lastigste uitdaging in AI-SEO. Om zichtbaarheidsmeting aan te pakken, hebben praktici nieuwe frameworks nodig.”
Die herhaling voelt overdreven bij het lezen van de volledige pagina. Maar de AI-lezer heeft geen geheugen van de vorige zin.
Wat voor mensen redundant lijkt, is voor extractie essentieel.
Welke rol spelen koppen en de eerste paragraaf?
Koppen bepalen waar een snippet begint en eindigt, en de eerste paragraaf eronder wordt het vaakst geëxtraheerd.
AI-systemen gebruiken koppen om contentgrenzen en onderwerpen te herkennen. Een kop is een label voor de tekst eronder.
Koppen als query-match
Een sectie met de kop “Wat is Selection Rate?” sluit perfect aan op die vraag.
Dat is geen keyword stuffing. Het zijn koppen die weerspiegelen hoe je publiek echt vraagt.
Koppen als grenssignaal
Chunking-algoritmes gebruiken koppen om secties af te bakenen. De content tussen twee koppen vormt een natuurlijke extractie-eenheid.
Dus moet elke sectie op zichzelf staan.
De premie op de eerste paragraaf
De eerste paragraaf na een kop heeft de grootste kans om geëxtraheerd te worden.
Tip: zet daar je belangrijkste informatie. Verspil die ruimte niet aan overgangen of context-setting.
Deze logica werken we verder uit in content-architectuur voor AI-extractie, waar de paginastructuur centraal staat.
Wat is de multi-snippet-strategie?
Je optimaliseert een pagina niet voor één snippet, maar voor een portfolio van passages die elk een ander querytype bedienen.
Zie je pagina als een verzameling extraheerbare eenheden:
- een overzichtssnippet voor algemene vragen
- detailsnippets voor verdiepende vragen
- een definitiesnippet voor “wat is”-vragen
- een procedurele snippet voor “hoe doe je”-vragen
- een datasnippet voor bewijsgerichte vragen
Snippets vergroten je oppervlak
Snippets op dezelfde pagina concurreren niet met elkaar voor verschillende query’s. Ze vergroten het query-oppervlak dat je pagina kan bedienen.
Een pagina met tien sterke passages heeft tien keer zoveel extractie-oppervlak als een pagina met één.
Bij complexe vragen worden soms meerdere snippets van jouw pagina samen geëxtraheerd, bijvoorbeeld je definitie plus je voorbeeld.
Dat sluit aan op query fan-out: Google zegt dat AI Overviews en AI Mode meerdere verwante zoekopdrachten over subonderwerpen kunnen uitvoeren.
Hoe je die vragen in kaart brengt, staat in query fan-out en intentieclassificatie.
Welk snippettype past bij welke vraag?
Welke snippet bij welk querytype past, ligt grotendeels vast:
| Querytype | Snippettype | Hoe je hem opbouwt |
|---|---|---|
| ”Wat is X?” | Definitiesnippet | Start met de definitie, dan kenmerken en een concreet voorbeeld. |
| ”Hoe werkt X?” | Verklarende snippet | Begin met het mechanisme, breek het op in stappen. |
| ”X versus Y” | Vergelijkende snippet | Zet een kader neer met de onderscheidende factoren. |
| ”Hoe doe je X?” | Procedurele snippet | Genummerde stappen met een succescriterium. |
| Bewijsvraag | Statistische snippet | Leid met het kerncijfer, geef bron en benchmark. |
Hoe je dit selectiegevecht systematisch wint, staat in Selection Rate Optimization. Een stapsgewijs schrijfkader vind je in het grounding snippet extractie-framework.
Wat betekent dit voor je contentstrategie?
Het betekent dat je eerst voor extractie schrijft en pas daarna voor narratieve flow.
Vijf verschuivingen tegenover klassiek schrijven:
- Schrijf eerst voor extractie: maak elke sectie zelfstandig waardevol.
- Omarm strategische redundantie: benoem entiteiten in elke snippet opnieuw.
- Front-load agressief: maak de eerste zin van elke sectie extraheerbaar.
- Granulaire structuur: geef elk apart onderwerp een eigen kop.
- Expliciet boven impliciet: de AI leidt geen nuance af, hij extraheert tekst.
Een snelle test voor je eigen pagina’s
Neem een bestaande pagina en lees elke eerste zin onder een kop los van de rest. Stel per zin twee vragen:
- Snapt een vreemde wat hier bedoeld wordt?
- Staat het onderwerp er bij naam in?
Twee keer ja betekent een kandidaat-snippet. Eén keer nee betekent herschrijven.
Hetzelfde principe helpt ook in klassieke zoekresultaten, zie een featured snippet winnen.
Samengevat: wie begrijpt hoe snippets geëxtraheerd worden, bouwt content om geciteerd te worden in plaats van alleen gelezen.
Veelgestelde vragen
Wat is een grounding snippet precies?
Een grounding snippet is de specifieke tekstpassage die een AI-systeem uit een bronpagina haalt om in zijn antwoord te verwerken.
Dat kan één zin zijn of een paar paragrafen, maar nooit je hele pagina.
Al het andere op de pagina telt voor die query niet mee.
Waarom haalt AI maar ongeveer 32% van mijn content?
Omdat een AI je pagina niet samenvat maar extraheert.
Een query dient één specifieke behoefte, dus alleen de relevante passages worden gebruikt.
Structurele content en herhalingen worden overgeslagen. Relevante passages verliezen soms van betere passages bij concurrenten.
Hoe maak ik een passage extraheerbaar?
Zorg dat de passage zelfstandig klopt zonder omringende context. Benoem entiteiten expliciet in plaats van met “het” of “deze aanpak”.
Schrap vulwoorden, doe een directe bewering en laat de passage samenvallen met een volledige paragraaf onder een kop.
Moet ik per pagina voor één snippet optimaliseren?
Nee. Een sterke pagina biedt een portfolio aan snippets voor verschillende query’s: een definitie, een uitleg, een procedure, een datapunt.
Die snippets concurreren niet met elkaar maar vergroten je query-oppervlak.
Hulp nodig?
Wil je dit vertalen naar uitvoering? Bekijk hoe we dit aanpakken met AI-vindbaarheid.
Verder lezen
100 GEO-tips om genoemd te worden in ChatGPT en Google AI
- 10 hoofdstukken:van robots.txt en Bing tot meten
- Copy-paste:regex voor Search Console en GA4
- Sjablonen:koopvragen per fase en een 30-dagenplan
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.