
SEO & GEO
Content-architectuur voor AI-extractie: structuur die AI kan citeren

Kopieer voor AI
Content-architectuur voor AI-extractie is pagina’s bouwen die AI kan navigeren en citeren.
Je hebt een mooie pagina. Het design klopt, de tekst leest vlot, de informatie staat er. En toch citeert geen enkel AI-model je.
Dat is frustrerend, want het probleem zit niet in wat je schrijft, maar in hoe het is opgebouwd.
Voor een AI-systeem is veel webcontent een doolhof:
- gangen die doodlopen
- secties zonder duidelijke grenzen
- kernfeiten begraven onder drie alinea’s context
Ons oordeel: structuur is geen vormkwestie maar een citatiekwestie. Zonder heldere koppen, secties en volgorde moet een model gokken, en dan kiest het een andere bron.
Hoe scoort jouw pagina? Check je GEO-readiness met onze gratis GEO-tool.
Waarom werkt structuur anders voor AI dan voor mensen?
Omdat een mens visuele opmaak gebruikt en een AI-model meestal alleen tekstuele signalen ziet.
De menselijke lezer navigeert visueel
Een menselijke lezer is een geweldige navigator. Je scant visueel, herkent designpatronen en maakt intuïtieve sprongen op basis van ervaring.
Zelfs op een rommelige pagina vind je je weg met wat doorzettingsvermogen.
De AI-lezer is krachtiger en beperkter
Een AI-lezer is tegelijk krachtiger en beperkter:
| Krachtiger | Beperkter | |
|---|---|---|
| Wat het doet | verwerkt de hele pagina in één keer | ziet in de meeste zoekcontexten geen visuele opmaak |
| Gevolg | beoordeelt elke sectie op relevantie voor de vraag | moet de structuur afleiden uit tekst alleen |
Zonder duidelijke signalen moet de AI gokken. En gokken leidt tot suboptimale extractie.
Het model haalt eruit wat het toevallig vindt, niet wat je antwoord het sterkst zou maken.
Vijf signalen die een AI-lezer nodig heeft
De AI-lezer heeft expliciete signalen nodig om:
- afzonderlijke contentsecties te herkennen
- het onderwerp en de scope van elke sectie te begrijpen
- de grenzen tussen secties te bepalen
- de relevantie per sectie tegen de vraag te wegen
- volledige, samenhangende passages te extraheren
GEO, generative engine optimization, draait dus niet om mooier schrijven maar om navigeerbaar schrijven.
Die signalen begin je in je HTML zelf: zie semantische HTML voor AI-extractie.
Wat is de structurele hiërarchie, van pagina-onderwerp tot extractie-eenheid?
Content-architectuur werkt via hiërarchie: geneste niveaus die van breed naar specifiek lopen.
Vier lagen
Ik denk er in vier lagen over:
- Pagina-onderwerp. Waar gaat de hele pagina over? Gesignaleerd door de H1, de meta description, de openingsalinea en de URL. Dit bepaalt of je pagina überhaupt in de overweging komt.
- Hoofdsecties. De pagina splitst in distincte deelonderwerpen via H2’s en thematische breuken. Zo navigeert de AI naar het relevante gebied zonder de rest te verwerken.
- Subsecties. Binnen hoofdsecties verfijn je met H3’s, paragraafgroepen en lijsten. Dit maakt precieze extractie mogelijk.
- Extractie-eenheden. Het fijnste niveau: losse alinea’s, lijstitems, definities en datapunten. Dit zijn de atomaire stukjes die in een AI-antwoord belanden.
De trechter in beeld
Die vier lagen vormen samen een trechter: van het paginabrede onderwerp bovenaan tot het kleinste, zelfstandige fragment onderaan dat een model citeert.
Een heldere hiërarchie op elk niveau laat de AI vlot navigeren van onderwerp naar specifiek detail.
Dit hangt nauw samen met hoe je binnen die containers schrijft. Dat diep ik uit in semantic compression.
Waarom is kopstructuur jouw belangrijkste navigatiesignaal?
Koppen zijn de primaire structuursignalen voor AI.
Zie ze als wegwijzers in een gebouw: elke kop vertelt het model “deze sectie gaat over onderwerp X”. Drie dingen maken koppen effectief.
Beschrijvende koppen
Een kop moet de inhoud expliciet benoemen, niet vaag aankondigen. Neem bijvoorbeeld de pagina van een data-platform als DataFlow:
| Zwak | Sterk |
|---|---|
| ”Overzicht" | "Wat DataFlow doet: realtime data-integratie" |
| "Kenmerken" | "De kernfuncties van DataFlow" |
| "Aan de slag" | "Hoe je DataFlow implementeert” |
De sterke versie vertelt de AI precies wat volgt.
De zwakke versie dwingt het model de sectie eerst te lezen om het onderwerp te raden.
Query-gerichte koppen
Laat je koppen aansluiten op hoe mensen vragen stellen:
- vraagt iemand “wat is X?”, maak dan een kop “Wat is X?”
- vraagt iemand “hoe werkt X?”, schrijf dan “Hoe X werkt”
- bij vergelijkingen: “X versus Y”
Zo navigeert het model rechtstreeks naar de responsieve sectie. Verdiep je in deze aanpak via koppen als vragen voor AI-extractie.
Consistente hiërarchie
Gebruik kopniveaus zoals ze bedoeld zijn: één H1 per pagina, H2 voor hoofdsecties, H3 voor subsecties.
Sla geen niveaus over (niet van H2 naar H4), iets wat ook het W3C afraadt. Gebruik koppen nooit puur voor visuele styling.
De hiërarchie moet de echte organisatie van je content weerspiegelen.
Google zelf is soepeler: volgens de SEO-startersgids maakt de volgorde van koppen voor Search niet uit.
Een zuivere hiërarchie draait dus om duidelijkheid voor elke lezer, niet om een rankingtruc.
Hoe maak je elke sectie zelfstandig binnen haar grenzen?
Door elke sectie volledig, op de juiste lengte en met schone grenzen te schrijven.
Koppen markeren ook waar secties beginnen en eindigen. De AI gebruikt die grenzen als potentiële extractie-eenheden.
Drie voorwaarden per sectie
Elke sectie moet aan drie voorwaarden voldoen.
1. Volledig
Een sectie behandelt haar onderwerp zonder naar andere secties te verwijzen. Vermijd “zie de volgende sectie voor details”; geef de details meteen.
2. Juiste lengte
Te kort (drie zinnen) mist informatiedichtheid. Te lang (2.000 woorden) is moeilijk coherent te extraheren.
De sweet spot ligt rond 200 tot 500 woorden per hoofdsectie, met subsecties die langere stukken opbreken.
3. Schone grenzen
Vermijd content die dubbelzinnig tussen secties hangt. Open elke sectie met een duidelijke topiczin die de scope vastlegt, niet met “zoals we eerder bespraken…”.
Hoe je lange pagina’s in zulke blokken verdeelt, lees je in content chunking voor AI-zoekmachines.
De premie op de eerste alinea
Hier zit een van de krachtigste inzichten. De eerste alinea na een kop krijgt onevenredig veel extractie-aandacht.
Navigeert de AI op basis van de kop naar een sectie? Dan evalueert het die eerste alinea om relevantie te bevestigen.
Is die sterk, dan wordt hij waarschijnlijk geëxtraheerd. Is hij zwak, dan haakt het model af.
Verspild versus substantieel
Verspil die eerste alinea dus niet aan een overgang of een aankondiging. Vergelijk:
- Verspild: “In deze sectie verkennen we de functies die DataFlow uniek maken. Dit begrijpen is essentieel om te beoordelen of het platform bij je past.”
- Substantieel: “De kernfuncties van DataFlow zijn realtime streaming, kant-en-klare connectoren en gebruiksgebaseerde prijzen. Realtime streaming schakelt batchvertraging uit en levert updates binnen de seconde.”
Zorg dat die eerste alinea de isolatietest doorstaat: geen “zoals hierboven vermeld”, wel een zelfstandige bewering.
Dit principe ligt aan de basis van goede grounding snippets.
Waarom wint front-loading in de informatievolgorde?
Omdat elke extractiediepte dan nog bruikbare content oplevert.
Draai de klassieke opbouw om
Naast koppen en eerste alinea’s bepaalt de volgorde binnen een sectie de extractiekwaliteit.
De klassieke opbouw werkt naar een conclusie toe: context, details, voorbeelden, dan pas het punt. Voor AI draai je dat om.
De AI-geoptimaliseerde structuur is de omgekeerde piramide uit de journalistiek:
- Hoofdpunt of conclusie
- Belangrijkste onderbouwing
- Voorbeelden en bewijs
- Aanvullende context
Coherent op elke diepte
Het voordeel: elke extractiediepte levert bruikbare content.
Een ondiepe extractie pakt het hoofdpunt en de primaire onderbouwing. Een middeldiepe pakt daar de kernvoorbeelden bij.
Een diepe extractie krijgt de volledige behandeling met nuance. Op elk niveau blijft het coherent.
Maak verbanden expliciet
Vergelijk: “Dit verlaagt de kosten. Organisaties kunnen budget herverdelen” overleeft een extractie minder goed dan “Deze kostenverlaging laat organisaties budget verschuiven van onderhoud naar groei”.
Meer over zinnen die een model graag overneemt, lees je in citatiewaardige content schrijven voor AI.
Welke structurele patronen passen bij elk contenttype?
Verschillende contenttypes vragen om verschillende patronen. Een paar bruikbare templates volgen hieronder.
Definitiepagina (“Wat is X”)
Start met een heldere definitie in de eerste alinea. Daarna volgen “Hoe X werkt”, “Voordelen van X”, “Voorbeelden van X”, “X versus Y” en “Aan de slag met X”.
Zo anticipeer je op de vragen van iemand die het begrip leert kennen.
Productpagina
H1 met korte omschrijving, eerste alinea met waardepropositie. Dan secties voor functies, werking, prijzen, vergelijking met alternatieven en use cases.
Elke sectie mikt op een andere zoekintentie.
How-to-pagina
Een overzicht met vereisten, daarna genummerde stappen (“Stap 1:”, “Stap 2:”). Elke stap krijgt instructies, verwacht resultaat en veelvoorkomende problemen.
Je sluit af met best practices en troubleshooting.
Vergelijkingspagina
Een overzicht per optie, dan een sectie per vergelijkingsdimensie. Tot slot “Wanneer kies je A” en “Wanneer kies je B”.
Een uitgewerkt voorbeeld is onze vergelijkingsmatrix van de bronvoorkeuren van AI-zoekmachines.
Leg patronen vast in templates
Werk je met veel gelijkaardige pagina’s? Leg de patronen dan vast in templates. Dat geeft consistentie, efficiëntie en kwaliteitscontrole.
Vuistregel: optimaliseer het template één keer en de verbetering verspreidt zich over alle pagina’s.
Hoe helpen lijsten, tabellen en andere signalen?
Lijsten en tabellen zijn krachtige extractiehulpmiddelen omdat ze duidelijke itemgrenzen geven.
Lijsten en tabellen
Kies het juiste type:
- bulletlijsten voor ongeordende items
- genummerde lijsten waar volgorde telt
- definitielijsten voor term-betekenisparen
Een tabel met heldere kolomkoppen maakt zowel vergelijking als celspecifieke extractie mogelijk, zolang elke cel genoeg context bevat om alleen te staan.
| Aspect | AI-vriendelijke structuur | Rommelige structuur |
|---|---|---|
| Koppen | Beschrijvend, query-gericht | Generiek (“Overzicht”) |
| Eerste alinea | Substantieel, zelfstandig | Inleiding zonder inhoud |
| Sectielengte | 200 tot 500 woorden | Te kort of te lang |
| Verbanden | Expliciet benoemd | Impliciet, “zoals gezegd” |
Vet, callouts en blockquotes
Daarnaast helpen kleinere signalen. Gebruik vetgedrukte tekst alleen voor genuanceerd belangrijke termen, want overal vet verdunt het signaal.
Callouts en blockquotes signaleren extra belangrijke inhoud.
Schema markup
Vergeet schema markup niet. Gestructureerde data verklaart je opbouw machineleesbaar en haalt giswerk weg, want Google gebruikt die data om de inhoud van een pagina te begrijpen.
Of je markup klopt, check je in de Schema Markup Validator. Kijk naar de teller met fouten en waarschuwingen:
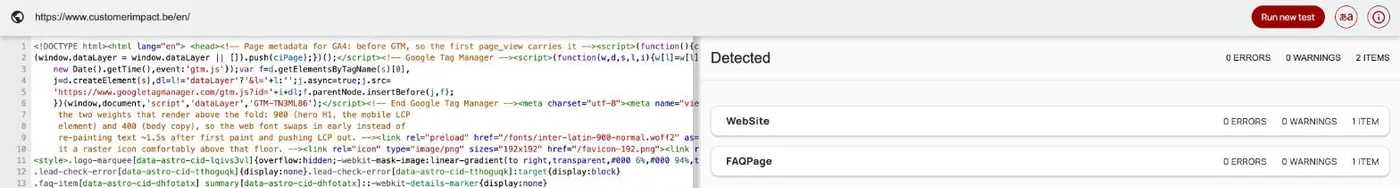 Schema Markup Validator op onze eigen pagina customerimpact.be/en/, oktober 2026: 0 fouten en 0 waarschuwingen.
Eén kanttekening: voor AI Overviews en AI Mode is volgens Google geen speciale schema.org-markup nodig. Wel gestructureerde data die overeenkomt met de zichtbare tekst.
Hoe je dat opzet, beschrijf ik in hoe je JSON-LD toevoegt. Voor FAQ-blokken specifiek: zie FAQPage-schema voor AI.
Hoe audit je je content-architectuur?
Met een checklist per pagina, gevolgd door een echte extractietest.
De checklist
Loop per belangrijke pagina deze punten af:
- een heldere H1
- logische H2-secties
- beschrijvende en query-gerichte koppen
- substantiële eerste alinea’s
- zelfstandige secties van passende lengte
- lijsten en tabellen waar nuttig
- schema markup
Een bredere lijst voor de hele site vind je in de AI-ready website checklist.
Test de extractie echt
Stel vragen die jouw pagina zou moeten beantwoorden. Kijk wat een AI-model citeert en beoordeel of die passages coherent en volledig zijn.
Perplexity is daar handig voor, omdat het bij elke bullet een bronlabel toont:
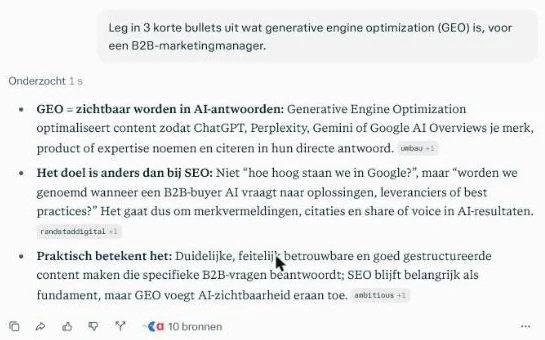 Perplexity met een gratis account, 17 oktober 2026: een bronlabel bij elke bullet en 10 bronnen in totaal.
Klik op een label en je ziet welke passage het model overnam.
Vergelijk met wie wél geselecteerd wordt
Vergelijk ten slotte met concurrenten die wél geselecteerd worden:
- Hoe verschillen hun koppen?
- Welke secties hebben zij die jij mist?
Wil je dat systematisch doen, lees dan citation mining: AI-citaties meten.
Structuur en compressie werken samen
Structuur zonder compressie geeft navigeerbare maar niet-extraheerbare content. Compressie zonder structuur geeft extraheerbare maar onvindbare content.
Optimaliseer ze samen, verifieer op elk niveau, en itereer op basis van extractietests.
Hoe vaak je die content daarna moet verversen, lees je in content freshness voor B2B en AI.
Veelgestelde vragen
Wat is content-architectuur voor AI-extractie precies?
Het is de discipline van het structureel opbouwen van pagina’s zodat AI-systemen de inhoud efficiënt kunnen navigeren en extraheren.
Het draait om koppen, sectiegrenzen, hiërarchie en volgorde: de signalen die een model nodig heeft om te begrijpen waar welke informatie staat.
Goed schrijven gaat over leesbaarheid, content-architectuur gaat over navigeerbaarheid voor machines.
Waarom krijgt de eerste alinea na een kop zoveel aandacht?
Navigeert een AI op basis van de kop naar een sectie, dan gebruikt het de eerste alinea om de relevantie te bevestigen en de eerste inhoud te halen.
Is die alinea sterk en zelfstandig, dan wordt hij vaak geciteerd. Is hij zwak of vol overgangstaal, dan haakt het model af.
Daarom zet je je kernboodschap meteen vooraan, niet na een inleiding.
Hoe lang moet een sectie idealiter zijn?
Voor de meeste hoofdsecties werkt 200 tot 500 woorden goed. Korter mist informatiedichtheid en levert te weinig om te extraheren.
Veel langer wordt moeilijk coherent te citeren. Breek lange onderwerpen op in subsecties met eigen H3-koppen, zodat elk stuk een nette extractie-eenheid blijft.
Heb ik schema markup nodig als mijn koppen al kloppen?
Niet specifiek voor AI-functies: Google zegt dat er geen speciale optimalisaties of schema nodig zijn om in AI Overviews of AI Mode te verschijnen.
Schema helpt machines wel om paginatypes zoals producten te lezen. Het is een aanvulling op goede architectuur, geen vervanging ervan.
Hulp nodig?
Wil je dit vertalen naar uitvoering? Bekijk hoe we dit aanpakken met AI-vindbaarheid.
Of neem contact op en we lopen samen je belangrijkste pagina door.
100 GEO-tips om genoemd te worden in ChatGPT en Google AI
- 10 hoofdstukken:van robots.txt en Bing tot meten
- Copy-paste:regex voor Search Console en GA4
- Sjablonen:koopvragen per fase en een 30-dagenplan
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.