
SEO & GEO
Het grounding snippet extraction framework: snippets meten en optimaliseren

Kopieer voor AI
Het grounding snippet extraction framework toont welke passages van je pagina AI echt gebruikt.
Het reverse-engineert exact welke zinnen uit je content in AI-antwoorden terechtkomen.
Zo wordt de black box een systeem dat je kunt begrijpen en bijsturen.
Het verdict: GEO (generative engine optimization) op paginaniveau is grof. Dit framework brengt je naar het snippetniveau, waar de selectiebeslissingen vallen.
Een voorbeeld uit de praktijk maakt het concreet.
Als ik aan een klant laat zien dat zijn pagina geciteerd wordt in ChatGPT, is dat goed nieuws. Hij haalde de selectie.
Maar dan stel ik de vraag waar het echt om draait: welke woorden hebben ze precies gebruikt?
Zijn pagina telt 2.500 woorden over twaalf secties. Het AI-antwoord is 400 woorden, gesynthetiseerd uit zes bronnen.
Ergens in die synthese zit zijn bijdrage. Maar welke zin? Welke sectie? Welke passage overtuigde het model?
Zonder dat antwoord is optimaliseren gokwerk.
Dit artikel is een verdiepend onderdeel van de ultieme GEO-handleiding.
Test je AI-zichtbaarheid: scoor je pagina in een halve minuut met onze GEO-check.
Waarom is citatie zonder extractie-inzicht onvoldoende?
Omdat je dan wel weet dat je geciteerd werd, maar niet wat er gebruikt is.
Het gevolg: je optimaliseert de verkeerde dingen.
Drie schoten in het donker
Zolang je niet weet welke passage werd geselecteerd, is elke aanpassing een gok:
- Je herschrijft je inleiding, terwijl het model uit sectie acht extraheerde.
- Je voegt diepgang toe aan je definitie, terwijl het model enkel je statistiek wilde.
- Je herstructureert de hele pagina, terwijl één paragraaf al het werk deed.
Citeren is niet hetzelfde als gebruiken
AI-systemen bekijken meer bronnen dan ze uiteindelijk inzetten.
De documentatie van xAI maakt dat verschil expliciet. Kijk naar het onderscheid tussen alle bekeken URL’s en wat in het eindantwoord belandt:
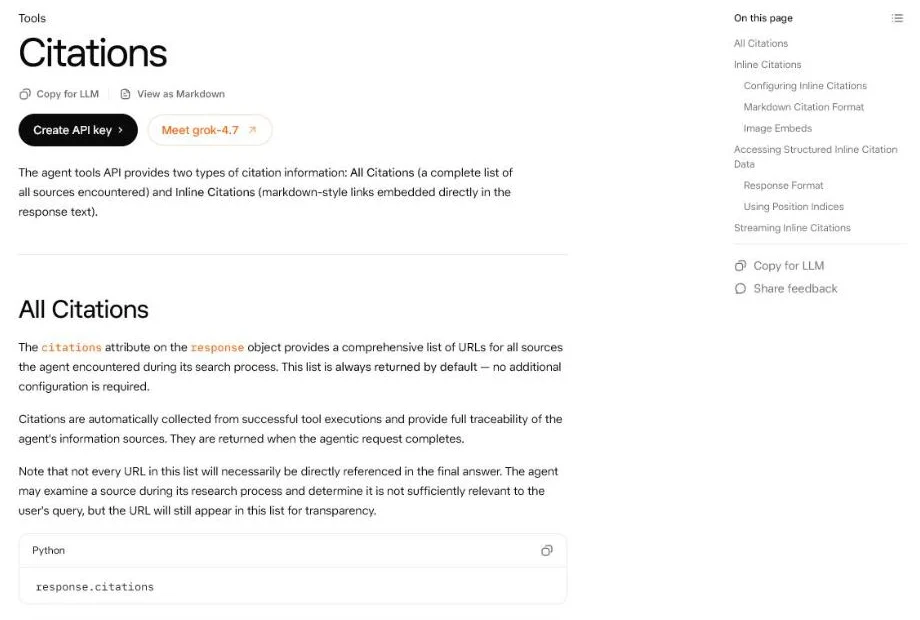 De documentatie van xAI over citaties (Engelse interface), oktober 2026. Een bekeken bron kan alsnog afvallen als niet relevant genoeg.
Een URL in de bronnenlijst bewijst dus niet dat je tekst het antwoord droeg.
Precisie maakt het verschil
Wie wél kan identificeren welke tekst werd geextraheerd, krijgt precisie.
En precisie is wat optimalisatie van toeval naar systeem tilt.
Dit bouwt voort op de basis van grounding snippets.
Dat artikel legt uit wát een grounding snippet is. Dit framework gaat over het meten en sturen ervan.
Wat legt extractieanalyse bloot?
Patronen per sectie, kenmerken van winnende passages en de koppeling tussen vraag en passage.
Zodra je ziet welke fragmenten worden gebruikt, wordt je content meteen begrijpelijker.
Extractiepatronen per sectie
De eerste vraag: welke secties worden het vaakst geextraheerd?
In de praktijk is de waarde meestal sterk geconcentreerd. Een illustratief verdelingsbeeld (voorbeeldcijfers, geen benchmark):
| Sectie | Extractiefrequentie |
|---|---|
| Definitie (paragraaf 1) | 73% |
| Feature-vergelijking (sectie 4) | 45% |
| Procesoverzicht (sectie 2) | 38% |
| Case-fragment (sectie 7) | 22% |
| Prijssamenvatting (sectie 8) | 18% |
| Inleiding | 4% |
| Conclusie | 2% |
In dit voorbeeld doet de definitieparagraaf het zware werk. Inleiding en conclusie zijn voor AI-extractie zo goed als onzichtbaar.
Uitgezet als staafdiagram springt die concentratie meteen in het oog. Een handvol secties trekt vrijwel alle extracties naar zich toe:
Dat patroon kun je op je eigen pagina’s meten en er naar handelen.
Kenmerken van geextraheerde passages
Geextraheerde en niet-geextraheerde passages verschillen systematisch. Wat de winnende fragmenten gemeen hebben:
- Korter: compacte alinea’s in plaats van lange, uitwaaierende secties.
- Zelfstandig leesbaar: ze slaan nergens op zonder de omringende tekst.
- Data-rijk: ze bevatten concrete cijfers of feiten.
- Direct geformuleerd: stellingen zonder slagen om de arm.
- Entiteit expliciet benoemd: het product of merk staat er letterlijk in.
Niet-geextraheerde passages zijn langer, contextafhankelijk en vager. Ze leunen op de zinnen eromheen.
Dit is precies de logica achter content-architectuur voor AI-extractie. Je schrijft fragmenten die los van hun context overeind blijven.
Query-passage mapping
Verschillende vragen extraheren verschillende passages:
| Querytype | Haalt meestal op |
|---|---|
| ”Wat is”-vraag | Je definitieparagraaf |
| ”Hoe werkt”-vraag | Je procesoverzicht |
| Vergelijkingsvraag | Je comparatietabel |
| Prijsvraag | Je prijssamenvatting |
Ken je die mappings, dan optimaliseer je per querytype gericht. Je hoeft niet meer de hele pagina te willen verbeteren.
Dat is ook waarom koppen helpen.
Een kop die de vraag letterlijk stelt, maakt de mapping makkelijker, zie koppen als vragen voor AI-extractie.
Goed om te weten: Google zegt dat AI Overviews en AI Mode “query fan-out” kunnen gebruiken, door “issuing multiple related searches across subtopics and data sources” (Google Search Central).
Eén gebruikersvraag kan dus meerdere deelvragen opleveren, elk met een eigen passage. Meer daarover in wat query fan-out is.
Wat zijn de vier identificatiemethodes?
Direct tekst matchen, semantische gelijkenis, claim-level tracing en structurele alignment.
Geen enkele methode is op zich waterdicht. Ze werken het beste samen.
1. Direct tekst matchen
Je vergelijkt de antwoordtekst met je broncontent en zoekt overeenkomende passages.
Het probleem: AI parafraseert vaak in plaats van letterlijk te citeren. Kleine woordwijzigingen breken een exacte match.
Fuzzy matching en het herkennen van unieke kernzinnen vangen dat deels op.
2. Semantische gelijkenis
Je segmenteert het antwoord en je pagina. Je zet beide om in vectoren via een embeddingmodel en berekent de cosinusgelijkenis.
Hoge scores wijzen op een extractierelatie.
Dit verdraagt parafrasering, omdat het betekenis vergelijkt en niet letters.
Wat embeddings zijn, lees je in embeddings voor marketeers en wat vectorzoeken is.
3. Claim-level tracing
Je isoleert elke afzonderlijke bewering in het antwoord. Daarna zoek je op je pagina de passage die die claim het sterkst ondersteunt.
Bijvoorbeeld: een antwoord dat “60% snellere integratie” claimt, leidt je naar de passage met exact dat cijfer.
Niet naar de vagere variant die “40% minder tijd” zegt.
4. Structurele alignment
Je herkent structuurelementen in het antwoord (lijsten, definities, stappen). Die koppel je aan dezelfde structuren in je content.
Een driepuntslijst in het antwoord die overeenkomt met je sectie “Belangrijkste voordelen” met drie bullets, verraadt de bron.
De cross-encoder als scherpste losse methode
Een cross-encoder verdient een aparte vermelding.
Embeddingmodellen verwerken query en passage los. Een cross-encoder voedt beide samen en geeft één relevantiescore terug.
Daardoor vangt hij interactie-effecten die de accuraatheid flink opkrikken.
Modellen getraind op zoekrelevantie hebben patronen geleerd die sterk lijken op wat AI-zoeksystemen bij hun selectie gebruiken.
Denk aan MS MARCO, opgebouwd uit echte Bing-zoekopdrachten.
| Methode | Sterk in | Zwak in |
|---|---|---|
| Direct tekst matchen | Letterlijke citaten | Parafrases |
| Semantische gelijkenis | Parafrases | Scherpe onderscheiden tussen bijna gelijke passages |
| Claim-level tracing | Cijfers en feiten | Verhalende tekst |
| Structurele alignment | Lijsten, stappen, tabellen | Doorlopende alinea’s |
Vuistregel: leg minstens twee methodes naast elkaar en verzoen de resultaten.
Welke extractiemetrics doen ertoe?
Vier metrics sturen je optimalisatie, plus één die we het vaakst gebruiken: citation coverage.
De vier basismetrics
- Extraction rate: het percentage citaties waarbij ook echt content van jou werd gebruikt.
- Content utilization: welk percentage van je content wordt geextraheerd.
- Passage concentration: hoe sterk extracties zich op één sectie concentreren.
- Extraction stability: hoe consistent dezelfde passages worden geextraheerd over de tijd.
Een pagina kan geciteerd worden zonder dat er één woord uit werd geextraheerd.
Dan stond je URL erbij, maar leverde een andere bron de inhoud.
Bijvoorbeeld: heeft je pagina 10.000 tekens en wordt er gemiddeld 800 gebruikt, dan zit je op 8% utilization.
Lage benutting wijst op contentbloat, slechte structuur of mismatch met de queries.
Komt 80% van de extracties uit één sectie, dan doet die sectie al het werk. De andere liggen braak.
Lage stabiliteit kan duiden op content vlak bij de selectiedrempel. Of op veranderend modelgedrag.
Citation coverage
De metric waar ik het vaakst naar kijk, is citation coverage. Welk percentage van je pagina-inhoud verschijnt in AI-antwoorden wanneer je geciteerd wordt?
Een publieke benchmark bestaat daar nog niet voor. Meet dus eerst je eigen nulmeting en vergelijk pagina’s onderling.
De banden hieronder zijn onze werkregel, geen sectordata:
| Citation coverage | Interpretatie |
|---|---|
| Onder 20% | Het meeste is onzichtbaar voor AI: bloat, slechte structuur of mismatch. |
| 20 tot 50% | Redelijke efficiëntie, met ruimte voor verbetering. |
| Boven 50% | Hoogefficiënte, dichte en goed afgestemde content. |
Het streefdoel hangt af van je contenttype:
- Definitiecontent: 60% of meer
- How-to-gidsen: 40 tot 50%
- Uitgebreide gidsen: 30 tot 40%
Let op: optimaliseer coverage nooit ten koste van leesbaarheid voor mensen. Sommige content dient de lezer en niet de extractie, en dat is prima.
Wil je dezelfde meting over meerdere modellen leggen? Zie cross-model analyse voor GEO.
Hoe ga je van analyse naar snippet-optimalisatie?
Kies de passages die het meest opleveren en versterk ze gericht.
Inzicht zonder actie is waardeloos.
Drie soorten passages die optimalisatie verdienen
De analyse legt deze passages bloot:
- Fragmenten die wél worden opgehaald maar zelden geselecteerd: ze zitten net onder de drempel.
- Fragmenten gekoppeld aan commercieel waardevolle queries.
- Fragmenten waar concurrenten in jouw plaats worden geextraheerd.
Vier technieken
Voor elk type passen technieken die de meetdata logisch maken:
- Maak het fragment zelfstandig: schrap voornaamwoorden die naar elders verwijzen en benoem de entiteit expliciet.
- Verhoog de informatiedichtheid: weg met vulzinnen, erbij met concrete datapunten.
- Versterk het directe antwoord: begin met de kerninformatie, volledig in zo weinig mogelijk woorden.
- Voeg unieke waarde toe: eigen cijfers, een eigen kader of een concreet voorbeeld dat de concurrent niet heeft.
Hoe je dichter schrijft zonder leesbaarheid te verliezen, staat in semantic compression: schrijven voor AI.
De competitieve vergelijking
Zet je passage naast die van een concurrent, voor een query die je verliest.
Vaak zie je het meteen.
De winnaar heeft een specifieke metric, een concreet vergelijkingspunt en een expliciete productnaam. Jouw versie blijft vager en algemener.
Die observaties worden je optimalisatie-checklist.
Wie de meting koppelt aan citation mining, sluit de lus.
Meten welke citaties je krijgt, herleiden welk fragment ze opleverde en dat fragment gericht versterken.
Begin klein
Begin niet meteen met een volledige pipeline. Een minimale aanpak werkt al:
- Verzamel 20 tot 30 AI-antwoorden die je content citeren.
- Vergelijk de antwoordtekst handmatig met je pagina.
- Noteer welke secties worden geextraheerd.
- Vorm hypotheses over wat de selectie drijft.
- Pas je content aan en kijk wat verschuift.
Citerende antwoorden verzamel je bijvoorbeeld in Perplexity. Open onder het antwoord het bronnenpaneel en noteer welke bron welke zin draagt:
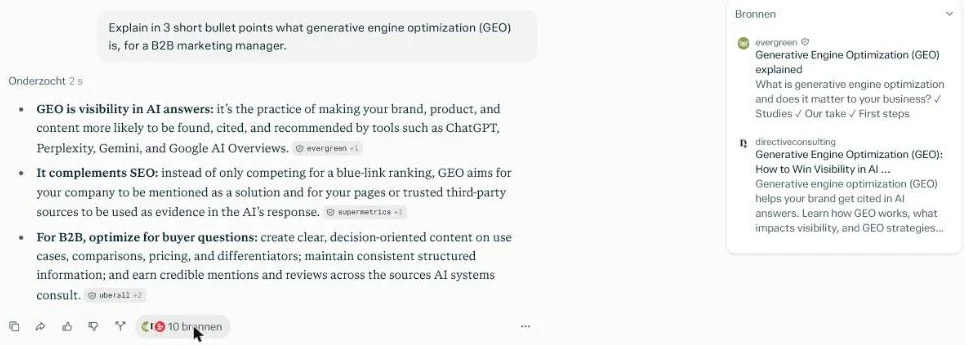 Het bronnenpaneel van Perplexity (Engelse interface), oktober 2026: tien bronnen achter één antwoord.
Hoe je in Perplexity zelf zichtbaar wordt, lees je in gevonden worden in Perplexity.
Pas wanneer het patroon zich bewijst, is het de moeite om capture, matching en rapportage te automatiseren.
Veelgestelde vragen
Wat is het verschil tussen een citatie en een extractie?
Een citatie betekent dat je URL in het AI-antwoord wordt vermeld als bron. Een extractie betekent dat er ook daadwerkelijk tekst van jou in het antwoord verwerkt zit. Die twee vallen niet altijd samen: een model kan je pagina citeren maar de inhoud uit een andere bron halen. De extraction rate meet precies hoe vaak een citatie zich vertaalt naar echt gebruikte content.
Hoe accuraat kun je reconstrueren welk fragment werd geextraheerd?
Dat hangt af van de methode, en voor precies deze taak bestaan geen gepubliceerde nauwkeurigheidscijfers. Exact tekst matchen mist per definitie parafrases, semantische gelijkenis vangt ze op, en een cross-encoder is meestal de scherpste losse methode. Een gecombineerde aanpak, waarbij je meerdere methodes naast elkaar legt en de resultaten met elkaar verzoent, is het betrouwbaarst. Feitelijke en gestructureerde content reconstrueert betrouwbaarder dan verhalende tekst.
Welke metric volg ik het best als ik begin?
Begin met citation coverage en extraction rate. Coverage vertelt je welk deel van je pagina überhaupt zichtbaar is voor AI, en de extraction rate of je citaties zich vertalen naar echt gebruikte inhoud. Samen geven ze je het snelste zicht op of het probleem bij de zichtbaarheid of bij de inhoudelijke benutting van je content ligt.
Verandert het extractiepatroon na verloop van tijd?
Ja, en daar moet je rekening mee houden. Voor identieke content kan de extraction rate dalen naarmate de pagina veroudert, een teken van freshness-factoren. Daarnaast kunnen modelupdates, contentwijzigingen bij concurrenten of een verschuivende querybedoeling ervoor zorgen dat dezelfde vraag plots een andere passage ophaalt. Dat pleit voor regelmatige content refresh en periodieke hermeting.
Hulp nodig?
Wil je dit vertalen naar uitvoering? Bekijk hoe we dit aanpakken met AI-vindbaarheid.
Wil je eerst weten hoe vaak AI-antwoorden je merk al noemen? Lees dan hoe je AI share of voice meet.
100 GEO-tips om genoemd te worden in ChatGPT en Google AI
- 10 hoofdstukken:van robots.txt en Bing tot meten
- Copy-paste:regex voor Search Console en GA4
- Sjablonen:koopvragen per fase en een 30-dagenplan
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.