
SEO & GEO
Citation mining: je AI-citaties systematisch meten
 Tanguy De Keyzer Oprichter & digitale strateeg · Bijgewerkt 12 november 2026 · ◷ 13 min leestijd
Kopieer voor AI
Citation mining is AI-citaties systematisch verzamelen, tellen en vergelijken.
Als ik klanten vertel dat een AI-model elke dag miljoenen keuzes maakt over welke bronnen zichtbaarheid verdienen, knikken ze.
Als ik dan vraag welke bronnen voor hun categorie worden geciteerd, valt het stil.
De meeste bedrijven vliegen blind. Ze stellen af en toe een vraag aan ChatGPT, zien toevallig een citatie en vormen daar een mening over.
Dat is geen meetmethode, dat is gokwerk.
Het verdict: citation mining lost dat op. Een vaste set vragen, periodiek gemeten op meerdere platformen, levert harde cijfers over wie geciteerd wordt, waar en waarom.
Hieronder: wat het is, welke metrics je eruit haalt en hoe je het zelf opzet. Het hoort thuis in de ultieme GEO-handleiding, waarin ik het volledige speelveld van generative engine optimization (GEO) beschrijf.
Test je AI-zichtbaarheid: scoor je pagina in een halve minuut met onze GEO-check.
Wat is citation mining?
Het systematisch extraheren en analyseren van de citaties die AI-systemen in hun antwoorden tonen.
Elke keer dat een model een bron aanhaalt, is dat een oordeel: dit stuk content verdient zichtbaarheid voor deze vraag.
Verzamel en orden je duizenden van die oordelen, dan ontstaat een rijke informatiebron.
Waar citaties vandaan komen
Niet elk AI-antwoord heeft citaties. Ze verschijnen wanneer een systeem het web doorzoekt voor het antwoordt.
Perplexity zegt bijvoorbeeld dat het het internet doorzoekt en elk antwoord voorziet van genummerde citaties naar de originele bronnen.
Google beschrijft hoe AI Overviews en AI Mode meerdere verwante zoekopdrachten uitvoeren over subonderwerpen, en zo een bredere set ondersteunende pagina’s tonen.
Zo ziet zo’n bronnenlijst eruit:
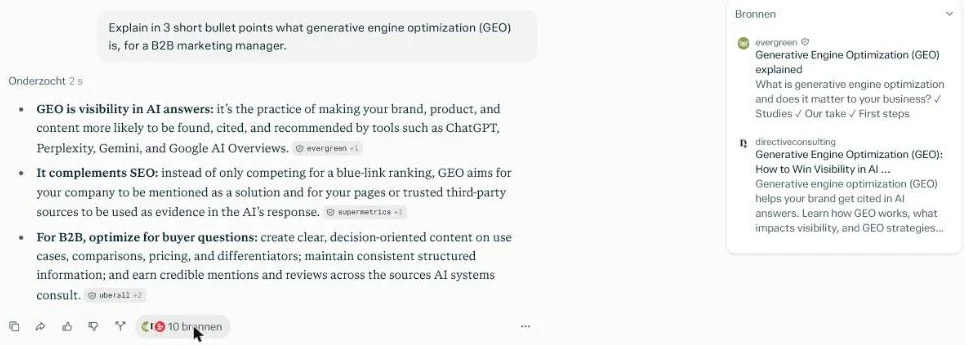 De 10 bronnen achter het antwoord van Perplexity, één klik vanaf de voettekst, oktober 2026.
Elke rij in dat paneel is een datapunt voor je database. Wat een model niet zoekt, maar uit zijn training haalt, meet je apart met brand salience.
Wat de data je vertelt
Die data vertelt je:
- Welke domeinen AI-systemen vertrouwen voor welke onderwerpen.
- Welke specifieke pagina’s de selectie winnen voor concurrerende vragen.
- Hoe citatiepatronen verschuiven in de tijd.
- Waar je staat ten opzichte van je concurrenten.
- Welke contentkenmerken samenhangen met selectie.
Methode in plaats van indruk
Het verschil met losse waarnemingen is methode.
In plaats van te onthouden dat je “een keer geciteerd werd door Perplexity”, meet je structureel hoe vaak en hoe prominent je verschijnt, en wie je verslaat.
Wat laat de data je zien?
Patronen die je anders nooit ziet.
Wanneer ik citaties voor een onderwerp aggregeer, komen er drie soorten inzicht naar boven.
Domein-autoriteit
Tel je alle citaties voor een onderwerp, dan zie je meteen wie domineert.
Vaak zijn dat de usual suspects (Google, Microsoft, AWS) plus een of twee gespecialiseerde spelers die autoriteit hebben opgebouwd.
Sta jij op 2 procent share, dan weet je dat er werk aan de winkel is, en met welke partijen je het opneemt.
Winnaars per vraag
Binnen een onderwerp hebben verschillende vragen verschillende winnaars:
- Definitievragen (“wat is X?”) citeren encyclopedische bronnen.
- Vergelijkingsvragen (“beste X tools 2026”) citeren reviewsites.
- Implementatievragen citeren documentatie.
Die nuance bepaalt waar je realistisch kunt winnen. Het heeft geen zin om Wikipedia uit te dagen op een definitievraag als je beter scoort op de implementatiehoek.
Welke engines welke brontypes verkiezen, zie je in de matrix van bronvoorkeuren per AI-zoekmachine.
Contentkenmerken
Door geciteerde pagina’s te ontleden, zie je wat modellen waarderen. Denk aan gemiddelde lengte, kopjesdichtheid, gebruik van lijsten, recentheid van de laatste update en schema-opmaak.
Citeren modellen vooral pagina’s die recent zijn bijgewerkt, terwijl jouw artikel twee jaar oud is? Dan heb je een concrete, meetbare actie te pakken.
Zie die verbanden wel als correlaties, niet als oorzaken. Voor AI Overviews en AI Mode zegt Google dat je geen speciale optimalisatie of aparte schema-opmaak nodig hebt: gewone SEO-basics blijven de basis.
Hoe je die kenmerken in je eigen pagina’s stopt, lees je in citatiewaardige content schrijven voor AI.
Welke metrics doen ertoe?
Vijf cijfers die je over de tijd volgt.
Citation mining levert pas waarde als je het vertaalt naar cijfers. Dit zijn de formules die ik gebruik, gebaseerd op het bronmateriaal.
| Metric | Formule | Wat het meet |
|---|---|---|
| Citation share | jouw citaties / totale citaties | Je aandeel van alle citaties binnen een queryset |
| Citation frequency | vragen waarin geciteerd / totaal aantal vragen | Hoe vaak je überhaupt opduikt |
| Primary citation rate | primaire citaties / totale citaties | Hoe vaak je de hoofdbron bent als je geciteerd wordt |
| Citation velocity | (citaties nu - citaties vorige periode) / citaties vorige periode | De snelheid waarmee je positie verandert |
| Competitive citation index | jouw citaties / citaties concurrent | Of je vaker of minder vaak geciteerd wordt dan een rivaal |
Rekenvoorbeeld
Stel: je meet 200 vragen en die leveren samen 1.000 citaties op. Jij krijgt er 40, verspreid over 30 vragen.
Dan is je citation share 4% (40 van 1.000) en je citation frequency 15% (30 van 200).
Had je de vorige maand 32 citaties, dan is je citation velocity +25%. Heeft je grootste concurrent er 80, dan is je competitive citation index 0,5.
Hoe lees je de combinaties?
Een paar interpretaties die ik belangrijk vind:
- Hoge frequency, lage share: je duikt vaak op maar zelden prominent. Aanwezig, niet dominant.
- Lage frequency, relatief hoge share: je verschijnt zelden, maar dan domineer je. Breid je dekking uit.
- Citation velocity: je vroegtijdige waarschuwingssysteem. Negatief betekent positieverlies voor het in je traffic zichtbaar wordt.
- Competitive citation index: boven 1 word jij meer geciteerd dan de concurrent, onder 1 leiden zij.
Volg die index tegen meerdere rivalen voor een compleet beeld.
Hoe dit past in de bredere KPI’s
Deze citatiemetrics zijn een verdieping van de 5 kernindicatoren van AI-zichtbaarheid, zoals prompt recall rate.
Waar prompt recall rate meet of je überhaupt genoemd wordt, zoomt citation mining in op de bron-attributie zelf. Je aandeel tegenover concurrenten bundel je in AI share of voice.
Onze ervaring: we meten onze eigen site per engine apart, want de cijfers lopen sterk uiteen. Zo ziet dat eruit:
Perplexity noemt Customer Impact nu in 16 van 125 bureauvragen, tegen 7 voor de start. In Google AI Overviews gingen we van 0 citaties in tien maanden naar 24 van juli tot september 2026.
Vuistregel: tel nooit engines bij elkaar op. Elk platform krijgt zijn eigen reeks.
Hoe meet je het: het proces stap voor stap
Je hoeft geen zware infrastructuur te hebben om te starten. Discipline is belangrijker dan tooling.
Dit is de werkwijze die ik aanhoud.
Stap 1: definieer je querycorpus
Bepaal welke vragen je wilt volgen. Een goede corpus mengt drie types:
- Kernvragen over je merk en producten (“wat is [product]?”, “[merk] review”, “[merk] vs. [concurrent]”).
- Categorievragen waar je zichtbaarheid wilt (“beste [categorie] software”, “hoe [categorie-taak] aanpakken”).
- Intentievragen rond de problemen die je oplost (“hoe los ik [probleem] op?”, “[pijnpunt] oplossingen”).
Mik op 100 tot 500 vragen, afhankelijk van je markt.
Tip: haal echte zoekopdrachten uit Google Search Console. Het prestatierapport groepeert je data per zoekopdracht die gebruikers effectief typten. Zet ze om naar conversationele vorm.
Dat zijn de queries die mensen werkelijk stellen. Zo ziet zo’n lijst eruit voor één pagina:
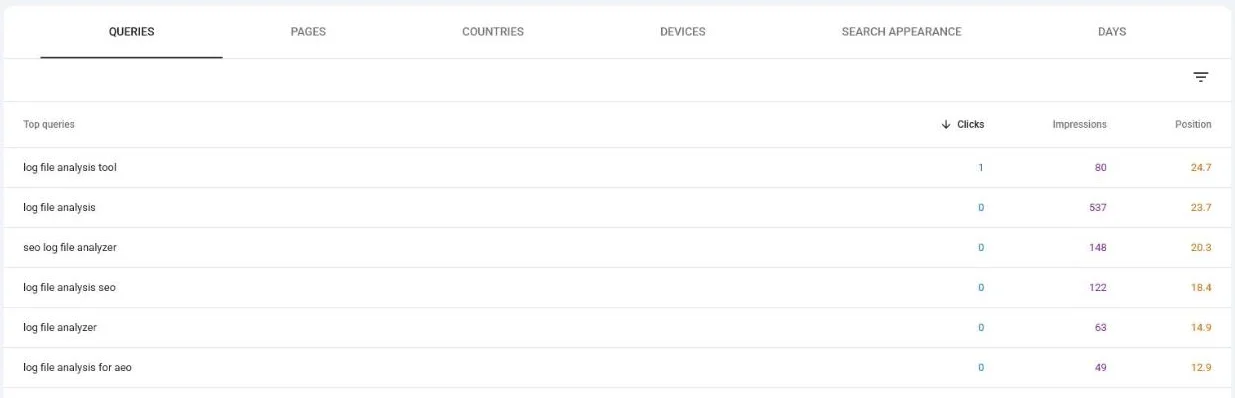 Zoekopdrachten voor één pagina in onze eigen Search Console, oktober 2026. Echte zoekopdrachten met vertoningen, voor een niche B2B-onderwerp.
Elke rij is een kandidaat-prompt. Meer methodes vind je in prompt-onderzoek: welke vragen stellen klanten aan ChatGPT en een promptset samenstellen.
Stap 2: voer de queries uit
Stel je vragen aan de relevante platformen: Google AI Mode, ChatGPT met search, Perplexity en Claude met search.
Leg per antwoord vast:
- De volledige antwoordtekst.
- Alle citaties (URL’s).
- De positie van elke citatie (in de tekst of in een bronnenlijst).
- Een tijdstempel en het platform.
Bepaal je frequentie naar belang: dagelijks voor concurrentie-intelligence, wekelijks voor trends, maandelijks als minimum voor een basislijn.
Hoe ChatGPT en Perplexity verschillend citeren, lees je in Perplexity vs ChatGPT.
Stap 3: extraheer de citaties
Haal uit elk antwoord de URL’s. Normaliseer ze naar domeinniveau (alle varianten van microsoft.com tellen samen), zodat je correct kunt aggregeren.
Beslis vooraf of je unieke of totale citaties telt wanneer dezelfde bron meermaals opduikt.
Let op: een bron die een systeem bekeek, staat niet altijd in het eindantwoord. De documentatie van xAI maakt dat onderscheid expliciet:
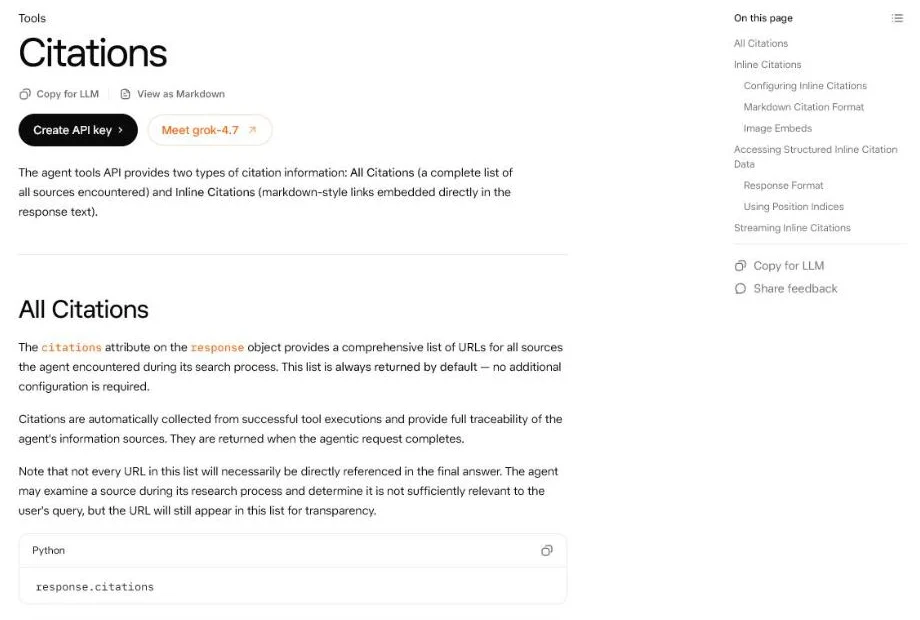 De documentatie van xAI over citaties (Engelse interface), oktober 2026. Een bekeken bron kan alsnog afvallen als niet relevant genoeg.
Tel dus alleen wat in het antwoord zelf staat, tenzij je bewust ook de bekeken bronnen wil volgen.
Stap 4: analyseer en bouw een database
Voor doorlopende intelligence sla je elke citatie gestructureerd op. Dit zijn de essentiële velden:
| Veld | Voorbeeld |
|---|---|
| Uniek ID | 000123 |
| Query en categorie | ”beste CRM voor kmo”, categorievraag |
| Platform en tijdstempel | Perplexity, datum en uur |
| Geciteerde URL en genormaliseerd domein | volledige URL plus domein |
| Positie en type citatie | inline of in de bronnenlijst |
| Primaire bron? | ja of nee |
| Grounding snippet | de tekstpassage die naar jouw pagina verwees |
Met die database draai je share-analyses, query-domein-mappings, trends en gap-analyses.
Een relationele database met indexering op je queries volstaat ruimschoots om te starten. Liever een tool? Vergelijk de opties in AI-zichtbaarheid tools en de beste GEO-tools.
Hoe ga je van snippets naar contentoptimalisatie?
Door de werkelijk geciteerde tekst te analyseren, niet alleen de URL’s.
Voor elke citatie kun je de grounding snippet terughalen: de exacte passage van je pagina die in het antwoord belandde. Meer over dat begrip in grounding snippets.
Wat modellen wel en niet extraheren
Doe je dat over veel citaties heen, dan zie je een duidelijk patroon:
- Wel: definities, statistieken, procesbeschrijvingen, vergelijkingen.
- Niet: inleidende vulling, marketingtaal, vage beweringen.
Een vaste methode om die passages te ontleden, vind je in het grounding snippet-extractieframework.
Citation coverage
Daar komt citation coverage bij kijken: het aandeel van een pagina dat daadwerkelijk geciteerd wordt. Je berekent het als geciteerde tekens gedeeld door het totaal aantal tekens.
Een pagina van 800 woorden waarvan 290 woorden worden geciteerd, haalt een hogere coverage dan een lijvige pagina van 2.400 woorden waarvan slechts 380 woorden worden opgepikt.
Hoge coverage wijst op efficiënte, extraheerbare content. Lage coverage verraadt opgeblazen tekst of een structuur waar het model niet doorheen komt.
Vuistregel: meer woorden levert niet vanzelf meer citaties op. Elke alinea moet iets zeggen dat een model kan overnemen.
Hoe ga je van intelligence naar actie?
Door de meetlus te sluiten.
Citation mining genereert inzicht, maar inzicht zonder actie is verloren moeite. Ik sluit altijd de lus:
- Identificeer een kans uit de data: vragen waar je nul citaties hebt maar zou moeten concurreren, of pagina’s met dalende citaties.
- Onderneem actie: maak nieuwe content, ververs verouderde pagina’s, of analyseer waarom een concurrent plots wint.
- Hermeet de citaties na verloop van tijd.
- Schrijf de verandering toe aan je actie.
- Verfijn je aanpak op basis van het resultaat.
Visueel ziet die meetlus er zo uit. Elke ronde vertrekt bij een kans en eindigt bij een verfijning die de volgende ronde scherper maakt:
Een passief rapport wordt een motor
Die lus maakt van citation mining geen passief rapport, maar een actieve optimalisatiemotor.
Wil je deze inzichten bundelen voor stakeholders? Lees dan hoe je een AI-zichtbaarheidsrapport maakt waarin citatiedata een centrale plek krijgt.
Voor de actiestap zelf helpt de AI-citatie-checklist voor B2B.
Veelgestelde vragen
Wat is het verschil tussen citation mining en gewone rank tracking?
Rank tracking meet posities in klassieke zoekresultaten. Citation mining meet welke bronnen AI-systemen aanhalen in hun gegenereerde antwoorden, inclusief de exacte passages die ze extraheren.
Het is een aparte discipline, omdat AI-antwoorden niet werken met tien blauwe links. Ze werken met een selectie van bronnen die in een samenhangend antwoord worden verweven.
Hoeveel queries heb ik nodig om te starten?
Voor een betekenisvol beeld mik je op 100 tot 500 vragen, afhankelijk van de breedte van je markt. Wil je gewoon beginnen, dan leg je met 25 tot 50 zorgvuldig gekozen prompts al een bruikbare basislijn.
Belangrijker dan het aantal is dat je dezelfde set herhaaldelijk meet, zodat je trends ziet in plaats van momentopnames.
Citeren alle AI-platformen op dezelfde manier?
Nee, en dat is precies waarom je per platform meet. Sommige systemen citeren meerdere bronnen per bewering, andere verkiezen één omvattende bron.
Sommige wegen recentheid zwaar, andere waarderen brondiversiteit. Sta je sterk op het ene platform maar zwak op het andere, dan is dat een platformspecifieke kans.
Moet ik dit zelf bouwen of een tool kopen?
Dat hangt af van je middelen. Bouw zelf als je diepe maatwerk-intelligence wilt, engineering-capaciteit hebt en dataeigendom cruciaal is.
Koop een tool als time-to-value telt en standaardfunctionaliteit volstaat. Een veelgebruikte tussenweg is hybride: een externe tool voor het verzamelen, en eigen analyses voor de concurrentie-intelligence die je voorsprong oplevert.
Hulp nodig?
Wil je weten welke bronnen AI vandaag citeert in jouw categorie, en waar jij ontbreekt? Wij zetten de eerste meting op.
Bekijk hoe we dit aanpakken met AI-vindbaarheid.
100 GEO-tips om genoemd te worden in ChatGPT en Google AI
- 10 hoofdstukken:van robots.txt en Bing tot meten
- Copy-paste:regex voor Search Console en GA4
- Sjablonen:koopvragen per fase en een 30-dagenplan
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.