
SEO & GEO
Wat is een foundation model? Uitleg voor B2B-marketeers

Kopieer voor AI
Een foundation model is een groot AI-model dat je voor veel taken kunt aanpassen.
Het is getraind op enorme, brede hoeveelheden data. Daarna stuur je het bij voor een specifieke toepassing.
Het verdict: je bouwt niet voor elke toepassing een nieuw model. Je vertrekt van één krachtig basismodel, en dat basismodel voedt ook de AI-zoekmachines waar je klanten hun vragen stellen.
Het bekendste voorbeeld is het large language model achter tools als ChatGPT.
Wat is een foundation model precies?
Een model dat breed getraind is en dat je daarna aanpast aan veel vervolgtaken.
Waar komt de term vandaan?
De term werd in 2021 geïntroduceerd door het Center for Research on Foundation Models van Stanford.
Hun definitie: een model getraind op brede data, meestal met self-supervision op grote schaal, dat je kunt aanpassen aan een breed scala van vervolgtaken. Aanpassen gebeurt bijvoorbeeld via fine-tuning.
Het rapport dat de term lanceerde, On the Opportunities and Risks of Foundation Models, verscheen in augustus 2021. Het telt 114 auteurs.
Als voorbeelden noemt het BERT, DALL-E en GPT-3.
Waarom “foundation”?
De kern zit in dat woord: fundament.
Je bouwt niet telkens opnieuw vanaf nul. Je vertrekt van een breed getraind basismodel dat al veel over taal, beeld of code heeft geleerd.
Daarna specialiseer je het.
Volgens IBM is dat de grote verschuiving: één krachtig, herbruikbaar model in plaats van honderden losse modellen voor losse taken.
De korte definitie staat ook in onze wiki over het foundation model.
Model per taak versus basismodel
De tabel zet de klassieke aanpak (een apart model per taak) naast de aanpak met een basismodel:
| Kenmerk | Model per taak (klassiek) | Basismodel (foundation model) |
|---|---|---|
| Training | Apart getraind voor elke taak | Eén keer breed voorgetraind |
| Data | Gelabelde data per toepassing | Enorme, grotendeels ongelabelde datasets |
| Kosten | Terugkerend per project | Dure pre-training één keer, daarna gedeeld |
| Aanpassen | Nieuw model bouwen | Fine-tunen of slim prompten |
| Veelzijdigheid | Eén nauwe taak | Veel uiteenlopende vervolgtaken |
Vuistregel: de dure stap gebeurt één keer, bij de maker. Iedereen daarna betaalt alleen voor het aanpassen.
Hoe werkt een foundation model in de praktijk?
In twee fasen: eerst breed leren, dan aanpassen aan één taak.
Fase 1: pre-training
Het model leert uit gigantische, ongelabelde datasets. Bijvoorbeeld een groot deel van het publieke internet.
Het pikt daarbij algemene patronen op, zonder specifiek doel.
Fase 2: aanpassen
Daarna stem je het model af op een concrete taak.
Dat gebeurt via fine-tuning op eigen data, of via slimme instructies. Zo’n instructie heet een prompt.
Waarom AI zo hard versnelde
Die aanpak verklaart waarom AI de laatste jaren zo hard versneld is.
Zodra een sterk basismodel bestaat, kunnen duizenden bedrijven erop voortbouwen. Zonder zelf de dure pre-training te doen.
Technisch steunt zo’n basismodel op deep learning. En dus op een neuraal netwerk met heel veel lagen.
Welke soorten foundation models bestaan er?
Taalmodellen, beeldmodellen en multimodale modellen.
Niet elk basismodel werkt met tekst. De bekendste categorieën:
- Taalmodellen. Een large language model is een basismodel voor tekst, zoals de GPT-reeks of Google Gemini.
- Beeldmodellen. Modellen die afbeeldingen genereren of herkennen, zoals DALL-E uit het Stanford-rapport.
- Multimodale modellen. Een multimodaal model verwerkt meerdere soorten input tegelijk: tekst, beeld en geluid.
Wat ze delen: ze zijn breed getraind en veelzijdig inzetbaar, in plaats van gebouwd voor één nauwe taak.
Dezelfde vraag, verschillende modellen
Verschillende makers bouwen verschillende basismodellen. Dat zie je aan de antwoorden.
We stelden ChatGPT, Claude en Gemini in oktober 2026 dezelfde vraag over GEO. Kijk naar de vorm van het antwoord in ChatGPT:
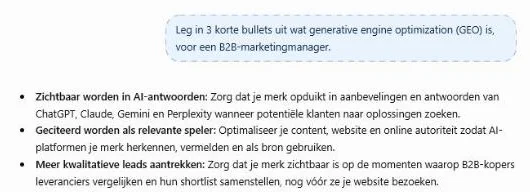 ChatGPT gratis (tijdelijke chat), 17 oktober 2026: drie bullets, ongeveer 70 woorden, geen bronnen.
Claude gaf op dezelfde vraag een langer antwoord:
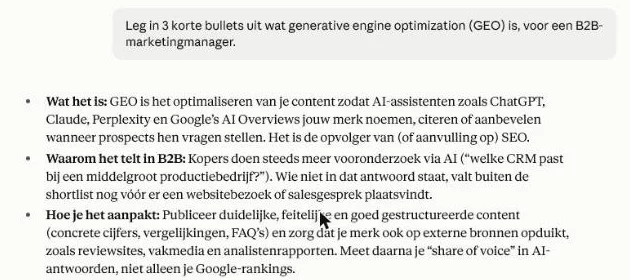 Claude, 17 oktober 2026, getest op een betaald plan in een incognitochat: drie bullets, ongeveer 130 woorden, geen bronnen.
Ongeveer 70 woorden tegenover ongeveer 130. Elk basismodel heeft zijn eigen stijl en lengte.
Hoe die tools verder verschillen, lees je in ChatGPT vs Claude vs Gemini.
Hoe ziet een foundation model eruit in de B2B-praktijk?
Als een bestaande AI-tool die je voedt met je eigen toon en productinfo.
Stel: een B2B-marketingteam wil sneller productbeschrijvingen en e-mails opstellen in de eigen huisstijl.
Ze trainen daarvoor geen model van nul.
Zo pakt het team het aan
Ze werken in drie stappen:
- Ze kiezen een bestaand basismodel in een AI-schrijftool.
- Ze voeden het met hun eigen toon, voorbeelden en productinfo.
- Ze sturen bij via slimme instructies of lichte fine-tuning.
Binnen enkele dagen schrijft de tool teksten die klinken alsof het team ze zelf maakte.
Waar de waarde zit
Dat is de belofte van deze technologie. De zware, dure basis is al gelegd door de makers van het model.
Het bedrijf plukt de vruchten met een fractie van de moeite.
Wat we in de praktijk zien: de waarde zit niet in het model zelf, maar in hoe scherp je het voedt met eigen data en context.
Waarom gaat een foundation model jou als B2B-marketeer aan?
Omdat de tools die je klanten gebruiken erop draaien, ook de AI-zoekmachines.
Je gebruikt zo goed als zeker al toepassingen die op een foundation model draaien. Denk aan de AI-assistent in je tekstverwerker of een chatbot op je site.
Die tools bouwen bijna allemaal voort op een handvol grote basismodellen.
Het gevolg voor je zichtbaarheid
Dezelfde onderliggende modellen die antwoorden genereren, bepalen mee welke bronnen ze citeren.
Omdat ze getraind zijn op tekst en patronen, belonen ze heldere, betrouwbare en goed gestructureerde content.
Dat is de kern van generative engine optimization, in het verlengde van klassieke SEO.
Van model naar citaat
Veel AI-zoekmachines laten het model niet alleen uit zijn geheugen antwoorden. Ze halen eerst bronnen op.
Dat heet RAG: het model krijgt opgehaalde passages en schrijft daarmee zijn antwoord. Die ophaalstap draait meestal op vectorzoeken.
Wil je dat AI-tools jouw bedrijf noemen als bron? Dan begint dat bij content die een model makkelijk kan begrijpen en overnemen.
Daar zetten we met onze GEO-agency aanpak op in.
Welke fouten en misvattingen kom je vaak tegen?
Drie misverstanden komen in B2B-gesprekken het vaakst terug:
- Denken dat je een eigen model moet trainen. Bijna nooit nodig. De hefboom zit in het slim aanpassen van een bestaand model.
- Aannemen dat de output altijd klopt. Een breed getraind model klinkt zelfverzekerd, maar kan feiten verzinnen.
- De modelkeuze verwarren met je zichtbaarheid. Of een AI-zoekmachine je noemt, hangt af van je content en autoriteit, niet van het onderliggende model.
Controle blijft nodig
Voor B2B-content blijft menselijke controle op cijfers, namen en claims noodzakelijk.
Waarom een model iets verzint, lees je in wat is een AI-hallucinatie.
Investeer in content, niet in modeltechniek
Investeer in je generatieve AI-vindbaarheid via sterke content.
Niet in modeltechniek.
Moet jij een eigen foundation model trainen?
Nee, en dat menen we.
Zo’n model trainen kost miljoenen aan rekenkracht en vraagt gespecialiseerde teams. Voor zowat elk B2B-bedrijf is dat volstrekt overbodig.
Je haalt de waarde uit bestaande modellen, via kant-en-klare tools of lichte fine-tuning op je eigen data.
De omgekeerde valkuil
De valkuil is eerder de omgekeerde: meegaan in de hype.
Dan zet je dure AI-projecten op die geen klanten opleveren.
Ons advies: stuur op omzet en gekwalificeerde leads, niet op indrukwekkende technologie.
Als klein team dat snel beweegt, kiezen we de eenvoudigste aanpak die werkt. Soms is dat AI. Vaak is dat gewoon een scherper aanbod en betere content.
Veelgestelde vragen
Is een foundation model hetzelfde als een large language model?
Niet helemaal. Een large language model is een foundation model dat met tekst werkt.
Er bestaan ook foundation models voor beeld of voor meerdere datatypes tegelijk. Een LLM is dus een soort foundation model.
Waar komt de term vandaan?
De term werd in 2021 gemunt door onderzoekers van Stanford, in een rapport over de kansen en risico’s van deze modellen.
Ze kozen “foundation” om te benadrukken dat het om herbruikbare basismodellen gaat.
Moet ik zelf een foundation model trainen?
Nee. Dat is extreem duur en zelden nodig.
Je bouwt voort op bestaande modellen via tools of lichte fine-tuning op je eigen data.
Wat heeft een foundation model met GEO te maken?
AI-zoekmachines draaien op foundation models. Ze bepalen welke bronnen ze citeren.
Begrijpen hoe ze werken, helpt je content maken die vaker vermeld wordt.
Wil je weten wat AI voor jouw groei betekent?
Vertel ons waar je staat. We zeggen eerlijk wat wel en niet loont.
Geen AI-hype, maar keuzes die klanten opleveren. Neem contact op.
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.