
SEO & GEO
Wat is deep learning? Uitleg voor B2B-marketeers

Kopieer voor AI
Deep learning is machine learning met neurale netwerken die uit veel lagen bestaan.
Door die diepte leert een model heel complexe patronen in taal, beeld en geluid.
Een mens hoeft die kenmerken niet vooraf te benoemen.
Het verdict: wat is deep learning voor een B2B-marketeer? De technologie achter ChatGPT, Gemini en AI-zoekmachines. Je hoeft ze niet te bouwen, wel te begrijpen.
Het is de motor achter zowat elke grote AI-doorbraak van de laatste jaren, van beeldherkenning tot de taalmodellen in AI-zoekmachines.
Wat is deep learning precies?
Deep learning is een deelgebied van machine learning waarbij modellen leren via een gelaagd neuraal netwerk.
IBM noemt het “een deelverzameling van machine learning, aangedreven door meerlagige neurale netwerken” (IBM over deep learning).
Waarom het “deep” heet
Het woord “deep” (diep) slaat op het aantal lagen.
Een eenvoudig model heeft één of twee lagen.
IBM legt de grens voor deep learning bij minstens vier lagen, en moderne modellen gaan vaak veel dieper: tientallen tot honderden lagen.
Elke laag borduurt voort op wat de vorige heeft herkend.
Een voorbeeld: beeldherkenning
Neem beeldherkenning. Zo bouwt een netwerk zijn begrip op, laag per laag:
De eerste lagen pikken simpele dingen op, zoals randen en kleuren. Latere lagen combineren die tot vormen, dan tot onderdelen, en uiteindelijk tot een begrip als “dit is een gezicht”.
Volgens IBM is dat het onderscheidende: het model bouwt zelf steeds abstractere kenmerken op.
Kern: daardoor is deep learning krachtig bij taken die te rommelig zijn voor vaste regels.
Wat is het verschil met gewone machine learning?
Deep learning is machine learning, maar niet elke machine learning is deep learning.
Het verschil zit in twee dingen.
Feature engineering
Bij klassieke machine learning bepaalt een mens vaak welke kenmerken belangrijk zijn.
Bij deep learning ontdekt het model die zelf uit ruwe data.
Stel: je wil voorspellen welke leads klant worden. Met klassieke machine learning kies jij de kenmerken, zoals sector, bedrijfsgrootte en aantal websitebezoeken.
Schaal
Deep learning bloeit pas op bij heel veel data en flink wat rekenkracht.
IBM schrijft dat het “een buitengewoon grote hoeveelheid data en rekenkracht” vraagt om te trainen.
Snellere grafische processors (GPU’s) maakten het pas op grote schaal praktisch.
Let op: bij weinig data presteert een eenvoudiger model vaak even goed of beter.
Naast elkaar
Kort gezegd: deep learning kan complexere problemen aan. Maar het vraagt ook meer.
Voor gestructureerde tabeldata met beperkte omvang is een simpeler model vaak de slimmere keuze.
Deze tabel zet de belangrijkste verschillen naast elkaar:
| Aspect | Klassieke machine learning | Deep learning |
|---|---|---|
| Kenmerken bepalen | Vaak handmatig door een mens | Automatisch uit ruwe data |
| Datahoeveelheid | Werkt al bij kleine datasets | Vraagt veel data |
| Rekenkracht | Beperkt, draait op gewone hardware | Zwaar, vaak met GPU’s |
| Type problemen | Gestructureerde data, duidelijke regels | Rommelige data zoals taal, beeld en geluid |
| Uitlegbaarheid | Redelijk te volgen | Vaak een black box |
Geen van beide is “beter”.
Het hangt af van je probleem, je data en wat je wil verklaren.
Waarom deep learning jou als marketeer aangaat
Omdat het al in je tools zit, en steeds vaker in hoe je doelgroep zoekt.
Je hoeft geen model te bouwen om ermee in aanraking te komen. Drie voorbeelden:
- AI-zoekmachines en chatbots: de taalmodellen achter ChatGPT, Gemini en Perplexity
- Beeld- en spraakherkenning: in advertentietools en analysesoftware
- Aanbevelingssystemen: die inschatten welke content of producten relevant zijn
De taalmodellen achter AI-zoekmachines
De taalmodellen achter ChatGPT, Google Gemini en Perplexity zijn deep learning. Ze bepalen mee welke bronnen ze citeren als iemand een vraag stelt.
De doorbraak kwam met de Transformer, een netwerkarchitectuur die onderzoekers in 2017 voorstelden (Vaswani e.a., 2017). Op die bouwsteen draaien de grote taalmodellen van vandaag.
Stel dezelfde vraag aan twee modellen en je ziet het verschil meteen. Zo antwoordt ChatGPT op een vraag over zichtbaarheid in AI:
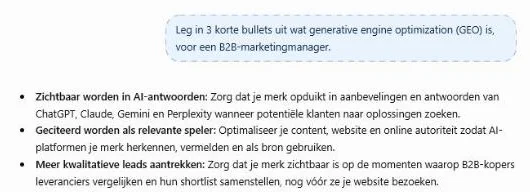 ChatGPT gratis (tijdelijke chat), 17 oktober 2026: drie bullets, ongeveer 70 woorden, geen bronnen.
Perplexity geeft op dezelfde vraag ook zijn bronnen:
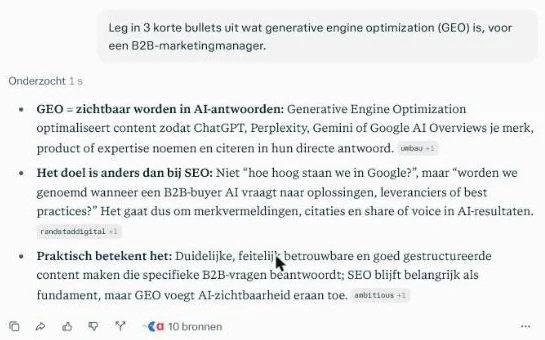 Perplexity met een gratis account, 17 oktober 2026: drie bullets, een bronlabel bij elke bullet en 10 bronnen in totaal.
Dezelfde technologie, een ander antwoord.
Daar wil je als bron tussen staan.
Deep learning zit al jaren in Google
Deep learning zit al veel langer in de gewone zoekresultaten dan veel mensen denken.
Google gebruikt sinds 2015 een systeem genaamd RankBrain om ongewone zoekopdrachten beter te begrijpen. Sinds 2019 gebruikt het BERT om de bedoeling achter een zin te doorgronden, in plaats van los naar trefwoorden te kijken.
Bij de lancering in oktober 2019 hielp BERT al bij “één op de tien” Engelstalige zoekopdrachten in de VS (Google over BERT).
Het voorbeeld van Google zelf: in “2019 brazil traveler to usa need a visa” verandert het woordje “to” de hele betekenis. Oudere systemen gaven resultaten over Amerikanen die naar Brazilië reisden.
Wat Google zelf over deze systemen zegt
Google beschrijft in zijn overzicht van ranking-systemen hoe deze modellen de betekenis van een zoekopdracht snappen. Ook als je het anders verwoordt dan de pagina die je zoekt.
RankBrain helpt volgens Google relevante content te tonen, “zelfs als die niet alle exacte woorden van de zoekopdracht bevat”.
Tip: schrijf zoals je klant echt praat, niet door trefwoorden te stapelen. Meer over hoe machines taal lezen, staat in natuurlijke taalverwerking (NLP).
Wat dit betekent voor je zichtbaarheid
AI-zoekmachines veranderen het spel voor B2B nog sterker.
Vraagt je potentiële klant een AI om advies in plaats van tien blauwe links te scannen? Dan wil je dat het model jou vermeldt. Dat is de kern van generative engine optimization.
Omdat deze modellen leren uit tekst en patronen, belonen ze heldere, betrouwbare en goed gestructureerde content.
Precies daar bouwt onze GEO-agency aanpak op verder, in het verlengde van klassieke SEO.
Onze ervaring: ChatGPT en Claude splitsen één vraag op in vele varianten en zoeken daarop. Wie in de top 3 staat voor die varianten, maakt statistisch meer kans om in het AI-antwoord te komen.
Dat mechanisme heet query fan-out. Een positie alleen is geen garantie.
Moet jij zelf iets met deep learning?
Meestal niet: de meeste B2B-bedrijven hoeven zelf geen deep learning-model te trainen.
Dat vraagt veel data, dure infrastructuur en gespecialiseerde mensen.
Het levert zelden meer op dan een kant-en-klare tool die al op miljarden voorbeelden getraind is.
Begrijpen loont wel
Waar het wél telt, is begrijpen hoe deze modellen werken.
Dan maak je slimmere keuzes.
Snappen dat een taalmodel patronen voorspelt en niet echt “begrijpt”, verklaart twee dingen:
- waarom het soms zelfverzekerd onzin genereert, een AI-hallucinatie
- waarom betrouwbare bronvermelding zo belangrijk wordt
Onze ervaring: als je je positionering niet helder kan vertellen, vult het model de leemte zelf in. Dan begint het te hallucineren over je bedrijf.
Kies voor wat werkt
En zoals altijd: stuur op klanten en omzet, niet op de nieuwste technologie omdat ze indrukwekkend klinkt.
Als klein team dat snel beweegt, kiezen we voor wat werkt, niet voor wat imponeert.
Vuistregel: heb je geen miljoenen voorbeelden en geen ML-team? Gebruik dan bestaande modellen via tools, en investeer in je eigen content en data.
Welk model bij welke taak past, lees je in ChatGPT vs Claude vs Gemini.
Hoe past deep learning in het grotere AI-plaatje?
Zie het als een reeks schillen:
Van buiten naar binnen
- Artificiële intelligentie: de breedste laag, zie wat is artificiële intelligentie
- Machine learning: de tak die leert uit data
- Deep learning: een specialisatie op basis van diepe neurale netwerken
- Grote taalmodellen: deep learning toegepast op tekst
Een large language model is dus een toepassing van deep learning op tekst.
Zo hangt alles samen.
Waar generatieve AI past
Generatieve AI is de familie van modellen die nieuwe tekst, beelden of code maken. De meeste zijn gebouwd met deep learning.
Een foundation model is zo’n groot basismodel waarop anderen verder bouwen.
Wil je weten hoe zo’n model teksten in stukjes verwerkt? Lees dan wat een token is.
Veelgestelde vragen
Is deep learning hetzelfde als machine learning?
Deep learning is een onderdeel van machine learning dat werkt met neurale netwerken met veel lagen. Alle deep learning is machine learning, maar veel machine learning gebruikt geen diepe netwerken.
Waarom heet het “deep”?
Het slaat op het aantal lagen in het neurale netwerk. Meer lagen betekent dat het model steeds abstractere patronen kan opbouwen, van simpele randen tot complexe betekenis.
Heeft deep learning veel data nodig?
Ja. Deep learning presteert pas goed bij grote hoeveelheden data en flink wat rekenkracht. Bij weinig data werkt een eenvoudiger model vaak even goed of beter.
Wat heeft deep learning met AI-zoekmachines te maken?
De taalmodellen achter tools als ChatGPT en Gemini zijn deep learning. Ze leren uit enorme hoeveelheden tekst en bepalen zo welke bronnen ze citeren, wat het relevant maakt voor je zichtbaarheid.
Gebruikt Google deep learning om te ranken?
Ja. Google noemt in zijn overzicht van ranking-systemen onder meer BERT, RankBrain en neural matching: AI-systemen die de betekenis van woorden en zoekopdrachten begrijpen.
Klaar om AI slim in te zetten?
Je hoeft geen deep learning te bouwen om er voordeel uit te halen. Je moet wel zorgen dat de modellen jou correct kennen.
Vertel ons waar je staat met AI en zichtbaarheid. Neem contact op en je krijgt een concreet advies over wat wel en niet loont.
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.