
SEO & GEO
Dynamische AI-layouts: hoe AI-interfaces je content tonen
 Tanguy De Keyzer Oprichter & digitale strateeg · Bijgewerkt 12 november 2026 · ◷ 12 min leestijd
Kopieer voor AI
Een dynamische AI-layout kiest per vraag en per gebruiker een ander visueel format.
Een dynamische AI-layout is een interface die het format van een antwoord ter plekke genereert.
Dat gebeurt op basis van de inhoud zelf, de context van de gebruiker en de ingeschatte intentie.
Het verdict: in AI-interfaces win je niet meer met één vaste positie. Je wint met content die in elk format overeind blijft en daarbinnen opvalt.
Waarom de vaste SERP voorbij is
Je kon vroeger een zoekresultatenpagina screenshotten en wist zeker dat hij er morgen ongeveer hetzelfde zou uitzien.
Tien blauwe links, een featured snippet op zijn vaste plek, herkenbare SERP-features. Die stabiliteit is voorbij.
Wat er veranderd is: AI-interfaces renderen dezelfde vraag elke keer anders. Eén gebruiker krijgt een vergelijkingstabel, een ander een lopend verhaal, een derde een interactieve beslisboom.
De container waarin je content verschijnt, is geen vaste template meer. Het is een vloeiende beslissing van het model.
Dit stuk is een verdieping binnen de ultieme GEO-handleiding, waarin generative engine optimization (GEO) van fundament tot meting aan bod komt.
Test je AI-zichtbaarheid: scoor je pagina in een halve minuut met onze GEO-check.
Hoe gaat een AI-interface van vaste template naar gegenereerde layout?
Klassieke zoekresultaten draaiden op vaste sjablonen. AI-interfaces genereren de layout per antwoord.
Hoe het vroeger werkte
Het format varieerde per type query, maar de variaties waren voorspelbaar.
Je kon optimaliseren voor een specifieke positie in een bekend stramien.
Hoe AI-systemen het doen
AI-systemen werken anders. Ze genereren de layout (zo bouwt Google AI Mode het visuele format van een antwoord ter plekke op, inclusief tabellen, grids en interactieve tools).
Google schrijft daar dat AI Mode de ideale visuele layout “on the fly” maakt, per vraag.
Als een interactieve tool helpt, codeert het model er zelfs een, zoals een leningcalculator.
Die layout ontstaat uit drie soorten signalen:
- Inhoudsgedreven structuur: detecteert het model een vergelijking, dan bouwt het een tabel. Een proces wordt een stappenplan.
- Contextgedreven aanpassing: mobiel krijgt een verticaal, scanbaar format, desktop een rijkere meerkoloms-weergave.
- Intentiegedreven optimalisatie: transactioneel krijgt actie-elementen, informatief een leesbaar verhaal, vergelijkend een vergelijking.
Voor- en nadelen worden een naast-elkaar-weergave. Een snelle vraag levert een compacte samenvatting op, een onderzoeksvraag een uitgebreide versie.
Dezelfde vraag, drie layouts
Je ziet het verschil al bij één vraag. We stelden dezelfde Nederlandse vraag over GEO aan Perplexity, Gemini en ChatGPT.
Perplexity zet een bronlabel bij elke bullet en toont onderaan het aantal bronnen:
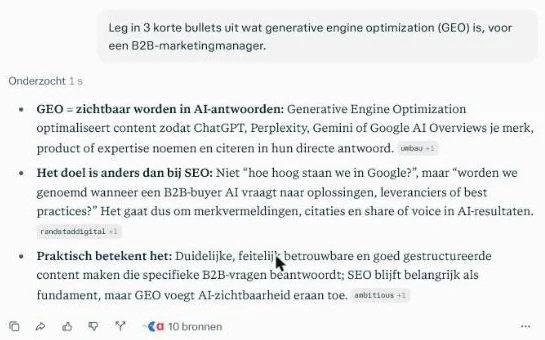 Perplexity met een gratis account, 17 oktober 2026: een bronlabel bij elke bullet en 10 bronnen in totaal.
Gemini kiest voor dezelfde vraag een introzin plus vetgedrukte bullets, zonder bronnen:
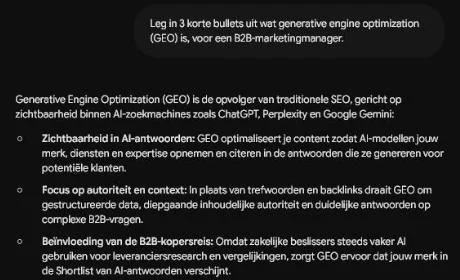 Gemini (Google Workspace-account, Flash-model), 17 oktober 2026: een introzin plus drie bullets, ongeveer 110 woorden.
ChatGPT houdt het bij drie korte bullets, ook zonder bronnen:
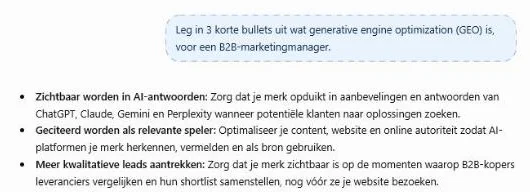 ChatGPT gratis (tijdelijke chat), 17 oktober 2026: drie bullets, ongeveer 70 woorden, geen bronnen.
Wat dit bewijst: alleen in Perplexity is een bron zichtbaar per bewering. Wie daar geciteerd wordt, krijgt zichtbaarheid die in de andere twee layouts ontbreekt.
Hoe de engines verschillen in bronkeuze, lees je in Perplexity vs ChatGPT en Gemini vs ChatGPT: bronselectie.
Wat er achter de schermen gebeurt
Achter de schermen loopt het ongeveer in zes stappen:
- Het model synthetiseert eerst de inhoud.
- Het analyseert de structuur: lijst, vergelijking of proces.
- Het beoordeelt de context van de gebruiker.
- Het kiest of genereert een format.
- Het bepaalt wat visuele nadruk krijgt.
- Het rendert het geheel.
In elke van die stappen zit een oordeel dat jouw zichtbaarheid raakt.
Google beschrijft voor AI Overviews en AI Mode ook query fan-out: het systeem doet “meerdere gerelateerde zoekopdrachten over subonderwerpen” om een antwoord te bouwen (Google over AI-features en je website).
Hoe die retrieval werkt, staat in de nieuwe AI-zoekarchitectuur uitgelegd.
Die opeenvolging laat zich tekenen als een reeks stappen, van ruwe inhoud tot het antwoord op het scherm:
Waarom is visuele prominentie de nieuwe concurrentiedimensie?
Als layouts dynamisch zijn, wordt visuele prominentie een wedstrijd op zich.
Het gaat niet langer alleen om geselecteerd worden. Het gaat om hoe opvallend en benadrukt je content is binnen het gerenderde antwoord.
De vier vormen van prominentie
Ik onderscheid vier vormen:
- Positie-prominentie: waar je content in de visuele hiërarchie staat. Bovenaan is het sterkst, ingeklapte gebieden het zwakst.
- Ruimte-prominentie: hoeveel visuele ruimte je inneemt, van een eigen sectie tot een korte vermelding.
- Opmaak-prominentie: hoe je content is vormgegeven, van gemarkeerd of in een kader tot grijs en weggedrukt.
- Interactie-prominentie: of je gekoppeld bent aan de primaire actie of aan een verborgen actie na uitklappen.
Bij positie zit inline in de flow tussen die twee uitersten in. Lagere secties zijn zwakker dan de top van het antwoord.
Wat prominentie bepaalt
Drie factoren bepalen die prominentie:
- Relevantie: een direct antwoord krijgt de meeste nadruk
- Autoriteit: herkende merken en expertbronnen kunnen een boost krijgen
- Content-structuur: goed gestructureerde content verschijnt in rijke formats
Dat laatste is waar je het meeste invloed hebt. Ongestructureerde content blijft beperkt tot een basale weergave.
Hoe je je tekst opbouwt voor extractie, werk ik verder uit in content-architectuur voor AI-extractie. Autoriteit begint bij een herkenbare entiteit, zie wat entiteit-SEO is.
In welke formats kan je content opduiken?
Elk format vraagt een eigen optimalisatie-aanpak. Vier komen het vaakst terug.
1. Verhalende samenvattingen
Het model schrijft proza dat meerdere bronnen synthetiseert.
Wat telt: of je geselecteerd wordt als bron voor een kernbewering, hoe duidelijk de attributie is en hoe prominent je merk wordt genoemd.
Jouw zet: schrijf heldere, citeerbare uitspraken met specifieke, verwijsbare data. Bouw aan merk-onderwerp-associaties zodat je naam natuurlijk valt.
2. Vergelijkingstabellen
Gestructureerde vergelijkingen van opties.
Wat telt: in welke kolom je staat (de eerste kolom valt meestal het eerst op), welke rijen worden opgenomen en hoe je waarden worden weergegeven.
Jouw zet: zorg dat je differentiatoren tabelwaardige kenmerken zijn. Lever schone, vergelijkbare datapunten die makkelijk te extraheren zijn.
Hoe zo’n pagina eruitziet, lees je in vergelijkingspagina’s die AI citeert.
3. Stappenplannen
Procedurele content in volgorde.
Wat telt: welke stappen jouw content citeren en of jouw oplossing op het juiste moment in het proces opduikt.
Jouw zet: maak complete procedures die in heldere stappen op te delen zijn. Plaats je oplossing op de logische plek.
4. Beslisbomen
Interactieve beslisstromen die de gebruiker langs criteria leiden.
Wat telt: in welke takken je voorkomt en op welke positie binnen een tak, als eerste aanbeveling of als alternatief.
Jouw zet: documenteer expliciet voor welke criteria en use cases jouw oplossing geschikt is. Zo kan de beslislogica je plaatsen.
Uitgewerkte use cases helpen daarbij, zie product use cases voor AI search.
De vier formats naast elkaar
| Format | Wat telt | Jouw zet |
|---|---|---|
| Verhaal | Bronselectie, attributie | Citeerbare uitspraken met data |
| Tabel | Kolom, rij, celinhoud | Tabelwaardige differentiatoren |
| Stappenplan | Welke stap je citeert | Complete, opdeelbare procedures |
| Beslisboom | Tak en positie | Use cases aan criteria koppelen |
Hoe maakt personalisatie zichtbaarheid meervoudig?
Dynamische layouts maken personalisatie mogelijk. Dezelfde vraag kan jouw content voor verschillende gebruikers compleet anders renderen.
Drie gebruikers, drie weergaven
Neem één platform en één vraag. Zo kan het renderen:
- Enterprise-koper: ziet je platform prominent, met enterprise-features uitgelicht
- Kleine ondernemer: ziet het als optie tussen SMB-vriendelijke alternatieven
- Technische evaluator: krijgt specificaties en integratiedetails uitvergroot
Wat personalisatie voedt
Die personalisatie wordt gevoed door vier soorten signalen:
- Expliciet: instellingen en opgegeven context
- Gedrag: zoekgeschiedenis en eerdere interacties
- Context: apparaat, locatie en tijd
- Afgeleid: vermoedelijke rol of use case
Voor gedrag is Google concreet: zo gebruikt Google AI Mode je opgeslagen zoekactiviteit.
Die personalisatie verwijst naar eerdere zoekopdrachten in je zoekgeschiedenis en geldt vanaf 18 jaar, met geschiedenis aan.
Wat je wel kan doen
Je kunt die signalen niet sturen.
Je kunt wel zorgen dat je voor elk profiel iets te bieden hebt. Concreet:
- Segmentdekking: maak enterprise- én SMB-content, technische verdiepingen én businessoverzichten.
- Use case-specificiteit: schrijf branche-specifieke of rol-specifieke scenario’s.
- Persona-afstemming: maak aparte content voor beslisser, technische evaluator en eindgebruiker.
- Aanpasbare structuur: bouw modulaire secties op meerdere detailniveaus, gesegmenteerd per doelgroep.
Een voorbeeld: stel dat je een planningssoftware voor transportbedrijven verkoopt.
Een pagina voor de CFO over kosten en een pagina voor de IT-lead over integraties vergroten samen de kans dat elk profiel je vindt.
Hoe optimaliseer je voor flexibele rendering?
Je weet vooraf niet in welk format je content terechtkomt. Bouw dus content die overal werkt.
Ik hanteer drie principes.
1. Modulaire architectuur
Maak zelfstandige secties met elk een eigen waarde, duidelijke grenzen en flexibele combineerbaarheid.
Een module moet kunnen opduiken zonder de rest van de pagina. Denk aan een definitieblok, een prijstabel of een stappenlijst die elk los overeind blijven.
2. Meerdere granulariteiten
Bied dezelfde informatie op verschillende niveaus aan:
| Niveau | Lengte | Voor welke vraag |
|---|---|---|
| Samenvatting | 50 tot 100 woorden | Snelle vraag |
| Standaard | 200 tot 400 woorden | Gewone vraag |
| Gedetailleerd | 500 woorden of meer | Diepe onderzoeksvraag |
Elk niveau moet op zichzelf compleet zijn. Zo kan het model kiezen wat past bij een snelle of een diepe vraag.
3. Format-agnostische kern
Zorg dat je kerninformatie niet afhankelijk is van het format.
De betekenis moet behouden blijven, of het nu als tabel, lijst of verhaal wordt gerenderd. Je essentiële punten blijven prominent, ongeacht de weergave.
Gestructureerde data als steun
Gestructureerde data helpt het model je content te begrijpen. Vier bouwstenen:
- schema-markup
- schone en extraheerbare tabellen
- consistente lijsten met duidelijke labels
- rijke metadata
Let op: volgens Google zijn er geen extra vereisten om in AI Overviews of AI Mode te verschijnen. Structured data moet wel overeenkomen met de zichtbare tekst.
Diezelfde flexibele opbouw houdt content overeind wanneer een autonoom systeem je pagina in stukken leest. Dat bespreek ik bij grounding snippets.
Hoe meet je prominentie over de tijd?
Je kunt niet sturen wat je niet meet.
Kwalitatief: antwoorden scoren
Visuele prominentie laat zich grotendeels kwalitatief beoordelen. Zo pak je het aan:
- Bevraag je doeltermen over verschillende platforms.
- Leg de antwoorden vast met een screenshot en datum.
- Scoor ze op positie, ruimte, opmaak en nadruk.
- Vergelijk met concurrenten en volg de verandering over de tijd.
Kwantitatief: indirecte indicatoren
Daarnaast zijn er indirecte, kwantitatieve indicatoren:
- doorklikken vanuit AI-antwoorden
- je aandeel in citaties
- je first-mention-rate
- hoe vaak je een featured behandeling krijgt
Geen enkele meet prominentie perfect. Samen geven ze een betrouwbaar beeld van je richting.
Hoe je dat aandeel berekent, lees je in AI share of voice meten.
Per platform bijhouden
Houd dat beeld bij per platform. Google AI Mode, ChatGPT en Perplexity renderen elk volgens hun eigen patronen.
Wat in het ene format prominent is, kan in het andere wegvallen.
Een vergelijking over modellen heen staat in cross-model-analyse voor GEO.
Veelgestelde vragen
Wat is het verschil tussen een dynamische layout en een klassiek zoekresultaat?
Een klassiek zoekresultaat gebruikt een vaste template: de posities en formats liggen min of meer vast en variëren voorspelbaar per type query.
Een dynamische AI-layout genereert het visuele format ter plekke, op basis van de inhoud, de gebruiker en de context.
Daardoor kan dezelfde vraag voor verschillende mensen een tabel, een verhaal of een beslisboom opleveren.
Moet ik mijn content voor één specifiek format optimaliseren?
Nee, dat is juist het risico. Omdat je vooraf niet weet welk format het model kiest, optimaliseer je voor flexibele rendering.
Bouw modulaire, zelfstandige secties op meerdere niveaus van detail. Houd een kern die zijn betekenis behoudt, of die nu als tabel, lijst of proza verschijnt.
Hoe beïnvloedt personalisatie mijn zichtbaarheid?
Personalisatie betekent dat dezelfde vraag jouw content per gebruiker anders rendert, afhankelijk van rol, apparaat en gedrag.
Je stuurt die signalen niet.
Je vergroot je kans door meerdere segmenten en use cases af te dekken: enterprise en SMB, technisch en zakelijk, beslisser en eindgebruiker.
Geldt dit ook voor agentic AI en autonome assistenten?
Ja. Naarmate AI-assistenten autonomer worden en zelf interfaces samenstellen, wordt de manier waarop ze content tonen nog variabeler.
De principes blijven gelijk: modulaire content, visuele prominentie en dekking over segmenten. Meer daarover in agentic search en autonome AI-assistenten.
Hulp nodig?
Wil je dit vertalen naar uitvoering? Bekijk hoe we dit aanpakken met AI-vindbaarheid.
Verder lezen
100 GEO-tips om genoemd te worden in ChatGPT en Google AI
- 10 hoofdstukken:van robots.txt en Bing tot meten
- Copy-paste:regex voor Search Console en GA4
- Sjablonen:koopvragen per fase en een 30-dagenplan
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.