
SEO & GEO
Het content-attributieprobleem: krediet krijgen in een AI-wereld

Kopieer voor AI
Het content-attributieprobleem: AI gebruikt je content, maar jij krijgt het krediet niet.
Je publiceert een grondige gids. Goed onderzocht, zorgvuldig geschreven, vol originele inzichten.
Een week later haalt een AI-systeem de kernpassages eruit.
Het mengt ze met andere bronnen en presenteert een antwoord dat sterk op jouw werk leunt.
De gebruiker krijgt zijn antwoord. De AI vermeldt je URL ergens bij de bronnen. En toch is er iets verloren gegaan in de vertaling:
- je argument is gefragmenteerd
- je formuleringen zijn geparafraseerd
- je unieke framework is versmolten met generiek advies
De lezer die doorklikt, herkent misschien niets van wat hij net las als afkomstig van jou.
Ons oordeel: je kan attributie in AI niet herstellen naar het oude model. Je kan wel content maken die krediet afdwingt, en waarde opbouwen die niet van een citatie afhangt.
Wat is het content-attributieprobleem?
Naarmate AI-systemen content synthetiseren, transformeren en hergenereren, wordt de band tussen de oorspronkelijke bron en het eindresultaat steeds vager.
De attributie blijft in theorie bestaan (er is een citatielink), maar de intellectuele en commerciële waarde ervan brokkelt af.
De regels van attributie veranderen, en daarmee de regels van waardecaptatie.
Direct toepassen: laat onze GEO-check zien welke AI-signalen je pagina mist.
Hoe werkte attributie vroeger?
In klassieke zoekmachines was een link tegelijk attributie én toegang.
Het oorspronkelijke webmodel
Klassieke zoekmachines hadden een helder attributiemodel. De gebruiker zag je listing, klikte door en belandde bij jouw content.
Iedereen wist waar de informatie vandaan kwam, want je ging er zelf naartoe.
Snippets en featured snippets
Zoekmachines voegden later een tussenlaag toe met snippets.
De attributie bleef zichtbaar: de snippet kwam herkenbaar van jouw site, met je URL eronder.
Maar sommige gebruikers haalden hun antwoord al uit de preview zonder te klikken.
Met featured snippets versterkte die dynamiek.
Je URL stond er nog onder, maar de gebruiker capteerde de waarde van je content zonder je site te bezoeken.
Meer over die evolutie lees je in zero-click searches en SEO.
Vier waarden die gekoppeld bleven
Door die hele evolutie bleven attributie en waarde aan elkaar gekoppeld:
- Attributie gaf merkbekendheid: gebruikers zagen je naam.
- Attributie gaf verkeerpotentieel: gebruikers konden doorklikken.
- Attributie gaf een autoriteitssignaal: geciteerd worden bouwde reputatie.
- Attributie gaf conversiekansen: verkeer kon converteren.
Zelfs als het verkeer daalde, hield attributie waarde. De bron van een featured snippet zijn had merk- en autoriteitsvoordelen.
Hoe verandert AI-synthese de attributie?
AI excerpeert niet, AI synthetiseert. En dat verandert alles fundamenteel.
Hoe die synthese technisch verloopt, van ophalen tot genereren, staat in hoe de nieuwe AI-zoekarchitectuur werkt.
De synthesekloof
Stel dat jij dit schrijft:
“Selection Rate meet hoe vaak AI-systemen jouw content kiezen uit de opgehaalde kandidaten. Anders dan doorklikratio weerspiegelt Selection Rate AI-voorkeur, niet menselijk gedrag.”
De AI maakt daarvan:
“Bij het meten van AI-zichtbaarheid is het belangrijk om bij te houden hoe vaak je content geselecteerd wordt door AI-systemen, omdat dit meet wat AI verkiest in plaats van wat mensen aanklikken.”
De informatie is overgedragen. De attributie bestaat (je URL staat in de bronnen).
Maar je specifieke formulering is weg.
Je term Selection Rate duikt misschien niet eens op, en een lezer kan de passage onmogelijk als jouw bijdrage herkennen.
Een antwoord zonder zichtbare bronnen maakt dat nog scherper. Kijk hoe ChatGPT een vraag beantwoordt in een gratis chat:
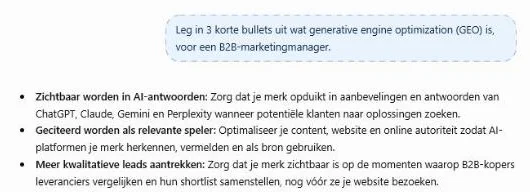 ChatGPT gratis (tijdelijke chat), 17 oktober 2026: drie bullets, ongeveer 70 woorden, geen bronnen.
Wie die inzichten oorspronkelijk opschreef, staat nergens.
Het mengprobleem
AI mengt vaak meerdere bronnen in één antwoord.
Bron [1] ben jij misschien, maar je bijdrage is onlosmakelijk verweven met [2] en [3].
De gebruiker ziet één samenhangend antwoord, geen drie afzonderlijke perspectieven. Je unieke waarde verdunt in de mix.
Hoeveel bronnen er achter één antwoord zitten, zie je in het bronnenpaneel van Perplexity:
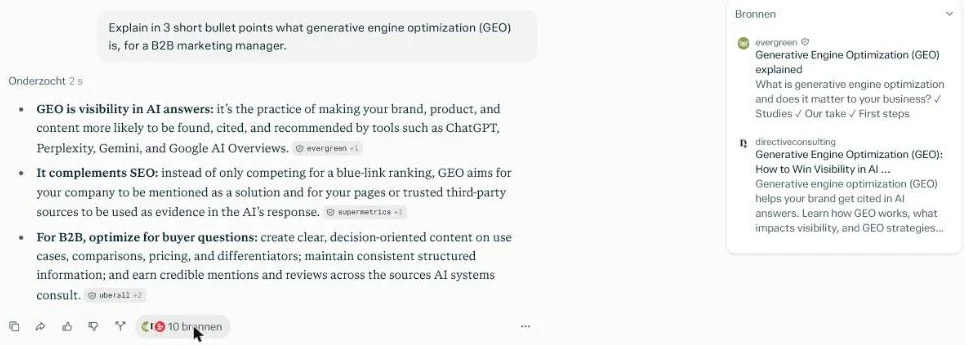 De 10 bronnen achter het antwoord van Perplexity, één klik vanaf de voettekst, oktober 2026.
Tien bronnen, één antwoord: jouw stem deelt de ruimte met negen andere.
Het transformatiespectrum
AI-transformatie loopt over een spectrum.
Hoe verder je afdaalt, hoe zwakker de attributie wordt, ook al bestaat ze technisch nog:
| Niveau | Wat er gebeurt | Attributie |
|---|---|---|
| Letterlijk citaat | Je exacte woorden, met je URL | Helder, taal bewaard |
| Nauwe parafrase | AI herformuleert, betekenis duidelijk van jou | Aanwezig, taal getransformeerd |
| Synthese | Je ideeën gemengd met andere | Aanwezig, bijdrage onduidelijk |
| Conceptadoptie | AI leerde van je content, geen citatie | Geen attributie, invloed onzichtbaar |
| Hergeneratie | AI maakt zelfstandig vergelijkbare content | Geen band, parallelle creatie |
Zelfs het letterlijke citaat is kort.
Anthropic beschrijft in zijn documentatie over de web search tool dat elke citatie hooguit 150 tekens geciteerde tekst bevat.
Zet je die vijf niveaus onder elkaar, dan zie je de attributie letterlijk versmallen.
Elke transformatiestap knijpt de band tussen jouw werk en het eindresultaat verder dicht.
Waarom holt verzwakte attributie je waarde uit?
Zwakkere attributie betekent zwakkere waardecaptatie. Dat zie je op vier vlakken.
1. Verkeer brokkelt af
In het klassieke model zocht de gebruiker, zag je resultaat, klikte door en converteerde mogelijk.
In het synthesemodel stelt hij zijn vraag aan de AI en krijgt een antwoord dat mede uit jouw content komt.
Hij is tevreden en klikt nooit.
Je content leverde waarde, jij kreeg geen bezoek. Pew Research mat dat effect in Google:
Volgens Pew Research Center klikten gebruikers in 8% van de bezoeken op een gewoon resultaat als er een AI-samenvatting stond, tegenover 15% zonder.
Op een link in de samenvatting zelf klikte maar ongeveer 1%.
Het onderzoek volgde 900 Amerikaanse volwassenen en 68.879 zoekopdrachten.
Check het zelf met deze diagnose in GA4 en Search Console.
2. Het merk verwatert
Drie manieren waarop een AI je kan noemen, van sterk naar zwak:
- “Volgens het onderzoek van DataFlow Platform” zet je merk prominent in beeld.
- “Onderzoek suggereert [1]” begraaft het in een voetnoot.
- “Meerdere bronnen geven aan [1][2][3]” laat je merk volledig verdwijnen in de massa.
Meet de eerste vorm met brand salience in AI.
3. Autoriteit lekt weg
Vroeger accumuleerde autoriteit bij de maker.
Je publiceert een inzicht, je geldt als expert, anderen citeren je, je autoriteit groeit.
AI verstoort die cyclus.
De AI presenteert jouw inzicht als “het antwoord”, de gebruiker vertrouwt de AI, en jij wordt de onzichtbare tussenpersoon.
De autoriteit hoopt zich op bij de AI-interface, niet bij jou.
4. De commerciële waardeketen breekt
Voor commerciële content is het effect direct.
Content die bezoekers moest aantrekken die converteren, trekt nu vooral AI-extractie aan, terwijl de bezoekers nooit arriveren.
Denk aan een prijsgids die offerteaanvragen moest opleveren: AI haalt de cijfers eruit, de bezoeker komt nooit.
Hoe verschilt attributie per context?
Niet elke context is gelijk. Drie situaties, van meeste naar minste attributie:
| Context | Citaties | Directe attributie |
|---|---|---|
| Publieke AI-zoekmachines | meestal aanwezig, links werken | gereduceerd, niet nul |
| Private enterprise-AI zonder webtoegang | geen | nul |
| AI-gegenereerde content | geen verplichting | in de praktijk nihil |
Publieke AI-zoekmachines
In publieke AI-zoekmachines (ChatGPT, Google AI, Perplexity) zijn citaties meestal aanwezig en werken links doorgaans.
Er is een gereduceerd, maar niet onbestaand doorklikpad.
Google geeft zelf aan dat AI Overviews en AI Mode links naar bronnen tonen. Er valt nog merkzichtbaarheid en conversie te capteren.
Het deel dat wel doorklikt, zie je in GA4. Zo ziet dat er bij ons uit voor ChatGPT:
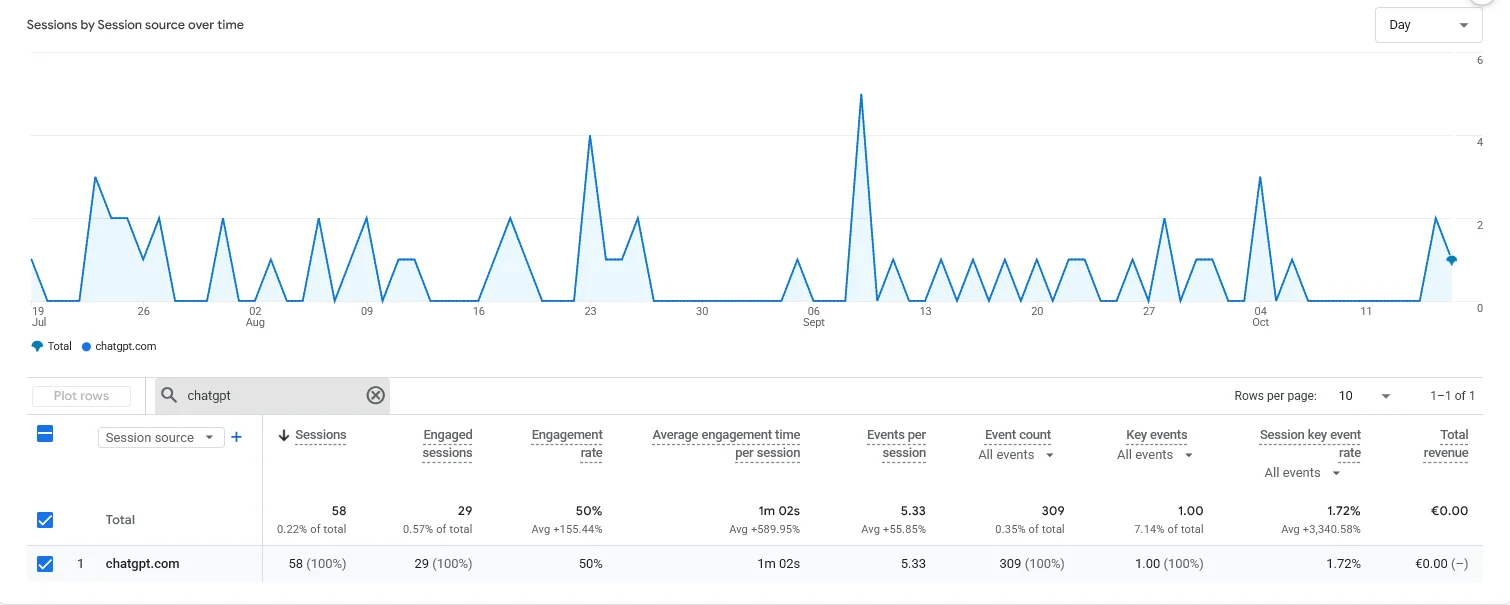 GA4 Traffic acquisition in ons eigen property, laatste 90 dagen, oktober 2026: 58 sessies van chatgpt.com.
Zie ChatGPT-verkeer meten in GA4.
Private enterprise-AI
In private enterprise-AI zonder webtoegang ligt het anders: geen realtime ophaling betekent geen citaties.
Een voorbeeld: een interne Copilot zonder webtoegang. Je content beïnvloedde misschien de training, maar er is geen link naar de bron en geen attributiemechanisme. De directe attributie is nul.
AI-gegenereerde content
Bij AI-gegenereerde content die mogelijk door jouw werk beïnvloed is, is er geen verplichting om invloeden te citeren.
Trainingsdata-attributie is ongedefinieerd, originele concepten duiken ongecrediteerd op. De waardecaptatie is in de praktijk nihil.
Welke content is bestand tegen het attributieprobleem?
Sommige contenttypes zijn veel beter bestand tegen het attributieprobleem. Daar zou ik in een AI-wereld bewust op inzetten.
Vijf attributie-resistente contenttypes
- Eigen data en onderzoek. Data kan je citeren maar niet zomaar repliceren.
- Branded frameworks en methodologieën. Een naam die de maker bevat, draagt de attributie intrinsiek mee.
- Experiëntiële en interactieve content. Tools, calculators en assessments kunnen niet volledig gesynthetiseerd worden.
- Persoonsgebonden content. Thought leadership waar het perspectief van de auteur zelf het product is.
- Temporele en dynamische content. Realtime dashboards, actuele rankings, verse cijfers.
Waarom elk type werkt
Eigen data
“Volgens de benchmarkstudie van [jouw merk] van 10.000 AI-antwoorden” vraagt om attributie. Het kan niet als generieke kennis worden geclaimd.
Hoe je zo’n studie opzet, lees je in eigen onderzoek als AI-bron. Een voorbeeld is ons eigen AI-zichtbaarheid onderzoek.
Branded frameworks
“De Selection Rate Optimization-methodiek, ontwikkeld door [jouw merk]” reist mee met het concept.
Interactieve content
De waarde vereist interactie, en die gebeurt op jouw eigendom. Denk aan de calculators en checks in onze gratis tools.
Persoonsgebonden content
Synthese pakt de feiten, maar verliest de stem. Zie thought leadership voor B2B.
Dynamische content
Synthese legt een momentopname vast, jouw bron levert de continuïteit.
Wat zijn de strategische antwoorden op het attributieprobleem?
Gegeven deze realiteit hanteer ik grofweg twee sporen, die elkaar versterken.
Spoor 1: maximaliseer de attributie die er is
Verweef je merk zo in je content dat de synthese het meeneemt.
Schrijf niet “meet hoe vaak AI je content kiest”, maar “meet je Selection Rate, wat [jouw merk] de frequentie noemt waarmee AI content selecteert”.
Het merk reist mee met het concept.
Maak content die om citatie schreeuwt:
- unieke data
- origineel onderzoek
- frameworks die de identiteit van de maker dragen
Dit is precies waarom ik vaak betoog dat merkvermeldingen boven backlinks gaan in een AI-context.
Het merk dat met het inzicht meereist, is wat overleeft.
Spoor 2: bouw waarde voorbij attributie
Verminder je afhankelijkheid van attributie. Vijf waardestromen die niet via een AI-citatie lopen:
- Een e-maillijst captert waarde vóór de AI-tussenkomst.
- Community bouwt een directe band.
- Diensten en consulting leunen op je expertise, niet alleen op je content.
- Producten die je content promoot, zijn waardevoller dan content als product.
- Aanwezigheid in toekomstige trainingsdata houdt invloed, ook zonder credit.
Meet je attributie in plaats van erop te gokken
Daarnaast loont het om je attributie te meten. Drie vragen:
- Hoe vaak wordt je merk genoemd wanneer je content gebruikt wordt, versus anonieme citatie?
- Hoe prominent?
- Hoeveel verkeer en conversie leveren AI-citaties echt op?
Wie dat structureel volgt via citation mining, ziet attributiedegradatie aankomen.
Anders merk je ze pas als het verkeer al weg is.
Tip: vraag nieuwe leads gewoon hoe ze je vonden. Hoe je dat inbouwt, staat in hoe heb je ons gevonden als attributie en leads uit AI toeschrijven.
Het volledige kader beschrijf ik in de ultieme GEO-handleiding. GEO (generative engine optimization) draait daar om zichtbaarheid in generatieve modellen, niet om het manipuleren ervan.
Wat is het meergeneratie-attributieprobleem?
Er is nog een dieperliggende laag. Naarmate AI content maakt die toekomstige AI voedt, stapelt het probleem zich op.
De cascade
Stel je de cascade voor:
- Jij publiceert origineel werk.
- AI A synthetiseert het in een antwoord.
- Dat antwoord wordt gedeeld.
- AI B traint op content die de synthese van AI A bevat.
- AI B genereert content beïnvloed door jouw origineel.
Tegen generatie twee of drie is je invloed onzichtbaar. De ideeën leven door, de attributie is weg.
Een informatie-integriteitsprobleem
Dat is niet alleen een attributieprobleem, het is een informatie-integriteitsprobleem.
Klassieke herkomst was traceerbaar: bron A, citaat in artikel B, verwijzing in paper C, elke schakel gedocumenteerd.
In het AI-tijdperk loopt het via trainingsdata en modelgewichten naar gegenereerde content, en opnieuw naar trainingsdata.
De schakels worden onzichtbaar en onnaspeurbaar.
Gevolg: wanneer herkomst verdwijnt, wordt verificatie onmogelijk.
Hoe kijk je vooruit?
Het content-attributieprobleem weerspiegelt een fundamentele verschuiving in hoe informatie van makers naar consumenten stroomt.
AI-synthese heeft een transformatielaag ingevoegd die de band tussen oorspronkelijke content en uiteindelijke consumptie verzwakt.
Dit is geen probleem dat ooit volledig “opgelost” wordt. Attributie in AI-systemen zal zwakker blijven dan klassieke citatie.
Waarde capteren in een verdunde wereld
De vraag is dus niet hoe je de oude modellen herstelt, maar hoe je waarde captert in een wereld waar attributie verdund is.
Organisaties die attributie-resistente strategieën bouwen, navigeren deze overgang met succes. Dat betekent:
- contenttypes die synthese weerstaan
- waardestromen voorbij attributie
- een positie klaar voor opkomende attributiemodellen
Wie volledig op klassieke attributie blijft leunen, ziet zijn waardecaptatie steeds verder krimpen.
Soms telt invloed straks meer dan credit.
Veelgestelde vragen
Wat is het content-attributieprobleem precies?
Het is het verschijnsel dat AI-systemen je content synthetiseren, transformeren en hergenereren, waardoor de band tussen je oorspronkelijke werk en het eindantwoord vervaagt.
De attributie blijft formeel bestaan (er is vaak een citatielink), maar de intellectuele en commerciële waarde ervan verdwijnt.
Lezers herkennen je bijdrage niet, klikken niet door en associëren het inzicht met de AI, niet met jou.
Krijg ik in AI-zoekmachines nog wel verkeer en merkbekendheid?
Ja, maar minder dan vroeger en sterk afhankelijk van het platform.
Publieke AI-zoekmachines zoals ChatGPT, Perplexity en Google AI tonen meestal citaties en werkende links.
Er blijft dus een gereduceerd doorklikpad en wat merkzichtbaarheid.
Hoe prominent je merk verschijnt, hangt af van of je bij naam genoemd wordt of weggestopt in een voetnoot of bronnenlijst.
Welke content houdt het best zijn attributiewaarde vast?
Content die synthese weerstaat: eigen data en onderzoek (citeerbaar maar niet repliceerbaar) en branded frameworks waarvan de naam je merk meedraagt.
Ook interactieve tools en calculators die interactie op jouw site vereisen, persoonsgebonden thought leadership en dynamische content zoals realtime dashboards.
Bij elk van deze types is attributie ingebakken in plaats van afhankelijk van de goodwill van het model.
Hoe verklein ik mijn afhankelijkheid van attributie?
Bouw waardestromen die niet via de AI lopen. Een e-maillijst en community capteren waarde vóór de AI-tussenkomst.
Diensten, consulting en producten leunen op je expertise in plaats van op losse content.
Verweef tegelijk je merk zo diep in je content dat synthese het meeneemt.
Investeer in consistente, autoritaire aanwezigheid die volgende AI-modellen voedt, ook als die invloed niet expliciet gecrediteerd wordt.
Hulp nodig?
Wil je dit vertalen naar uitvoering?
Bekijk hoe we dit aanpakken met AI-vindbaarheid, of neem contact op voor een eerste blik op je AI-attributie.
Verder lezen
100 GEO-tips om genoemd te worden in ChatGPT en Google AI
- 10 hoofdstukken:van robots.txt en Bing tot meten
- Copy-paste:regex voor Search Console en GA4
- Sjablonen:koopvragen per fase en een 30-dagenplan
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.