
SEO & GEO
Welke prompts moet je tracken? Een representatieve promptset opbouwen

Kopieer voor AI
Track de prompts die je kopers echt aan AI stellen, niet je populairste zoekwoorden.
Wie prompts trackt voor AI-zichtbaarheid, meet met een vaste selectie koopvragen. Die spreid je over funnelfases, branches en regio’s.
Het verdict: een representatieve promptset meet of AI je merk noemt op de momenten die tot omzet leiden. Hij is scherp gekozen, consequent herhaald en elk kwartaal gesnoeid.
Hieronder staat hoe je zo’n set opbouwt, hoe groot hij moet zijn en hoe je hem onderhoudt.
Dit hoort bij het bredere kader uit onze gids over Generative Engine Optimization.
Waar GEO bepaalt hoe je zichtbaar wordt in AI-antwoorden, bepaalt je promptset of je die zichtbaarheid betrouwbaar kunt meten.
Wat is een promptset en waarom is hij belangrijk?
Een promptset is de vaste lijst vragen die je periodiek aan AI-systemen stelt.
Zo meet je of, hoe en in welke context je merk wordt genoemd.
Het AI-equivalent van een keywordlijst
Een promptset is het AI-equivalent van een keywordlijst in klassieke SEO. Met één belangrijk verschil: een prompt is een volledige vraag in natuurlijke taal, geen losse term.
Mensen typen in ChatGPT of Perplexity geen “fleet management software”.
Ze typen bijvoorbeeld: “wat is de beste fleet management software voor een transportbedrijf in Belgie”.
Die vragen worden ook steeds langer, zoals we zagen in ChatGPT-zoekopdrachten worden langer.
Waarom de set je meetlat is
Je set bepaalt wat je überhaupt kunt zien.
Meet je de verkeerde vragen, dan krijg je een geruststellend of alarmerend rapport.
Maar dat rapport heeft niets met je echte commerciële positie te maken.
Een merk kan glansrijk scoren op brede informatievragen.
En tegelijk volledig onzichtbaar zijn zodra een koper om een concrete aanbeveling vraagt.
Kort gezegd: de promptset is geen administratief detail, maar de meetlat zelf.
Welke prompts moet je tracken?
Track de prompts waarin een koper een keuze maakt, vergelijkt of om een aanbeveling vraagt.
Daar wordt jouw zichtbaarheid omgezet in een lead.
Begin bij je salesteam, niet bij zoekvolume
Begin niet bij zoekvolume.
Begin bij de vragen die je salesteam dagelijks hoort.
Het helpt als je je ideaal klantprofiel scherp hebt. Dan weet je wie die vragen stelt.
De vier types prompts
Vier types horen in elke serieuze set:
- Categorievragen. “Beste [categorie] voor [type bedrijf]” of “welke [oplossing] kies ik voor [situatie]”. Dit zijn de aanbevelingsmomenten waar je genoemd wilt worden.
- Vergelijkingsvragen. “[Merk A] vs [Merk B]” of “alternatieven voor [bekende speler]”. Hier bepaalt AI of jij in de overwegingsset zit.
- Probleemvragen. “Hoe los ik [probleem] op”. Hier kan AI jouw aanpak of merk naar voren schuiven als oplossingsrichting.
- Merkvragen. “Wat doet [jouw merk]” of “is [jouw merk] betrouwbaar”. Hier check je of AI jou correct en consistent beschrijft.
Zo ziet een categorievraag er in de praktijk uit
Een categorievraag levert een shortlist op. In onze eigen ChatGPT-test zie je naam, volgorde en label per tool:
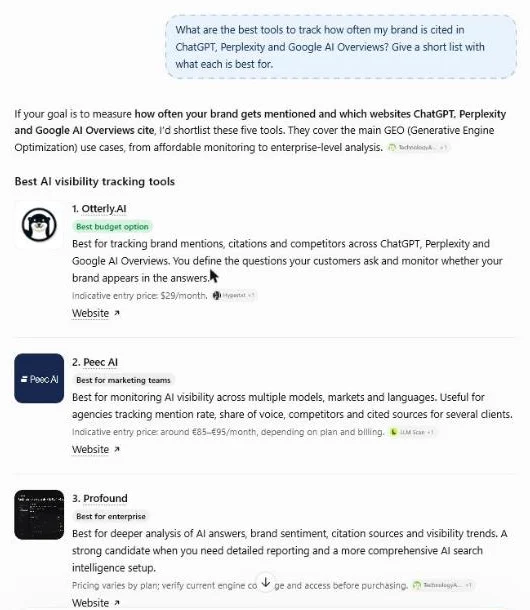 Onze eigen ChatGPT-test van 17 oktober 2026. Naam, volgorde en label gaan elk in een eigen kolom.
Precies dat antwoord wil je per prompt vastleggen: sta je erin, en met welke beschrijving?
De grootste fout: informatievragen
De grootste fout is de set vullen met algemene informatievragen, omdat die het meeste “volume” lijken te hebben.
Een vraag als “wat is e-mailmarketing” levert een keurig antwoord op.
Maar zelden een merknaam, en nooit een lead.
Bij Customer Impact sturen we klanten weg van die vanity metrics. We meten zichtbaarheid op de vragen die kopers stellen vlak voordat ze contact opnemen.
Hoe verdeel je prompts over de funnel?
Spreid je prompts bewust over de drie funnelfases. Dan zie je waar je zichtbaarheid afhaakt.
Veel merken zijn prima zichtbaar bovenaan de funnel. En ze verdwijnen precies waar de beslissing valt.
Door per fase te meten, maak je dat gat zichtbaar. Anders middel je het weg tot een vaag totaalcijfer.
De drie fases
Zo vul je elke fase:
- TOFU (bewustwording). Brede probleem- en hoe-vragen. Hier wil je genoemd of geciteerd worden als bron, niet per se als product. Een handvol prompts volstaat.
- MOFU (overweging). Categorie- en vergelijkingsvragen. Dit is de kern van je set: hier beslist AI of je in de shortlist zit.
- BOFU (beslissing). Concrete koop-, prijs- en aanbiedervragen, vaak met regio of branche erin. “Wie kan [dienst] leveren in [regio]”. Hier telt elke vermelding direct.
Dezelfde fase-indeling gebruik je voor gewone zoekwoorden. Zie zoekwoorden per funnelfase.
Een gezonde verdeling voor B2B
Voor B2B ligt het zwaartepunt bewust bij MOFU en BOFU, omdat daar de aankoopbeslissingen vallen.
Een gezonde verdeling is grofweg zo:
Een kwart TOFU, de helft MOFU en een kwart BOFU. Pas dat aan je eigen koopreis aan.
Hoe je die fases verder invult, staat in onze uitwerking over GEO voor B2B.
Hoe houd je rekening met branche en regio?
Voeg branche, bedrijfstype en regio expliciet toe aan je prompts.
AI-antwoorden verschillen sterk per context.
Een generieke vraag verbergt waar je echt sterk of zwak staat.
Eén kernvraag, meerdere varianten
“Beste boekhoudsoftware” geeft een ander antwoord dan “beste boekhoudsoftware voor een eenmanszaak in Vlaanderen”.
Komen je klanten vooral uit een specifieke sector of regio? Dan moet je set die context dragen.
Werk daarom met varianten van dezelfde kernvraag. Wissel telkens één dimensie:
- de branche
- het bedrijfsformaat
- de taal
- de regio
Zo zie je niet alleen of je genoemd wordt, maar ook waar je positie wegvalt.
Het Belgische taalrisico
Een merk dat in het Nederlands sterk scoort, kan in een Franstalige variant van dezelfde vraag onvindbaar zijn.
In Belgie is dat een reeel risico. Neem dus minstens je belangrijkste kernvragen in beide talen op.
Dit raakt aan hoe AI bepaalt wie relevant is voor welke context. Dat is het onderwerp van onze vijf kernindicatoren van AI-zichtbaarheid.
Hoe groot moet je promptset zijn?
Zo klein als verantwoord en zo groot als nodig.
Het doel van monitoring is sturen.
Je kunt alleen sturen op een set die je werkelijk begrijpt en regelmatig nakijkt.
Een cluster per kernthema
Een werkbare aanpak is per kernthema een kleine cluster te bouwen:
- een categorievraag
- een of twee vergelijkingsvarianten
- een branche- of regiovariant
Heb je vijf tot tien commercieel relevante thema’s? Dan land je vanzelf op een set die compleet is zonder onhanteerbaar te worden.
Liever dertig tot zestig scherpe prompts die je consequent volgt, dan honderden varianten die niemand nog interpreteert.
Waarom te weinig prompts misleidt
Maar een te kleine set is net zo misleidend als een te grote.
Onze ervaring: we starten een baseline rond 100 niet-merkgebonden vragen uit het midden en de onderkant van de funnel. Tien vragen zijn te weinig om statistisch iets te zeggen: liever honderd dan tien.
Voor onze eigen site meten we 125 vragen over het kiezen van een bureau. Perplexity noemt Customer Impact in 16 daarvan, tegenover 7 bij de start.
Dat verschil zie je pas met genoeg vragen.
Op tien prompts zou het één of twee vermeldingen zijn, en dus ruis.
Waarom AI-antwoorden herhaling vragen
AI-antwoorden variëren tussen modellen en zelfs tussen herhaalde vragen.
OpenAI geeft zelf aan dat zijn API standaard niet-deterministisch is: de output kan per aanvraag verschillen.
Onderzoek van SparkToro en Gumshoe toont hoe groot dat is. Bij herhaalde runs van dezelfde vraag gaven ChatGPT en Google minder dan 1 keer op 100 dezelfde lijst merken.
Dezelfde lijst in dezelfde volgorde kwam zelfs minder dan 1 keer op 1.000 voor.
Ook Google zelf zegt dat AI Overviews en AI Mode verschillende modellen kunnen gebruiken. Daardoor variëren de antwoorden en links.
Wat dat betekent voor je meting
Meet dus elke prompt op meerdere systemen en met herhaling.
En kijk naar hoe vaak je genoemd wordt, niet naar je exacte positie in de lijst. Dat aandeel is stabieler. Hoe je het meet, staat in AI share of voice meten.
Rekenvoorbeeld: 40 prompts op 3 systemen met 5 herhalingen zijn al 600 antwoorden per meetronde. Een compacte set is daarom ook betaalbaarder om consequent te draaien.
Consistentie weegt zwaarder dan omvang
Belangrijker dan de omvang is consistentie: dezelfde prompts, op vaste momenten. Dan krijgen verschuivingen betekenis.
Eenmalig honderd vragen stellen is een momentopname, geen monitoring.
Welke platforms en meetmethodes daarbij passen, vergelijken we in ons overzicht van AI-zichtbaarheidstools en in de beste GEO-tools.
Liever eerst handmatig proberen? Lees AI-zichtbaarheid meten zonder tools.
Hoe onderhoud je je promptset?
Behandel je promptset als een levend document dat je elk kwartaal herziet.
Koopgedrag en de manier waarop mensen AI bevragen veranderen sneller dan klassieke zoekgewoonten. Een set die je een jaar ongewijzigd laat, meet langzaam de verkeerde werkelijkheid.
Drie bronnen voor je herziening
Drie bronnen voeden die herziening:
- Je salesteam: nieuwe bezwaren en vragen van prospects zijn vaak nieuwe prompts.
- De AI-antwoorden zelf: de vervolgvragen en gerelateerde onderwerpen tonen hoe kopers verder denken.
- Je concurrenten: duikt er een nieuwe speler op in de vergelijkingsantwoorden, dan hoort die in je vergelijkingsprompts.
Kijk ook naar de bronnen achter het antwoord
De bronnen onder een antwoord vertellen welke sites het model raadpleegt. In Perplexity zie je ze met één klik:
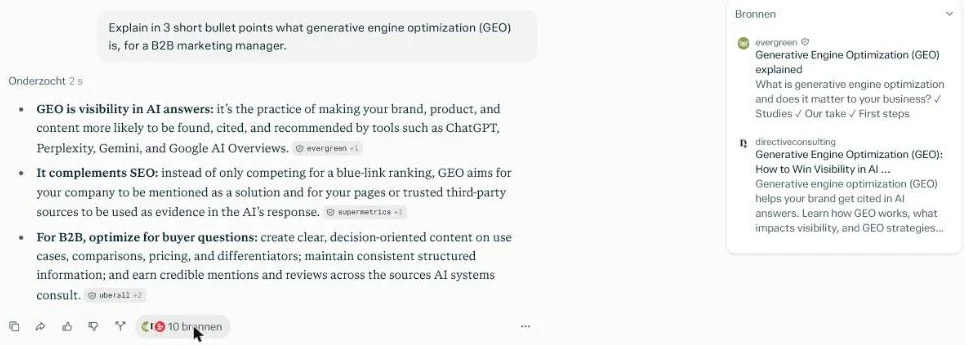 De 10 bronnen achter het antwoord van Perplexity, één klik vanaf de voettekst, oktober 2026.
Komt dezelfde vergelijkingssite, bijvoorbeeld een reviewplatform, steeds terug? Dan is dat een spoor voor nieuwe prompts en voor je contentplan.
Snoeien is net zo belangrijk als toevoegen
Verwijder net zo goed prompts die geen bruikbaar signaal meer geven.
Een scherpe set blijft scherp door snoeien, niet alleen door toevoegen.
Geef verandering tijd
Verwacht niet na één meetronde een verschuiving.
Onze ervaring: AI-antwoorden zijn probabilistisch. Verandering in je zichtbaarheid zie je meestal over drie tot zes maanden.
Realistische tijdlijnen per fase staan in hoe lang GEO duurt.
Zet je resultaten daarom op een tijdlijn. Hoe je dat bouwt, staat in een GEO-dashboard bouwen.
Wil je dit meten zonder zelf modellen te leren begrijpen? Dan helpt onze dienst voor AI-vindbaarheid je een representatieve set op te zetten en de signalen te vertalen naar concrete acties.
De korte samenvatting
Een goede promptset meet je echte commerciële positie in AI-antwoorden, niet je kansen op brede informatievragen.
Vertrek vanuit de vragen die kopers stellen. Spreid ze over funnelfases, branches en regio’s, houd de set beheersbaar en herzie hem elk kwartaal.
Zo wordt AI-zichtbaarheid een stuurbaar getal in plaats van een geruststellend rapport.
Twijfel je of AI-crawlers je site wel mogen lezen? Test het met de gratis AI-zichtbaarheidscheck, of neem contact op en we bouwen samen een promptset die meet wat voor jouw bedrijf telt.
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.