
Website & Development
AI-ready website-checklist: 25 technische punten voor oplevering

Kopieer voor AI
Een AI-ready website is een site die AI-crawlers schoon kunnen ophalen, lezen en begrijpen.
Het is geen visuele truc, maar een lijst concrete bouwbeslissingen: hoe je rendert, wat je in de HTML zet, welke crawlers je toelaat en hoe snel je laadt.
Het verdict: deze AI-ready website checklist telt 25 technische punten. Loop ze af voor oplevering, want zonder schone techniek leest geen enkel model je beste content.
Het gaat over de bouw en de techniek, niet over je inhoudelijke GEO-strategie.
Die twee zijn complementair.
Waarom is de techniek bepalend voor AI-vindbaarheid?
Omdat een AI-model alleen kan citeren wat het schoon kan ophalen en parsen.
Hoe AI-crawlers je site lezen
Tools als ChatGPT, Perplexity en Google’s AI-overzichten sturen crawlers naar je site.
Die halen de HTML op en proberen te begrijpen waar je pagina over gaat.
Lukt dat ophalen niet, dan val je af voor je inhoud ooit beoordeeld is.
Hetzelfde gebeurt als de bot een lege pagina krijgt die pas in de browser met JavaScript wordt opgebouwd.
Kort: de techniek is de toegangspoort. Ze bepaalt of je überhaupt meespeelt.
Onze ervaring: in de logbestanden die we voor grotere bedrijven analyseren, groeit het aantal AI-agents dat websites bezoekt jaar na jaar sterk. Sommige agents komen zelfs als gewone gebruikers in GA4 terecht.
Een dev-handoff-document
Dat maakt deze checklist een dev-handoff-document.
Je gebruikt hem los van de inhoudelijke keuzes die je in je GEO-strategie maakt. Denk aan welke onderwerpen, welke antwoorden en welke autoriteit.
Hier gaat het puur om één vraag: staat de fundering technisch goed bij oplevering?
Voor het bredere bouwproces verwijzen we naar onze gids over een B2B-website laten maken.
De 25 punten in vier blokken
De checklist valt uiteen in vier blokken. Zo verdeel je het werk over je team:
Welke punten horen bij rendering en crawltoegang?
Zorg dat je content al in de eerste HTML-respons staat, niet pas nadat JavaScript is uitgevoerd.
Waarom JavaScript een risico is
Veel AI-crawlers renderen JavaScript beperkt of helemaal niet.
Alles wat alleen client-side verschijnt, bestaat voor hen niet.
Google zegt het zelf in zijn uitleg over JavaScript SEO: “not all bots can run JavaScript”. Server-side of pre-rendering noemt Google daar nog altijd “a great idea”.
Het verschil tussen beide aanpakken lees je in server-side rendering vs client-side.
De zeven punten
Loop deze zeven punten af:
- Server-side rendering of pre-rendering. Lever de kerncontent in de initiële HTML, via SSR, static generation of pre-rendering. Een puur client-side SPA waarvan de tekst pas na laden verschijnt, is risicovol voor crawlers.
- Belangrijke tekst staat in de HTML-bron. Controleer met “view source” of je koppen, paragrafen en links zichtbaar zijn zonder dat de browser scripts draait.
- Een correcte robots.txt. Blokkeer geen mappen of resources die crawlers nodig hebben, en laat de AI-crawlers toe die je zichtbaarheid willen geven.
- Bewuste keuze per AI-crawler. User-agents als GPTBot en OAI-SearchBot (OpenAI), ClaudeBot (Anthropic) en PerplexityBot kun je apart toelaten of weren.
- Een actuele XML-sitemap. Genereer hem automatisch, houd hem schoon (alleen indexeerbare, canonieke URL’s) en verwijs ernaar in robots.txt.
- Geen onbedoelde noindex of crawlblokkades. Een vergeten noindex-tag of een staging-blokkade die meeverhuist naar productie is een klassieker bij oplevering. Check elke template.
- HTTP-statuscodes kloppen. Levende pagina’s geven 200, verwijderde 410 of 404, verhuisde een 301. Zachte 404’s (een 200 op een lege pagina) verwarren crawlers.
Google-Extended is geen crawler
Bij punt 4 hoort een belangrijke nuance.
Google-Extended is geen aparte crawler, maar een robots.txt-token. Volgens Google regelt het alleen Gemini-training en grounding.
Het heeft geen invloed op je opname in Google Zoeken.
Zo ziet een open robots.txt eruit
Onze eigen robots.txt is kort. Kijk naar de ene regel voor alle crawlers en de sitemapregel eronder:
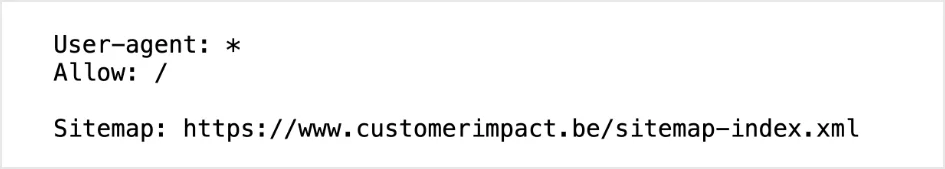 De robots.txt van customerimpact.be, oktober 2026: één regel die elke crawler toelaat, plus de sitemap.
Zo mag elke AI-bot de site lezen, voor training en voor zoeken. Hoe je crawlers gericht toelaat, lees je in AI-crawlers toelaten en optimaliseren.
Controleer statuscodes in Search Console
Voor punt 7 kijk je in de crawlstatistieken. De verdeling per respons toont hoeveel verzoeken op een 301 of 404 uitkomen:
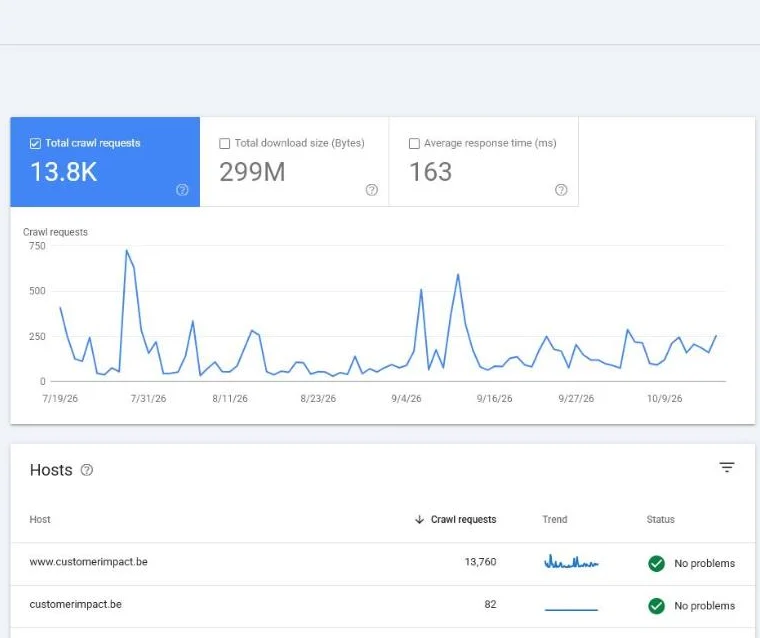 Crawlstatistieken in onze eigen Search Console voor customerimpact.be, oktober 2026. Veel 404’s of trage antwoorden raken elke crawler.
Hoe je dat rapport leest, staat in crawlstatistieken in Search Console.
Hoe maak je de structuur machineleesbaar?
Met semantische HTML die de betekenis van elk element expliciet maakt, niet alleen de opmaak.
Een model leidt de structuur van je pagina af uit je markup.
Hoe duidelijker die is, hoe beter het je content kan ontleden.
De acht punten
Controleer deze acht punten per template:
- Eén logische H1 per pagina die de hoofdvraag of het hoofdonderwerp benoemt.
- Een nette koppenhiërarchie. H2’s en H3’s volgen logisch op elkaar, zonder niveaus over te slaan. Verwoord ze als de vragen die een lezer of AI zou stellen.
- Semantische elementen zoals
header,nav,main,article,sectionenfooterin plaats van een zee aan generiekediv’s. - Beschrijvende, unieke title-tags en meta descriptions per pagina, die de inhoud eerlijk samenvatten.
- Alt-teksten op betekenisdragende afbeeldingen. Ze helpen zowel toegankelijkheid als machineleesbaarheid. Lees ook onze veelgemaakte toegankelijkheidsfouten.
- Sprekende, stabiele URL’s in plaats van cryptische parameters, en een doordachte website-architectuur waarin verwante pagina’s logisch samenhangen.
- Interne links met beschrijvende ankerteksten. Ze tonen crawlers hoe je pagina’s zich tot elkaar verhouden en welke het belangrijkst zijn.
- Antwoord-eerst opgebouwde pagina’s. Zet het directe antwoord bovenaan een sectie en bouw daarna uit. Dat maakt een passage makkelijker te citeren.
Een voorbeeld van punt 15
Stel: een sectie heet “Wat kost onderhoud per maand?”.
Begin dan met de vork in één zin, bijvoorbeeld het bedrag en wat erin zit. Pas daarna volgen de uitzonderingen.
Een AI-model kan die eerste zin los citeren, zonder de rest van de pagina.
Welke gestructureerde data hoort erbij?
Schema.org-markup in JSON-LD die machines vertelt wát een stuk content is.
Denk aan een organisatie, een artikel, een veelgestelde vraag of een product. Het is geen garantie op zichtbaarheid, maar het haalt giswerk weg.
De vijf punten
Voeg deze vijf types toe en valideer ze:
- Organization-markup met je bedrijfsnaam, logo, vestiging en contactgegevens, zodat je merk als entiteit herkenbaar is.
- Article- of BlogPosting-markup op kennisartikelen, met auteur en publicatiedatum.
- BreadcrumbList-markup die je sitestructuur expliciet maakt.
- FAQ- of Q&A-markup waar je echt vragen beantwoordt, niet als trucje op elke pagina.
- Geldige JSON-LD. Valideer elke template met een schema-validator voor oplevering. Verdiep je in schema-markup en de bredere logica van gestructureerde data om de juiste types te kiezen.
Zo valideer je de markup
Voor punt 20 gebruik je de Schema Markup Validator. Controleer of elk gedetecteerd type klopt met wat de pagina zichtbaar zegt:
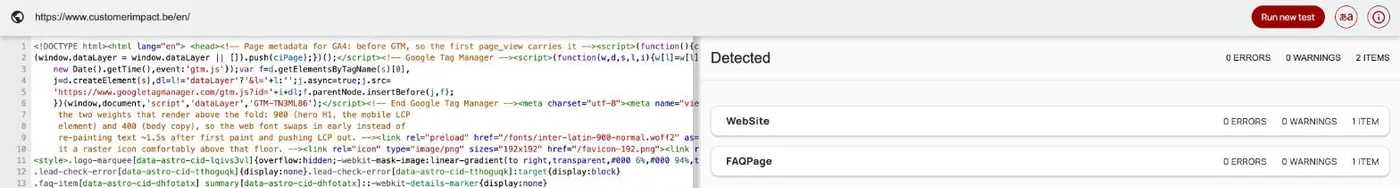 De Schema Markup Validator op onze eigen Engelse homepage, oktober 2026. Elk type moet overeenkomen met wat de pagina toont.
Foutmeldingen oplossen lees je in schema-markup valideren en fouten oplossen.
Welke performance- en techniekpunten moeten af zijn?
Snelheid, stabiliteit en veiligheid, want dat zijn crawlvoorwaarden.
Trage of foutgevoelige pagina’s worden minder vaak en minder diep opgehaald.
En een trage site kost je leads nog voor een mens iets leest.
De vijf punten
Vink deze vijf punten af voor livegang:
- Goede Core Web Vitals. Houd laadsnelheid, interactiviteit en visuele stabiliteit binnen gezonde marges. Onze uitleg over Core Web Vitals en Google Lighthouse helpt je meten.
- Mobielvriendelijk en responsive, want crawlers beoordelen doorgaans de mobiele versie (Google).
- HTTPS overal, zonder mixed-content-waarschuwingen.
- Canonical-tags die duplicaten en parametervarianten naar één voorkeurs-URL wijzen.
- Schone, consistente redirects zonder ketens of loops, zeker als je migreert van een oude site.
Eén zwak meetpunt volstaat om te falen
Core Web Vitals slaag je alleen als alle drie de metingen goed zijn. Kijk in onze eigen velddata naar LCP en CLS:
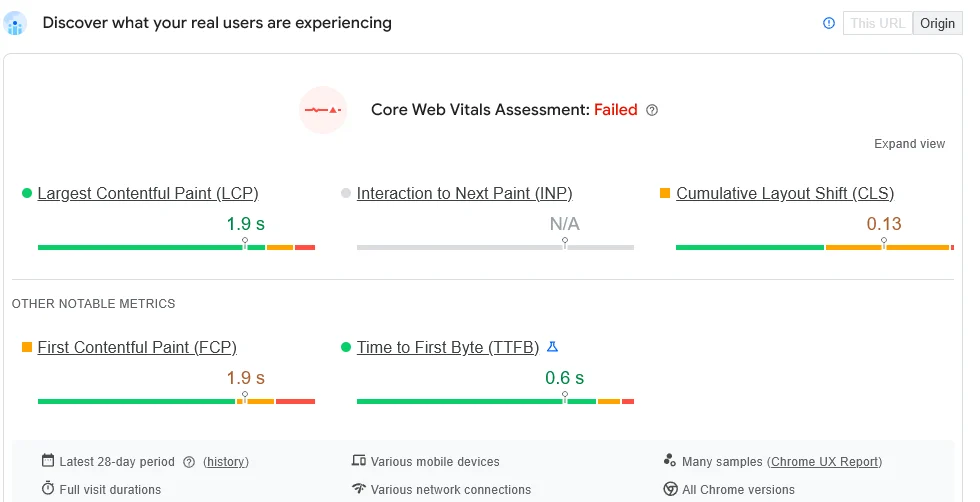 Onze eigen mobiele velddata in PageSpeed Insights, oktober 2026. LCP is goed (1,9 s), maar één zwak meetpunt (CLS 0,13) laat de beoordeling falen.
Test je eigen pagina’s met onze website-snelheidstest.
Redirects en canonicals checken
Voor punt 24 en 25 helpen twee gidsen: canonical-conflicten oplossen en redirect chains oplossen.
Een losse URL controleren gaat snel met de redirect-checker.
En llms.txt dan, moet dat erbij?
Optioneel, en met realistische verwachtingen.
Wat llms.txt is
llms.txt is een voorgesteld bestand in de root van je domein dat modellen naar je belangrijkste content wijst.
Jeremy Howard publiceerde het voorstel op llmstxt.org op 3 september 2024. Het doel: agents een korte, samengestelde wegwijzer geven, zodat ze geen volledige HTML-pagina’s hoeven te ontleden.
Waarom je er niet op bouwt
De adoptie is voorlopig laag.
Geen enkele grote AI-aanbieder leunt er officieel zwaar op.
Je verliest er weinig mee om het toe te voegen, maar reken er niet op als hoeksteen. De winst zit in de 25 punten hierboven.
Techniek opent de deur, content gaat erdoor
Belangrijk om realistisch te blijven: deze checklist maakt je site technisch klaar om gevonden te worden. Ze garandeert geen citaties.
Of een model jou kiest, hangt ook af van je inhoud, je autoriteit en je relevantie voor de vraag.
Wij sturen liever op die volledige keten dan op losse scorebordjes.
De korte samenvatting
Een AI-ready website begint bij de bouw.
Lever content in server-side HTML en geef de juiste crawlers toegang via robots.txt. Structureer je pagina’s semantisch, voeg geldige schema-markup toe en houd performance en redirects schoon.
Loop deze 25 punten af als technische opleveringschecklist, gescheiden van je inhoudelijke strategie. Voor de SEO-kant van livegang gebruik je de checklist om je website live te zetten.
Leg naast de techniek ook vast wat er in je website-contract en SLA hoort. Dan zijn oplevering, eigendom en nazorg ook juridisch dichtgetimmerd.
Wil je dat een ervaren team deze fundering mee bewaakt? Bekijk hoe wij je website laten bouwen of neem contact op.
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.