
Website & Development
AI-crawlers toelaten: zo lezen GPTBot, ClaudeBot en PerplexityBot je correct

Kopieer voor AI
AI-crawlers toelaten op je website vraagt meer dan één regel in robots.txt.
Je controleert de hele ophaalketen: robots.txt, server, CDN, firewall en de manier waarop je pagina’s renderen.
Het verdict: pas als al die lagen meewerken, lezen GPTBot, ClaudeBot en PerplexityBot je content volledig. Toegang is een randvoorwaarde, geen garantie.
Hieronder: welke crawlers er zijn, waar ze in de praktijk vastlopen en hoe je je site zo instelt dat AI-modellen je echt zien.
Eerst toelaten of blokkeren?
Dit artikel is het spiegelbeeld van de blokkeer-vraag.
Twijfel je nog of je bots überhaupt wil binnenlaten? Lees dan eerst AI-bots blokkeren of binnenlaten, of het korte antwoord in moet ik AI-bots toelaten of blokkeren.
Hier gaan we ervan uit dat je gevonden wil worden. Voor de bredere context past dit binnen onze gids om een B2B-website te laten maken.
Welke AI-crawlers zijn er en wat doen ze?
Elke grote AI-aanbieder draait niet één bot, maar een kleine vloot crawlers met elk een eigen taak.
OpenAI documenteert dat zelf voor GPTBot, OAI-SearchBot en ChatGPT-User. Dat onderscheid bepaalt welke toegang je zichtbaarheid in AI-antwoorden oplevert.
Grofweg vallen ze in drie categorieën:
| Soort bot | Wat hij doet | Voorbeelden |
|---|---|---|
| Trainingscrawler | haalt content op voor een toekomstig model | GPTBot, ClaudeBot |
| Zoek- en indexcrawler | bouwt de live-index voor AI-zoeken | OAI-SearchBot, Claude-SearchBot, PerplexityBot |
| Ophaalbot voor gebruikers | haalt een pagina op bij een concrete vraag | ChatGPT-User, Claude-User, Perplexity-User |
Trainingscrawlers
Ze halen content op om een toekomstig model te verbeteren. GPTBot van OpenAI en ClaudeBot van Anthropic zijn de bekendste voorbeelden.
Anthropic schrijft dat een blokkade van ClaudeBot betekent dat toekomstig materiaal van je site uit de trainingsdata blijft.
Google-Extended is geen aparte bot maar een robots.txt-token. Volgens de crawlerdocumentatie van Google heeft het geen eigen user agent en telt het niet mee voor je ranking in Google Search.
Zoek- en indexcrawlers
Zij bouwen de live-index waaruit een AI-zoeksysteem zijn antwoorden samenstelt. Voorbeelden zijn OAI-SearchBot, Claude-SearchBot en PerplexityBot.
Perplexity zegt dat PerplexityBot websites toont en linkt in zijn zoekresultaten, en niet crawlt voor het trainen van AI-modellen.
Ophaalbots voor gebruikers
Zij halen een pagina op het moment dat iemand er een vraag over stelt, zoals ChatGPT-User, Claude-User en Perplexity-User.
Let op: Perplexity meldt dat Perplexity-User robots.txt doorgaans negeert, omdat een gebruiker de ophaling vroeg.
Welke bots je zichtbaarheid voeden
Voor B2B-zichtbaarheid zijn vooral de zoek- en ophaalbots je infrastructuur.
Zij bepalen of je merk opduikt in ChatGPT Search, in Claude-antwoorden of in een Perplexity-resultaat.
Trainingscrawlers toelaten gaat meer over de lange termijn: hoe modellen je categorie leren kennen.
Tip: de namen van deze bots veranderen geregeld. Behandel elke lijst als een momentopname en check periodiek je serverlogs op nieuwe user-agents.
Hoeveel AI-crawlers er langskomen
AI-crawlers zijn geen randverschijnsel meer. Vercel telde op zijn eigen netwerk in één maand dit aantal ophalingen:
GPTBot en Claude samen zijn goed voor bijna 940 miljoen ophalingen, volgens de analyse van Vercel. Dat is ruim een vijfde van het volume van Googlebot.
Onze ervaring: in de logbestanden die we analyseren groeit het aantal AI-agents dat websites bezoekt jaar na jaar sterk.
Hoe laat je AI-crawlers correct toe in robots.txt?
Je laat een AI-crawler toe door hem in robots.txt niet te blokkeren, of door hem expliciet toegang te geven.
Elke bot is een aparte user-agent. Een regel voor de ene raakt de andere dus niet.
Een minimale, open opzet
Zo ziet een expliciete toelating eruit:
User-agent: GPTBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: ClaudeBot
Allow: /
In de praktijk is een lege of ontbrekende Disallow al voldoende: wat niet geblokkeerd is, mag opgehaald worden.
Onze eigen robots.txt is daar een voorbeeld van:
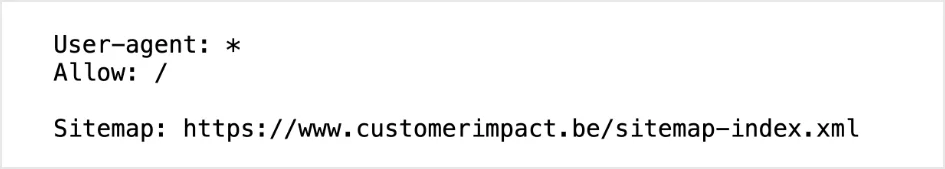 De robots.txt van customerimpact.be, oktober 2026: één regel die elke crawler toelaat, plus de sitemap.
Eén open regel voor alle user-agents, plus de sitemap. Meer hoeft niet. De basis staat in onze wiki over robots.txt.
De fout die we het vaakst zien
Een te brede Disallow: / die ooit als test is ingesteld en nooit is weggehaald.
Of een blokkade die per ongeluk alle user-agents (*) raakt.
Controleer dus niet alleen of je de juiste bots toelaat. Kijk vooral of een algemene regel ze niet stilletjes buitensluit.
Sturen per contenttype
Laat je publieke kennis- en dienstenpagina’s open. Sluit enkel echt afgeschermde paden af, zoals klantportalen of betaalde rapporten.
Die afweging per pad werkten we uit in het blokkeer-artikel.
Onthoud: robots.txt is een beleefde instructie, geen slot. Echt gevoelige content hoort achter een login, niet enkel achter een regel.
Waarom is robots.txt openzetten niet genoeg om AI-crawlers toe te laten?
Omdat een crawler je pagina pas leest als hij voorbij je server, CDN en firewall raakt. Juist daar lopen veel sites onbedoeld vast.
Je robots.txt kan perfect open staan terwijl een beveiligingslaag de bot alsnog tegenhoudt.
De ophaalketen in één beeld
Elke laag kan de bot stoppen:
De meest voorkomende stille blokkades
Vier lagen die we in de praktijk tegenkomen:
- Firewall- of WAF-regels die bots op user-agent of gedrag weren. Veel CDN’s markeren AI-crawlers standaard als ongewenst verkeer.
- Bot-management met een uitdaging, zoals een JavaScript-challenge of CAPTCHA. Een AI-crawler lost die niet op en geeft het op.
- Te strenge rate limiting, waardoor een bot na enkele verzoeken wordt afgekapt.
- Geoblocking of IP-beperkingen die verkeer uit datacenters weren, precies waar veel crawlers vandaan komen.
Bij een WAF-regel krijgt de bot een 403 of een challenge te zien in plaats van je content.
Controleer het in je serverlogs
Zoek op user-agents als GPTBot of PerplexityBot en kijk welke statuscode ze terugkrijgen.
Veel 200-codes betekent dat ze binnen geraken. Veel 403’s of challenges betekent dat een laag boven robots.txt ze blokkeert.
Hoe je dat aanpakt, staat in log file analyse voor SEO. De tools vergelijken we in logfile-analysetools vergelijken.
Onze ervaring: het lastigste is mensen en agents uit elkaar halen. Sommige agents komen in GA4 zelfs binnen als gewone gebruikers, dus filter ze bewust uit.
Een eerste check zonder logbestanden
Heb je geen toegang tot je serverlogs? Begin dan bij de crawlstatistieken van Googlebot in Search Console:
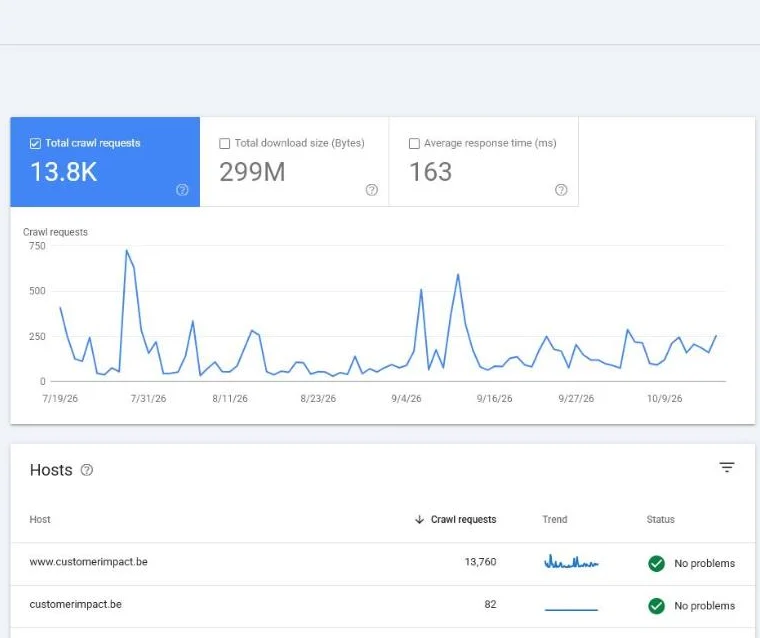 Crawlstatistieken in onze eigen Search Console voor customerimpact.be, oktober 2026.
Veel 404’s, 5xx-fouten of trage antwoorden raken elke crawler, ook de AI-bots. Uitleg bij dit rapport vind je in crawlstatistieken in Search Console.
Dit hoort bij de bredere website-architectuur en techniek die bepaalt of je überhaupt vindbaar bent.
Waarom lezen AI-crawlers mijn pagina soms half?
Omdat de meeste AI-crawlers geen JavaScript uitvoeren.
Ze lezen de HTML die je server in de eerste respons teruggeeft. Verschijnt je belangrijkste content pas na client-side rendering, dan zien ze een grotendeels lege pagina.
Wat het onderzoek van Vercel liet zien
Vercel testte het gedrag van de grote AI-crawlers. Hun conclusie: geen van de grote AI-crawlers rendert vandaag JavaScript.
Ze noemen de crawlers van OpenAI, ClaudeBot van Anthropic en PerplexityBot. Gemini is de uitzondering, omdat het de infrastructuur van Googlebot gebruikt.
Het onderschatte probleem voor B2B-sites
Een moderne single-page-applicatie kan er in een browser perfect uitzien.
Een crawler krijgt dan enkel een skelet binnen: een lege <div> en een berg scripts.
Klassieke zoekmachines zoals Google kunnen JavaScript in zekere mate renderen. Bij de huidige AI-crawlers kan je daar niet van uitgaan.
Het volledige probleem staat in client-side rendering is onzichtbaar voor AI.
Wat je content crawlbaar houdt
Vier keuzes die werken:
- Server-side rendering (SSR) of pre-rendering, zodat kernteksten, koppen en links in de eerste HTML staan.
- Statisch gegenereerde pagina’s voor content die niet per gebruiker verschilt.
- Echte HTML-elementen: tekst in
<p>, koppen in<h1>tot<h3>, navigatie in echte<a>-links. - Geen kritieke content achter interacties zoals tabs of “lees meer”-knoppen die pas met JavaScript laden.
De afweging tussen beide renderwijzen staat in server-side vs client-side rendering voor SEO.
Het platform maakt niet uit
Of je nu in WordPress, Webflow of een custom of headless stack bouwt: het gaat erom of de pagina haar inhoud server-side levert.
Een headless CMS kan prima crawlbaar zijn. Voorwaarde is een SSR- of static-laag, in plaats van alles in de browser op te bouwen.
Wij kijken bij elk webdesign-traject hoe de pagina’s renderen, niet alleen hoe ze er in een browser uitzien.
Hoe maak je je content niet alleen leesbaar maar ook bruikbaar?
Toegang en rendering zorgen dat een crawler binnenkomt en je tekst ziet.
Of je daarna correct begrepen en geciteerd wordt, hangt af van hoe duidelijk je content gestructureerd is.
Snelle, stabiele pagina’s
Trage of foutgevoelige pagina’s worden minder volledig opgehaald.
Goede Core Web Vitals helpen niet alleen je bezoekers, maar ook bots die binnen een tijdsbudget werken.
Opgelet: volgens Vercel eindigde ongeveer 34% van de ophalingen door ChatGPT en Claude op een 404, tegenover 8,22% bij Googlebot. Ruim oude URL’s en redirectketens dus op.
Een heldere koppenstructuur
Een logische hiërarchie van H2’s en H3’s maakt je content makkelijker te ontleden en te citeren.
Formuleer ze als de vragen die je doelgroep stelt. Hoe semantische opmaak daarbij helpt, lees je in semantische HTML voor AI-extractie.
Gestructureerde data
Met schema-markup geef je modellen expliciete context: wie je bent, wat je aanbiedt en hoe je pagina’s samenhangen.
Controleer of die markup klopt, bijvoorbeeld met de Schema Markup Validator:
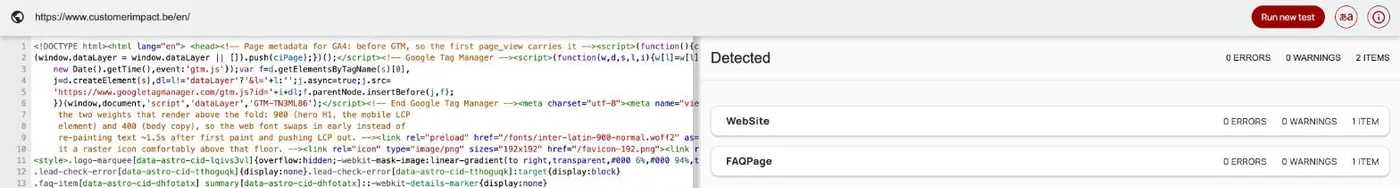 Schema Markup Validator op onze eigen pagina customerimpact.be/en/, oktober 2026: 0 fouten en 0 waarschuwingen.
Een schone sitemap en interne links
Zo vinden crawlers al je relevante pagina’s en begrijpen ze hoe je site in elkaar zit.
Een volledige lijst om je site te toetsen staat in is je website leesbaar voor AI.
Toegang is geen citatie
Dit is waar techniek en zichtbaarheid samenkomen. De crawl-laag is een randvoorwaarde.
Wat je er inhoudelijk mee doet, hoort bij generative engine optimization.
Toegang geven betekent niet automatisch dat je geciteerd wordt. Het betekent dat je in aanmerking komt.
De korte samenvatting
AI-crawlers toelaten is geen schakelaar maar een keten.
De drie lagen: zet robots.txt open voor de bots die je zichtbaarheid voeden, controleer dat server, CDN en firewall ze niet stilletjes blokkeren, en lever je kerncontent server-side in de HTML.
Pas als die lagen kloppen, lezen GPTBot, ClaudeBot en PerplexityBot je volledig. Structuur en snelheid bepalen daarna of je geciteerd wordt.
Wil je weten of jouw site technisch klaar is voor AI-crawlers, en of dat ook leads kan opleveren? Neem contact op en we kijken eerlijk mee.
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.