
Website & Development
Waarom JavaScript-websites onzichtbaar zijn voor AI-zoekmachines
 Tanguy De Keyzer Oprichter & digitale strateeg · Bijgewerkt 12 november 2026 · ◷ 10 min leestijd
Kopieer voor AI
Een volledig client-side gerenderde website is praktisch onzichtbaar voor AI-zoekmachines.
AI-crawlers zoals GPTBot (ChatGPT), ClaudeBot en PerplexityBot halen alleen de ruwe HTML op. Ze voeren geen JavaScript uit.
Bouwt je site de inhoud pas in de browser op, dan zien die crawlers een lege huls.
Het verdict: goed ranken in Google bewijst niet dat AI je pagina kan lezen. Server-side rendering (SSR) of static site generation (SSG) is de structurele oplossing voor client-side rendering en AI-zoekmachines.
Wat is client-side rendering precies?
De server stuurt een bijna lege HTML-pagina, en JavaScript bouwt de echte inhoud pas in de browser op.
De bezoeker krijgt eerst een kaal skelet. Daarna laden scripts de teksten, koppen en links in.
Veel single-page applications (SPA’s) werken standaard zo. Ze stellen alles in de browser samen. Wat JavaScript zelf is, lees je in onze wiki.
Wat een mens ziet
Voor een mens is dat onzichtbaar. Het script draait in een fractie van een seconde en je ziet een volledige pagina.
Wat een crawler ziet
Het verschil zit in wat een geautomatiseerde bezoeker krijgt.
Een crawler die de pagina ophaalt maar geen JavaScript uitvoert, blijft hangen op dat lege skelet.
Dat verschil tussen ruwe en gerenderde HTML beschrijven we ook in JavaScript SEO: waarom Google je content soms niet ziet.
Bij AI-zoekmachines is de impact nog harder.
Waarom zien AI-crawlers mijn JavaScript-content niet?
Omdat de grote AI-crawlers geen JavaScript draaien.
Ze vragen je pagina op, lezen de HTML die de server direct teruggeeft, en stoppen daar. Alles wat pas via JavaScript verschijnt, bestaat voor hen niet.
Wat Vercel mat
Onderzoek van Vercel naar AI-crawlers op zijn netwerk is duidelijk: “none of the major AI crawlers currently render JavaScript.”
Dat geldt onder meer voor:
- de bots van OpenAI, zoals GPTBot en OAI-SearchBot
- ClaudeBot van Anthropic
- PerplexityBot
Het volume is niet klein. Zo vaak haalden die crawlers in één maand pagina’s op bij Vercel:
Fetches per crawler in één maand op het netwerk van Vercel. Grafiek: Customer Impact, november 2026.
Welke OpenAI-bot doet wat?
OpenAI gebruikt niet één crawler, maar drie (OpenAI over zijn crawlers):
- GPTBot: verzamelt content die kan dienen om de modellen te trainen.
- OAI-SearchBot: toont websites in de zoekfuncties van ChatGPT.
- ChatGPT-User: bezoekt een pagina wanneer een gebruiker iets vraagt.
Voor je zichtbaarheid in antwoorden telt vooral OAI-SearchBot. Maar alle drie lezen ruwe HTML, dus de renderkwestie geldt voor elk van hen.
Ophalen is niet uitvoeren
Sommige crawlers halen je JavaScript-bestanden wel óp. Volgens Vercel was dat bij ChatGPT 11,5% van de requests en bij Claude 23,84%.
Maar ze voeren die bestanden niet uit. Het resultaat is hetzelfde: client-side gerenderde inhoud komt niet binnen.
Alleen Gemini, dat op de infrastructuur van Googlebot draait, en AppleBot renderen wel.
Wat dat kost
Concreet blijven je productomschrijvingen, dienstpagina’s, cases en FAQ-antwoorden onzichtbaar voor het model dat je prospect raadpleegt.
Vraagt iemand ChatGPT of Perplexity naar een leverancier zoals jij? Dan kun je niet worden meegenomen. De AI heeft je inhoud nooit kunnen lezen.
Precies zo’n blokkade probeert generative engine optimization weg te nemen.
Toelaten is niet hetzelfde als lezen
Veel teams checken alleen hun robots.txt. Die bepaalt wie binnen mag, niet wat een bot leest.
Onze eigen robots.txt laat elke crawler toe, ook GPTBot:
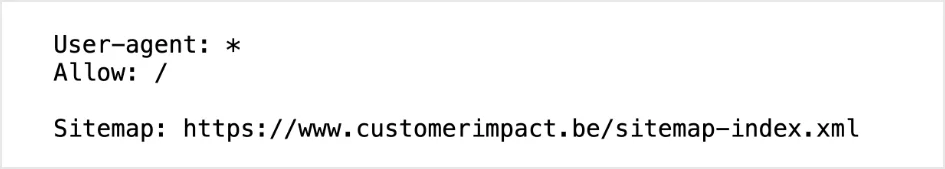 De robots.txt van customerimpact.be, oktober 2026: één regel die alle crawlers toelaat, plus de sitemap.
Meer daarover in AI-crawlers toelaten en optimaliseren en AI-bots blokkeren met robots.txt.
Een open deur helpt pas als er ook iets te lezen valt.
Maar ik sta toch wel in Google? Hoe kan dat dan?
Omdat Googlebot een van de weinige crawlers is die JavaScript wél rendert.
Juist dat maakt het probleem zo verraderlijk.
Google rendert in een aparte stap
Google verwerkt JavaScript-sites in drie fases: crawlen, renderen en indexeren (Google over JavaScript SEO).
Pagina’s wachten in een rij. Daarna rendert “a headless Chromium” de pagina en voert het de JavaScript uit.
Zo kan een client-side site prima ranken in de klassieke Google-resultaten.
AI-crawlers slaan die stap over
De crawlers van OpenAI, Anthropic en Perplexity doen die renderstap niet.
Dus ontstaat een kloof: dezelfde pagina die Google volledig begrijpt, is voor ChatGPT en Perplexity een leeg vel.
Google waarschuwt er zelf voor: server-side of pre-rendering “is still a great idea”, want “not all bots can run JavaScript.”
Ook binnen Google verschuift het
Functies zoals AI-overzichten leunen op wat Googlebot kan ophalen.
Maar generatieve antwoorden buiten Google, in losstaande AI-tools, hangen volledig af van je ruwe HTML.
Wie alleen op Google stuurt, mist de kopers die in een chatinterface zoeken.
Hoe controleer ik of mijn site dit probleem heeft?
De snelste test kost een halve minuut.
Test 1: bekijk de paginabron
Open je pagina en klik op “paginabron bekijken” (view-source, niet de inspector).
Zoek naar je H1, je belangrijkste tekst en je dienstomschrijving. Staat die tekst er niet letterlijk in? Dan wordt ze waarschijnlijk client-side ingeladen.
Bij ons: op 4 november 2026 haalden we deze pagina op met de user-agent van GPTBot. De H1 stond al in de ruwe HTML van 90 KB, zonder dat er één script hoefde te draaien.
Een voorbeeld
Stel: een SaaS-bedrijf bouwde zijn marketingsite als single-page application. In de browser staat een volledige dienstpagina met prijzen, cases en een FAQ.
In de paginabron staat alleen een lege <div id="root"> en vijf scripttags.
Google rankt die pagina, want Googlebot rendert ze. ChatGPT en Perplexity zien er niets van. Vraagt een prospect welke tools er bestaan in die categorie, dan ontbreekt dit bedrijf.
Drie aanvullende checks
Gebruik daarna deze controles:
- Vergelijk ruwe en gerenderde HTML. Zie je in de view-source vooral een leeg skelet met scripttags? Dan render je client-side.
- Schakel JavaScript uit in je browser en herlaad de pagina. Wat overblijft, ziet ook een AI-crawler.
- Kijk per pagina. Het verschil zit vaak in diepere dienst- en productpagina’s die je leads moeten opleveren.
Een volledige lijst controles staat in is je website leesbaar voor AI.
Rendering staat zelden op zichzelf. Bekijk daarom ook je website-architectuur en SEO als geheel.
Hoe los ik client-side rendering op?
Zet je belangrijkste content op de server of bij het bouwen klaar, niet pas in de browser.
Daarvoor heb je grofweg twee routes.
Route 1: server-side rendering (SSR)
De server stelt de volledige pagina samen. Bezoeker en crawler krijgen kant-en-klare HTML.
Er is geen extra renderstap nodig, dus er kan niets misgaan in de browser van een bot.
Past bij: inhoud die vaak verandert of per gebruiker verschilt.
Route 2: static site generation (SSG)
Hier worden je pagina’s tijdens het bouwen al omgezet naar statische HTML-bestanden. Elke bezoeker, mens of crawler, krijgt direct de complete pagina.
Past bij: content die niet elke seconde wijzigt, zoals dienstpagina’s, kennisartikelen en cases. Precies de pagina’s die voor B2B-zichtbaarheid tellen.
Bij ons: customerimpact.be draait op Astro met static site generation. Elk kennisartikel staat als kant-en-klare HTML klaar.
SSR, SSG of CSR naast elkaar
Zo verhouden de drie aanpakken zich:
| Aanpak | Content in ruwe HTML | Leesbaar voor AI-crawlers | Beste voor |
|---|---|---|---|
| Client-side rendering | nee | nee | dashboards achter een login |
| Server-side rendering | ja | ja | inhoud die vaak verandert |
| Static site generation | ja | ja | dienstpagina’s, artikels, cases |
Een uitgebreide vergelijking staat in server-side vs client-side rendering voor SEO en statische vs dynamische website.
Bijvangst: snelheid
Minder client-side JavaScript betekent meestal een snellere eerste weergave. Dat helpt ook je Core Web Vitals.
Zo ziet dat er bij een statische site in de praktijk uit:
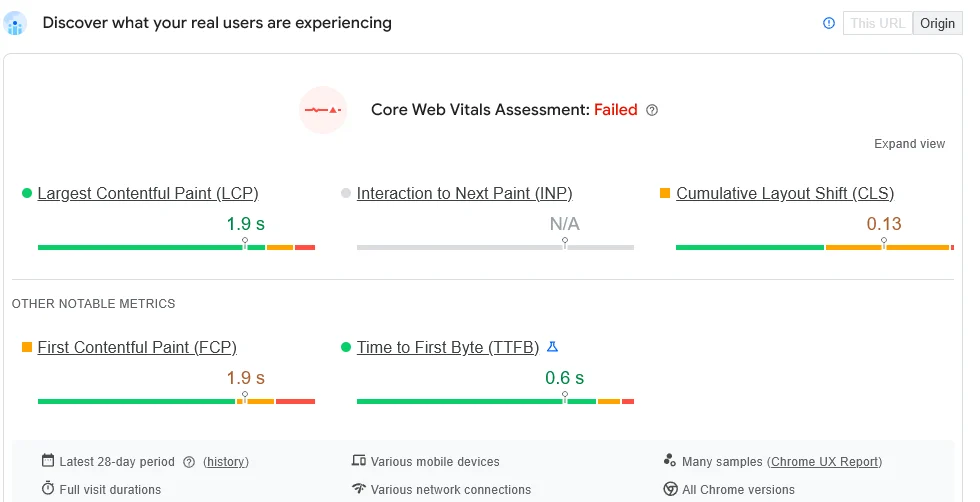 Onze eigen mobiele velddata in PageSpeed Insights, oktober 2026. LCP is goed (1,9 s), maar één zwak meetpunt (CLS 0,13) laat de beoordeling falen.
Statisch is dus snel, maar geen garantie op een groene score. Test je eigen pagina met de website snelheidstest.
Welk platform?
Welke aanpak past, hangt af van drie dingen: de hoeveelheid content, hoe vaak die verandert en hoe je team werkt.
Een headless CMS-opzet kan SSR of SSG goed ondersteunen, maar is geen voorwaarde. Ook je framework speelt mee, zie JavaScript-frameworks en SEO en het beste CMS voor AI-vindbaarheid.
Op onze pagina over website ontwikkeling lees je hoe wij die keuze per case maken.
Moet ik mijn hele site nu ombouwen?
Niet meteen, en zeker niet in paniek.
Begin bij je geldpagina’s
Begin bij de pagina’s die geld opleveren:
- je dienstpagina’s
- je belangrijkste landingspagina’s
- de content waarop je gevonden wilt worden
Staan juist díe in de ruwe HTML, dan heb je het grootste risico afgedekt.
Een interactief dashboard achter een login mag gerust client-side blijven. Daar zoekt geen AI-crawler naar.
Vuistregel: staat een pagina in je menu, je sitemap of een advertentie, dan hoort ze in de ruwe HTML. Twijfel je, open dan eerst de paginabron.
Plan rendering mee bij een nieuwe site
Plan je een grotere ingreep of een nieuwe site? Neem rendering dan vanaf het begin mee als ontwerpkeuze, niet als reparatie achteraf.
Doe je het tijdens een website-migratie, dan vang je twee vliegen in één klap. Je beschermt je bestaande zichtbaarheid en je content wordt meteen leesbaar voor AI-engines.
Stuur op leads
Onze stelling is nuchter: stuur op leads en omzet, niet op een eindeloze technische checklist.
Een pagina die niemand bezoekt en geen lead oplevert, hoeft niet als eerste herbouwd te worden.
Veelgestelde vragen over client-side rendering en AI-zoekmachines
Kan ChatGPT JavaScript lezen?
De crawlers van OpenAI halen JavaScript-bestanden soms op, maar voeren ze niet uit. Content die pas via JavaScript verschijnt, komt niet binnen.
Waarom rank ik in Google maar niet in ChatGPT?
Googlebot rendert JavaScript in een aparte stap, de AI-crawlers van OpenAI, Anthropic en Perplexity niet. Dezelfde pagina is voor hen een leeg skelet.
Wat is het verschil tussen SSR en SSG?
Bij SSR bouwt de server de pagina bij elk verzoek. Bij SSG gebeurt dat één keer tijdens het bouwen. Beide leveren complete HTML.
Moet een dashboard achter een login ook server-side renderen?
Nee. Daar zoekt geen crawler naar. Focus op publieke pagina’s die leads moeten opleveren.
De korte samenvatting
Client-side rendering laat je content pas in de browser verschijnen. De grote AI-crawlers draaien geen JavaScript.
Dus kun je vlot in Google staan en tegelijk ontbreken in ChatGPT, Claude en Perplexity.
De oplossing: zet je belangrijkste content via SSR of SSG in de ruwe HTML, te beginnen bij je leadpagina’s.
Wil je weten of je site leesbaar is voor AI-zoekmachines? Neem contact op en we kijken samen waar je nu staat.
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.