
Website & Development
Een website bouwen voor AI-vindbaarheid: de technische gids voor B2B

Kopieer voor AI
Een website bouwen voor AI-vindbaarheid begint bij leesbare HTML.
Je zet je site technisch zo op dat ChatGPT, Google AI Overviews, Perplexity en Gemini je content kunnen ophalen, begrijpen en citeren.
Het verdict: de meeste AI-crawlers voeren geen JavaScript uit. Staat je antwoord niet in de eerste HTML-respons, dan besta je niet voor het model.
Het korte antwoord heeft vier delen:
- Rendering: je kerncontent staat in de ruwe HTML, niet pas na JavaScript
- Structuur: duidelijke koppen en antwoord-eerst secties
- Markup: gestructureerde data in JSON-LD
- Toegang en snelheid: een snelle, crawlbare site
Die techniek is de bouwlaag onder je GEO-strategie. Ze hoort bij onze bredere gids over een B2B-website laten maken.
Wat betekent “bouwen voor AI-vindbaarheid”?
Het betekent dat je de techniek van je site afstemt op hoe AI-engines het web lezen.
Het doel: jouw pagina wordt de bron waar een AI-antwoord naar verwijst.
Het fundament onder GEO
Bouwen voor AI-vindbaarheid is het fundament onder GEO (Generative Engine Optimization).
GEO gaat over content, autoriteit en vermeldingen. Maar zonder een site die machines kunnen lezen, komt geen van die content ooit aan.
Kort gezegd: GEO is wat je zegt, de bouw bepaalt of het gehoord wordt.
De drie horden naar een citatie
Een AI-engine kan jouw pagina alleen citeren als die drie horden neemt:
- De crawler moet binnen mogen.
- De inhoud moet leesbaar zijn in de ruwe HTML.
- De structuur moet tonen waar het antwoord staat.
Faalt één van die drie, dan bestaat je content simpelweg niet voor het model.
Zo ziet die volgorde eruit:
De rest van dit artikel loopt die horden technisch af, van rendering tot platformkeuze.
Waarom is server-side rendering belangrijk voor AI-crawlers?
Omdat de meeste AI-crawlers geen JavaScript uitvoeren.
Dat is de belangrijkste technische realiteit van AI-vindbaarheid.
Wat Vercel in zijn crawlerverkeer zag
Vercel analyseerde het botverkeer op zijn netwerk. Bots als GPTBot, ClaudeBot en PerplexityBot halen wel HTML op, maar voeren JavaScript niet uit en wachten niet op rendering (Vercel, The rise of the AI crawler).
Het ging om grote volumes. Vercel telde in één maand dit aantal verzoeken op zijn netwerk:
Wat dit betekent: honderden miljoenen bezoeken die alleen de ruwe HTML lezen.
Wat er misgaat bij een single-page application
Bouw je je site als single-page application, dan wordt de inhoud pas in de browser samengesteld.
Zo’n crawler ziet dan vaak een vrijwel lege pagina.
Stel bijvoorbeeld dat je dienstenpagina haar tekst pas na een API-call in de browser toont. GPTBot krijgt dan alleen een lege container en een paar scripts.
Waarom Google het wel ziet en andere engines niet
Voor klassieke SEO ving Googlebot dat deels op door pagina’s alsnog te renderen. Google’s Gemini leunt op diezelfde infrastructuur.
Maar de meeste andere AI-engines doen dat niet. Wat niet in de eerste HTML-respons staat, bestaat voor hen niet.
De typische problemen lees je in onze gids over JavaScript-rendering en SEO-problemen.
De oplossing: SSR of statische generatie
De oplossing is server-side rendering (SSR) of statische generatie.
De server levert de volledige inhoud al als HTML aan, klaar om gelezen te worden.
Frameworks en platforms verschillen sterk in hoe goed ze dat standaard doen. Daarom weegt de bouwkeuze hier zwaarder dan vaak gedacht.
Het verschil tussen beide aanpakken staat in server-side vs client-side rendering.
Test het zelf met “view source”
Open een pagina en bekijk “view source”. Je kijkt naar wat een crawler zonder JavaScript krijgt.
Zie je je kernboodschap, koppen en antwoorden in de ruwe broncode? Dan ben je goed bezig.
Zie je vooral lege containers en scripts? Dan heb je werk.
Hoe helpt je site-structuur AI om je content te begrijpen?
Een heldere, ondiepe structuur met betekenisvolle koppen toont een AI-engine waar het antwoord staat.
AI-modellen lezen content niet zoals een mens een pagina scant.
Ze knippen je tekst in stukken. Dan zoeken ze het fragment dat een vraag het best beantwoordt.
Hoe duidelijker je dat fragment afbakent, hoe groter de kans dat het wordt opgepikt.
Drie dingen die helpen
Drie bouwkeuzes maken je fragmenten makkelijk te vinden:
- Koppen als vragen: H1, H2 en H3 als echte vragen of duidelijke onderwerpen, geen woordspelingen
- Antwoord eerst: elke sectie opent met een volledig antwoord van één of twee zinnen
- Platte architectuur: elke belangrijke pagina in een paar klikken bereikbaar
Bouw daarna pas uit met uitleg, voorbeelden en bewijs.
Hoe je zo’n opbouw plant, staat in onze uitleg over website-architectuur.
Interne links verbinden je onderwerpen
Interne links tonen een machine welke onderwerpen bij elkaar horen.
Link verwante pagina’s logisch aan elkaar, met beschrijvende ankertekst. Hoe dat specifiek voor AI werkt, lees je in interne links voor AI.
Dubbele winst: een mens vindt sneller wat hij zoekt, en een crawler begrijpt sneller waar je site over gaat.
Welke rol speelt schema-markup voor AI?
Schema-markup vertaalt je content naar een formaat dat machines eenduidig kunnen lezen.
Dat verlaagt de kans op een verkeerde interpretatie.
Wat je ermee vertelt
Met gestructureerde data vertel je expliciet wat er op een pagina staat:
- dit is een artikel, en dit is de auteur
- dit is een veelgestelde vraag met dit antwoord
- dit is onze organisatie
De engine hoeft dat dan niet te raden uit losse tekst.
Google noemt gestructureerde data “a standardized format for providing information about a page and classifying the page content” (Google Search Central).
Waarom JSON-LD
Het aanbevolen formaat is JSON-LD: een blokje code dat los van je zichtbare HTML in de pagina staat.
Google schrijft dat het JSON-LD “in general” aanraadt als je site-opzet dat toelaat.
Voor AI-engines is het ook het makkelijkst te verwerken, omdat het netjes gescheiden is van je opmaak.
Belangrijke types voor B2B zijn:
- Organization: wie je bent en waar je zit
- Article: het stuk, de datum en de auteur
- FAQPage: vraag en antwoord in één blok
- Person: de expert achter de tekst
Voor dat laatste type is een goede auteurspagina nodig. Zie author-schema en auteurspagina’s.
Controleer wat een machine echt ziet
De Schema Markup Validator leest je ruwe HTML en toont welke types hij vindt. Op onze eigen Engelse homepage zie je er twee:
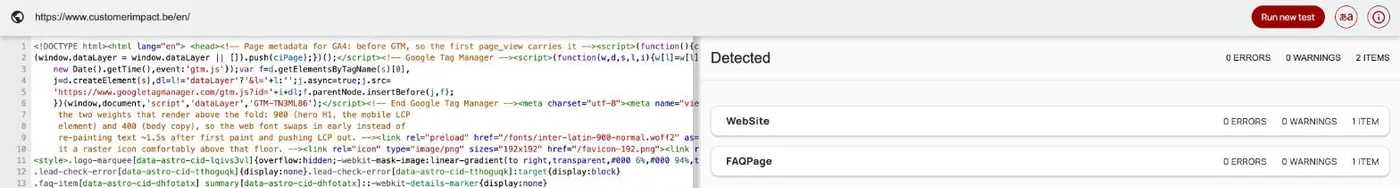 De Schema Markup Validator op onze eigen Engelse homepage, oktober 2026: WebSite en FAQPage, 0 fouten, 0 waarschuwingen.
Links staat de ruwe broncode. Precies wat een crawler zonder JavaScript leest.
De gouden regel
Je schema-markup moet altijd kloppen met wat een bezoeker op de pagina ziet.
Google zegt het letterlijk: voeg geen gestructureerde data toe over informatie die niet zichtbaar is voor de gebruiker. Anders werkt het averechts.
Maar het is een goedkope, betrouwbare manier om misverstanden te voorkomen. Dat maakt het een verstandige standaardkeuze bij de bouw.
Hoe belangrijk zijn snelheid en Core Web Vitals?
Snelheid bepaalt mee of een crawler je pagina volledig binnenhaalt en of een bezoeker blijft.
Trage of zware pagina’s worden minder grondig gecrawld. Aan de mensenkant kosten ze je conversies.
Core Web Vitals als meetlat
De Core Web Vitals van Google blijven een nuttige meetlat. Ze meten drie dingen:
- Laadsnelheid: hoe snel het grootste element verschijnt
- Interactiviteit: hoe snel de pagina reageert
- Visuele stabiliteit: of de layout verspringt
Ze dwingen je tot schone, efficiënte code.
Zo ziet dat er in de praktijk uit. In onze eigen mobiele velddata haalt de laadtijd het groen, maar één andere waarde faalt:
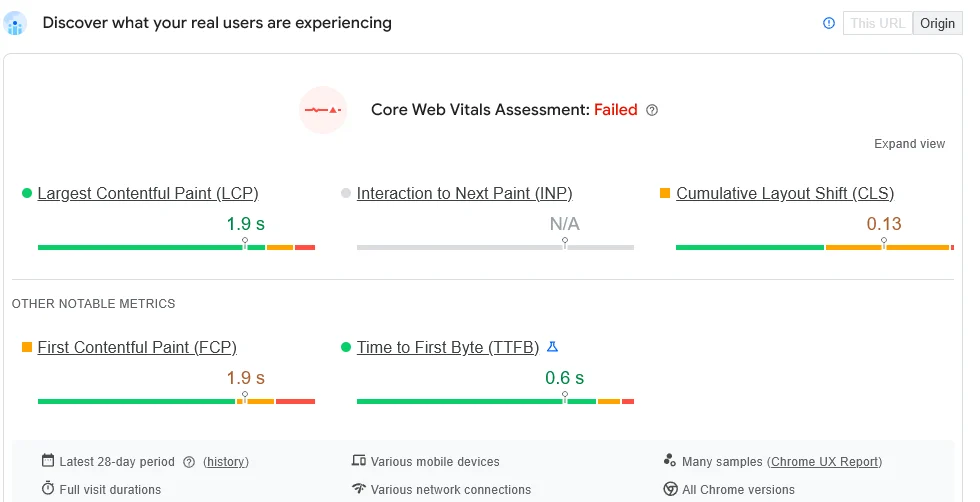 PageSpeed Insights, velddata van onze eigen site op mobiel, oktober 2026: LCP 1,9 s, TTFB 0,6 s, maar CLS 0,13 laat de beoordeling falen.
Les: één zwakke waarde volstaat om te falen. Meet daarom alle drie.
Wat telt voor AI-crawlers
Voor AI-vindbaarheid telt vooral dat je server snel een complete HTML-respons levert.
Die responstijd heet TTFB (time to first byte). Hoe je die drukt, lees je in TTFB verbeteren.
Drie dingen helpen direct:
- lichte pagina’s
- geoptimaliseerde afbeeldingen
- weinig render-blokkerende scripts
Denk aan een hero-afbeelding van enkele megabytes of een chatwidget die vóór je tekst laadt.
Een Lighthouse-rapport toont snel waar de winst zit. Je kan ook onze gratis website-snelheidstest gebruiken.
Mooi meegenomen: wat je site sneller maakt voor mensen, maakt je content ook toegankelijker voor machines. Het is dezelfde technische hygiëne.
Meer praktische ingrepen vind je in je website sneller maken.
Moet je robots.txt of llms.txt aanpassen voor AI-bots?
Ja: crawltoegang is een bewuste keuze die je expliciet maakt in je robots.txt.
Wil je dat AI-engines je citeren, dan moeten hun bots je site mogen crawlen.
Robots.txt: wie mag binnen
Per ongeluk GPTBot, ClaudeBot of PerplexityBot blokkeren betekent dat je onzichtbaar wordt in hun antwoorden.
Omgekeerd kan je bewust bepaalde bots weren, bijvoorbeeld om je content niet als trainingsdata te laten gebruiken.
Dat onderscheid bestaat echt. OpenAI gebruikt aparte bots (OpenAI, Overview of OpenAI Crawlers):
- GPTBot: content voor het trainen van modellen
- OAI-SearchBot: pagina’s tonen in ChatGPT search
- ChatGPT-User: pagina’s bezoeken op vraag van een gebruiker
Weer je OAI-SearchBot, dan verschijn je volgens OpenAI niet in de zoekantwoorden van ChatGPT. Een wijziging in robots.txt kan ongeveer 24 uur duren voor ze doorwerkt.
Zo kort kan een open robots.txt zijn. Dit is de onze:
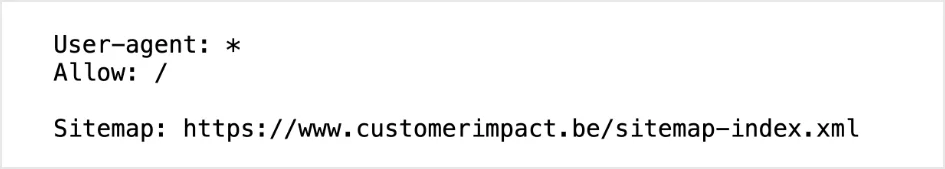 Onze eigen robots.txt, oktober 2026: één regel voor alle crawlers, dus elke AI-bot mag de site lezen.
Dat is een strategische afweging, geen technisch detail dat je per ongeluk laat staan. De afweging per bot lees je in AI-bots blokkeren met robots.txt en AI-crawlers toelaten en optimaliseren.
Llms.txt: een gok op de toekomst
Rond het voorgestelde llms.txt-bestand is meer terughoudendheid op zijn plaats.
Het is een soort inhoudsopgave speciaal voor AI. Jeremy Howard stelde het voor op 3 september 2024 (llmstxt.org).
Het blijft een community-voorstel met beperkte adoptie. Grote AI-aanbieders ondersteunen het nog niet allemaal of vragen het bestand zelfs niet op.
Wat we aanraden
Ons advies: voeg het toe als gok op de toekomst, maar reken er vandaag niet op als kanaal. Wat het bestand wel en niet doet, staat in llms.txt uitgelegd.
Investeer eerst in de basis: leesbare HTML, structuur en schema.
Kijk wie er echt langskomt
Onze ervaring: we doen veel logfile-analyse, vooral voor grotere bedrijven die willen zien hoe AI hun site gebruikt.
Het aantal AI-agents dat websites bezoekt, groeit jaar na jaar fors.
Let op: sommige agents worden in GA4 als gewone bezoeker geteld. Sluit ze correct uit, anders vertekenen ze je cijfers.
Hoe je dat aanpakt, lees je in onze gids over logfile-analyse.
Welke platformkeuze past bij AI-vindbaarheid?
Er is geen platform dat per definitie “het beste” is voor AI-vindbaarheid.
Het hangt af van hoe goed je opzet de principes hierboven haalt.
Elk platform kan het, en elk platform kan falen
Webflow, WordPress en custom of headless oplossingen kunnen allemaal server-side gerenderde, snelle, goed gestructureerde pagina’s opleveren.
Ze kunnen alle drie ook ondermaats worden ingericht.
De winnaar hangt af van je situatie:
- je team en wie de site beheert
- je content en hoeveel je publiceert
- je budget
- je groeiplannen
Een vergelijking per systeem vind je in het beste CMS voor AI-vindbaarheid.
Let op bij AI-sitebouwers: veel van die tools leveren client-side pagina’s. Waarom dat een risico is, lees je in AI-websitebouwers en AI search.
Wat altijd geldt
Vier keuzes maak je bij elke bouw bewust:
- Rendering die complete HTML levert.
- Een schone structuur.
- Kloppende gestructureerde data.
- Snelheid.
Controleer dat ook echt in de broncode, niet alleen in de browser.
Wij zijn platform-agnostisch en adviseren op basis van jouw case, niet op basis van een favoriet. Onze eigen site is volledig op maat gebouwd, maar dat is geen standaardadvies.
Hou het doel scherp
AI-vindbaarheid is pas iets waard als de citaties en bezoekers ook bij je website laten maken-pagina’s aankomen en daar in aanvragen veranderen.
Dat verkeer kan je meten. In ons eigen GA4-account zie je hoeveel sessies ChatGPT stuurde:
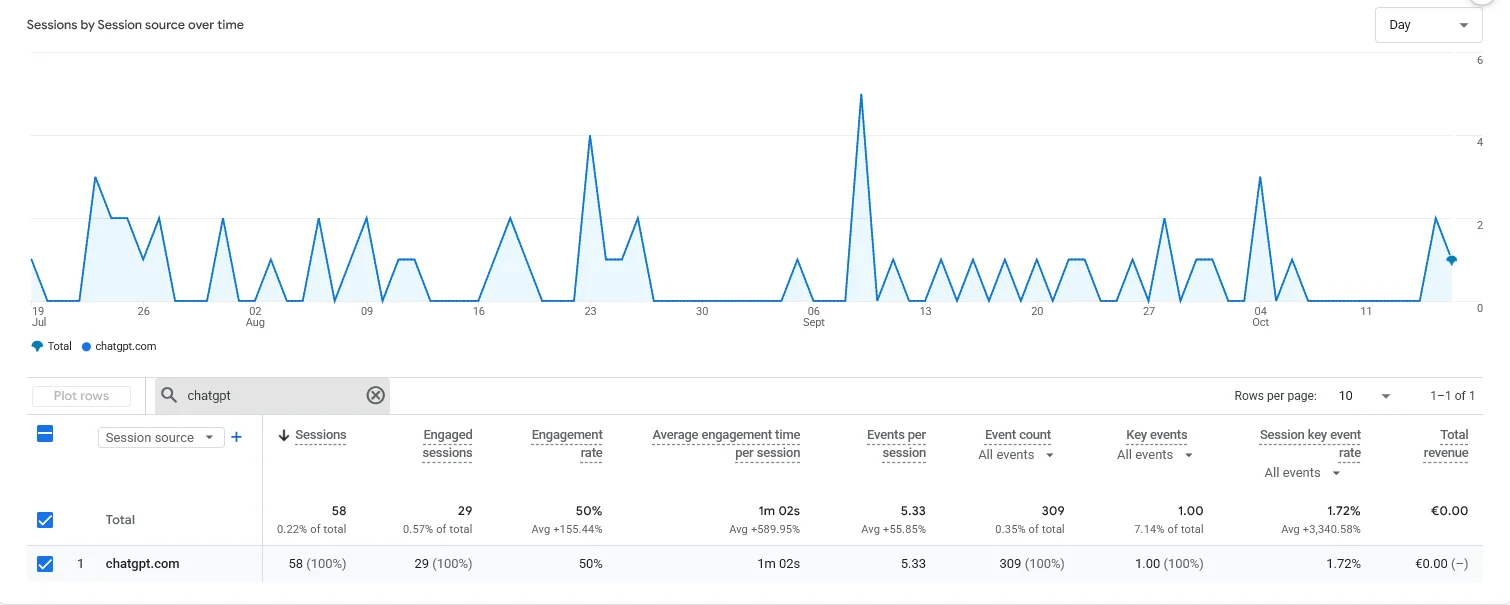 GA4 Traffic acquisition in onze eigen property, laatste 90 dagen, oktober 2026: 58 sessies van chatgpt.com en 1 key event.
Het volume is klein, maar het is meetbaar. Hoe je dat opzet, lees je in ChatGPT-verkeer meten in GA4.
Kernregel: zichtbaarheid die nergens heen leidt, staat goed in een rapport en levert niets op.
Welke beslissingen neem je bij de bouw?
Deze tabel vat de keuzes samen, met de check die je zelf kan doen:
| Pijler | Bouwkeuze | Zelf controleren |
|---|---|---|
| Rendering | SSR of statische generatie | ”View source” toont je kerntekst |
| Structuur | Vraagkoppen, antwoord eerst | Elke H2 opent met het antwoord |
| Markup | JSON-LD die klopt met de pagina | Schema Markup Validator: 0 fouten |
| Snelheid | Lichte pagina’s, snelle server | PageSpeed Insights-velddata |
| Toegang | Bewuste robots.txt per bot | Je /robots.txt in de browser |
Twijfel je over je huidige site? Begin met onze AI-ready website checklist of de gratis GEO-check.
De korte samenvatting
Bouwen voor AI-vindbaarheid draait om vier technische pijlers:
- server-side gerenderde HTML, zodat crawlers zonder JavaScript je content zien
- een heldere structuur met antwoord-eerst secties
- kloppende gestructureerde data in JSON-LD
- een snelle, crawlbare site
Die fundering combineer je met een doordachte GEO-aanpak en met conversiegerichte pagina’s.
Zo levert de zichtbaarheid ook echt leads op.
De techniek is geen doel, maar het verschil tussen wel of niet bestaan voor een AI-engine.
Wil je weten of AI-engines je huidige site kunnen lezen en citeren, en wat dat voor je aanvragen betekent? Neem contact op en we bekijken eerst je broncode met je.
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.