
SEO
Een AI-zichtbaarheidsaudit uitvoeren

Kopieer voor AI
Een AI-zichtbaarheidsaudit meet of AI-modellen je merk kunnen lezen, begrijpen en citeren.
Je rankt netjes in Google en je verkeer is stabiel. Toch verlies je deals aan partijen die je nauwelijks kent.
Steeds vaker begon de koper niet in Google, maar in ChatGPT of Perplexity. Daar ontstond een shortlist, en jij stond er niet op.
Het verdict: een ai zichtbaarheidsaudit is een eigen format met vier lagen: crawlbaarheid, entiteiten, citaties en schema. Ze eindigt met een nulmeting en een korte actielijst, gekoppeld aan pipeline.
De vraag is dus niet alleen “rank ik?”, maar “ziet AI mij?”.
Wil je eerst het fundament begrijpen? Lees dan wat SEO precies is en hoe het werkt.
Waarom is een aparte AI-zichtbaarheidsaudit nodig?
Omdat AI-zoekmachines je content anders gebruiken dan Google’s klassieke resultaten.
Een klassieke SEO-audit meet of Google je pagina’s kan vinden, indexeren en ranken. Dat blijft de basis.
Wat een AI-zoekmachine anders doet
Een AI-zoekmachine leest, vat samen, combineert bronnen en formuleert één antwoord. Daarin noemt ze vaak maar één of twee merken.
Je hoeft daarvoor niet op één te staan in de klassieke resultaten.
Maar je content moet wel leesbaar, begrijpelijk, geloofwaardig en machine-interpreteerbaar zijn.
Andere meetpunten dan posities en klikken
Daarom werkt deze audit met andere meetpunten. Vier vragen sturen het werk:
- Crawlbaarheid: raakt een model bij je content?
- Entiteiten: snapt het wie je bent en waar je autoriteit op hebt?
- Citaties: word je al genoemd in AI-antwoorden?
- Schema: geef je signalen die machines makkelijk verwerken?
Vier lagen, elk met een eigen check:
De signalen overlappen deels met SEO, maar zeker niet volledig.
Daarom is dit een eigen format, geen extra regel in je SEO-rapport.
Laag 1: kan een AI-bot bij je content? (crawlbaarheid)
Alles begint bij de vraag of een AI-systeem überhaupt bij je content kan.
Veel teams ontdekken pas tijdens een audit dat ze AI-crawlers onbedoeld blokkeren. Wat crawlbaarheid precies inhoudt, lees je in onze uitleg.
Stap 1: lees je robots.txt per user agent
Begin bij je robots.txt en kijk welke user agents je toelaat of weigert.
Zo ziet een open robots.txt eruit, hier die van onze eigen site:
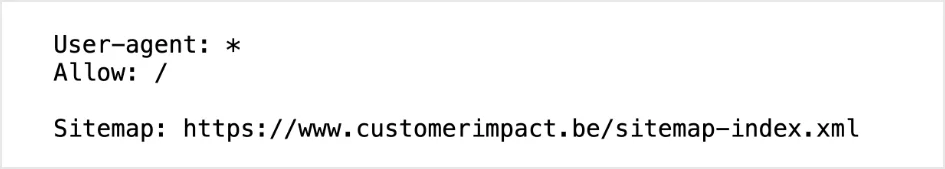 De robots.txt van customerimpact.be, oktober 2026: één regel die alle crawlers toelaat, plus de sitemap.
Eén regel, geen uitzonderingen.
Elke bot mag alles lezen, van Googlebot tot GPTBot.
Het addertje: trainingsbots en zoekbots zijn aparte user agents. Wie de ene blokkeert, blokkeert de andere niet.
Stap 2: check elke zoekbot apart
Elke AI-aanbieder gebruikt meerdere user agents, elk met een eigen taak. Dit zijn de bots die ertoe doen:
- OpenAI: GPTBot verzamelt trainingsdata, OAI-SearchBot bepaalt of je in ChatGPT search verschijnt. Alleen GPTBot blokkeren haalt je dus niet uit ChatGPT search.
- Anthropic: ClaudeBot dient voor modeltraining, Claude-SearchBot voor zoekkwaliteit en Claude-User voor live vragen van gebruikers.
- Perplexity: PerplexityBot indexeert voor de zoekresultaten, Perplexity-User haalt pagina’s op wanneer iemand een vraag stelt.
- Google: Google-Extended is geen crawler, maar een robots.txt-token voor Gemini-training en grounding.
Volgens Google heeft Google-Extended geen invloed op opname of ranking in Google Search. AI Overviews en AI Mode volgen je gewone Googlebot-regels.
Perplexity zegt in zijn eigen botdocumentatie dat PerplexityBot niet gebruikt wordt voor het trainen van AI-modellen. Perplexity-User negeert robots.txt doorgaans, omdat een gebruiker het verzoek startte.
Let op: OpenAI meldt dat een wijziging in robots.txt ongeveer 24 uur nodig heeft voor ze in de zoekresultaten doorwerkt.
Een blokkade op een zoekbot betekent dat je niet geciteerd kunt worden op dat platform. Hoe je die regels instelt, staat in AI-crawlers toelaten en optimaliseren.
Stap 3: test rendering, snelheid en structuur
Controleer daarna of je belangrijkste pagina’s server-side renderen.
Content die pas na zware JavaScript-uitvoering verschijnt, is voor veel ophaalsystemen onzichtbaar of onvolledig. Meer daarover in client-side rendering is onzichtbaar voor AI.
Kijk ook naar laadsnelheid, redirect-ketens en verweesde pagina’s. Denk aan een dienstenpagina die pas na 3 redirects laadt.
Stap 4: kruiscontrole met crawlstatistieken
Een handige kruiscontrole vind je in je crawlstatistieken in Search Console. Zo ziet dat rapport eruit:
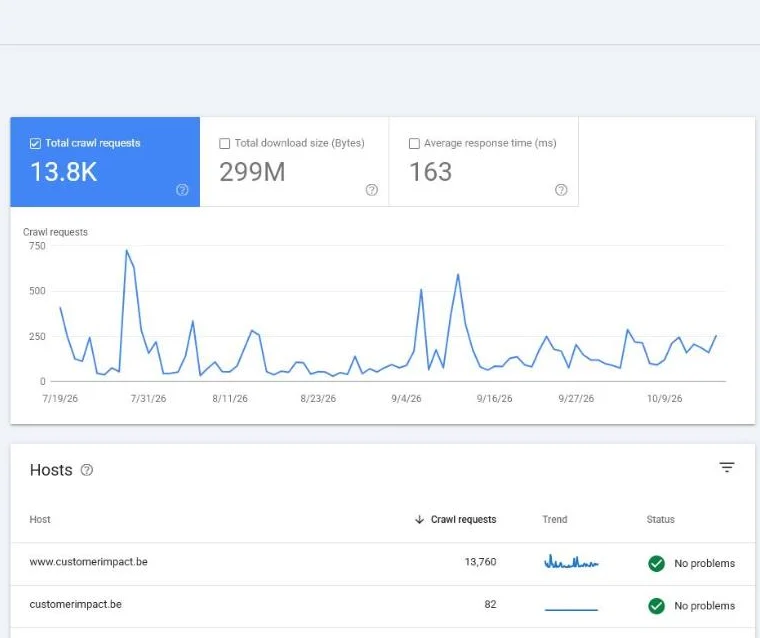 Crawlstatistieken in onze eigen Search Console voor customerimpact.be, oktober 2026.
Heeft zelfs Google moeite om alles op te halen? Dan hebben AI-bots het zeker lastig.
Onze ervaring: bij grotere bedrijven gaan we verder met logbestanden. Daar zien we dat het aantal AI-agents dat websites bezoekt elk jaar fors stijgt.
Hoe dat werkt, lees je in log file analyse voor SEO.
Resultaat van laag 1: een lijst pagina’s die technisch onbereikbaar of moeilijk leesbaar zijn voor machines.
Laag 2: snapt een AI wie je bent? (entiteiten)
Crawlbaar zijn is niet genoeg.
Een model moet ook begrijpen wie je bent, wat je doet en waarom het je zou vertrouwen.
Wat een entiteit is
Een entiteit is een herkenbaar “ding” met eigenschappen: jouw merk, je mensen, je diensten en je kernonderwerpen.
Modellen bouwen een soort kennisbeeld op uit alle bronnen waar je in voorkomt, niet enkel uit je eigen site. Onze uitleg over entiteit-SEO gaat daar dieper op in.
Drie vragen voor deze laag
In deze laag controleer je of je entiteit consistent en herkenbaar is:
- Beschrijf je je bedrijf overal op dezelfde manier?
- Staat duidelijk welke problemen je oplost, en voor wie?
- Heb je diepgang rond je kernthema’s, of blijft alles oppervlakkig?
Kijk ook naar externe signalen. Denk aan vermeldingen, profielen en verwijzingen op plekken die modellen vaak raadplegen, zoals branchegidsen en reviewsites.
Samenhang maakt een sterke entiteit
Een sterke entiteit ontstaat door samenhang tussen je site, je website-architectuur en de manier waarop anderen over je praten.
Stel: je homepage noemt je “digitaal bureau”, je LinkedIn “marketingconsultancy” en een branchegids “webdesigner”. Een model moet dan gokken wat je bent.
De gap die we hier vinden: het merk is actief, maar nergens scherp en consistent gedefinieerd. Een model gokt dan, of slaat je over.
Laag 3: word je vandaag al genoemd? (citaties)
Dit is de kern van de audit, en je echte nulmeting.
Stap 1: stel een vragenset op
Schrijf realistische vragen op die jouw ideale klant zou stellen. Denk aan “welk bureau helpt B2B-bedrijven met leadgeneratie in België?”
Hoe je die vragen vindt, lees je in prompt-onderzoek: welke vragen stellen klanten aan ChatGPT.
Stap 2: noteer per platform wie genoemd wordt
Doe dat per platform, want ChatGPT, Google AI en Perplexity gedragen zich verschillend en putten uit andere bronnen.
Zo ziet een antwoord eruit dat je in je audit vastlegt:
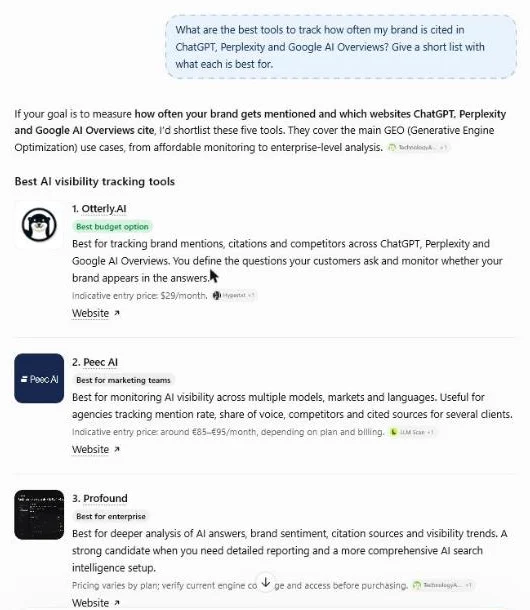 Onze eigen ChatGPT-test van 17 oktober 2026. Naam, volgorde en label gaan elk in een eigen kolom.
Noteer per vraag of je merk verschijnt, en op welke positie.
Noteer ook of je rechtstreeks geciteerd wordt of enkel als bron meegaat. Een spreadsheet met 4 kolommen volstaat: vraag, platform, positie en bron.
Stap 3: leg de bronnen vast
Perplexity toont zijn bronnen expliciet, wat het loggen makkelijker maakt:
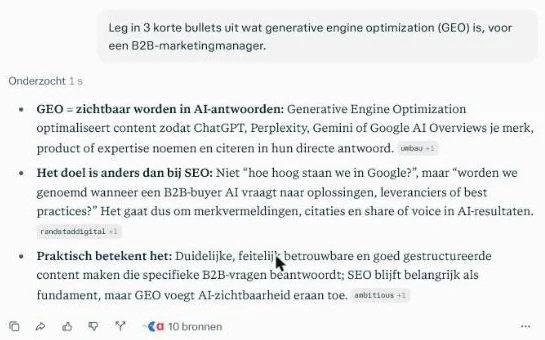 Perplexity met een gratis account, 17 oktober 2026: een bronlabel bij elke bullet en 10 bronnen in totaal.
Kijk net zo goed naar de concurrenten die wél genoemd worden.
Welke pagina’s van hen worden aangehaald? En wat hebben die dat jij mist?
Stap 4: lees de oorzaak af
Zo wordt zichtbaar waar het probleem ligt:
- Ontbrekende content: je hebt geen pagina die de vraag beantwoordt.
- Te weinig autoriteit: anderen praten niet over je.
- Moeilijk citeerbaar formaat: je antwoord zit verstopt in lange blokken.
Voor een diepere uitwerking van deze meting kan je terecht in de complete GEO-audit. Wil je eerst snel checken? Gebruik word ik genoemd in ChatGPT.
Resultaat van laag 3: een selectiegraad en een citatieaandeel per platform, in plaats van een gevoel.
Laag 4: geef je machineleesbare context? (schema)
De laatste laag maakt het een AI zo makkelijk mogelijk om je content correct te interpreteren.
Wat schema doet
Gestructureerde data via schema.org vertelt machines expliciet wat iets is: een organisatie, een product, een artikel, een auteur of een veelgestelde vraag.
Dat vermindert giswerk en vergroot de kans dat je content juist wordt samengevat en toegeschreven.
Google schrijft dat Organization-markup helpt om je organisatie te onderscheiden van gelijknamige bedrijven (Google over Organization-markup). Er zijn geen verplichte velden.
Wat je controleert
Check of je de basis op orde hebt:
- Organisatie en website: naam, logo, url en
sameAs-profielen. - Auteurs: wie schreef dit, en waarom is die persoon geloofwaardig?
- FAQ of product: waar het past bij de pagina.
Valideer je markup daarna. Op onze eigen site gaf de validator 0 fouten en 0 waarschuwingen:
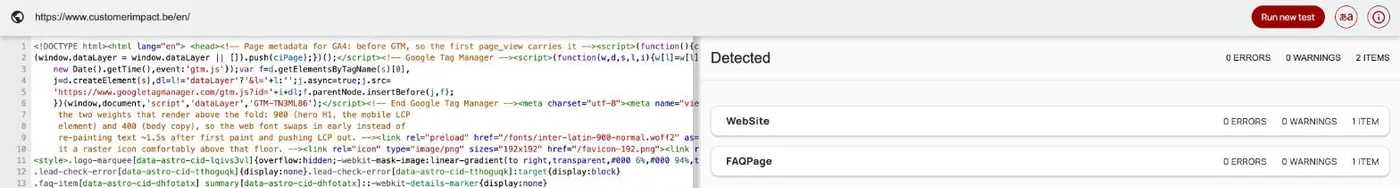 Schema Markup Validator op onze eigen pagina customerimpact.be/en/, oktober 2026: 0 fouten en 0 waarschuwingen.
Hoe je markup implementeert, lees je in schema markup implementeren voor B2B.
Titels en citeerbare alinea’s
Kijk ook of je titels en samenvattingen ondubbelzinnig zijn. Een goede title en meta helpt niet alleen Google, maar ook elk model dat je pagina in één zin samenvat.
Let op duidelijke koppen, korte alinea’s en feitelijke statements die los van hun context overeind blijven.
Tip: de gap in deze laag is meestal technisch en snel te dichten.
Dat maakt schema een ideaal startpunt.
Hoe maak je van de audit een geprioriteerde actielijst?
Prioriteer op impact en moeite, en koppel elke gap aan een commercieel doel.
De valkuil is alles tegelijk willen oplossen. Deze tabel helpt bij de volgorde:
| Laag | Typische gap | Moeite | Wanneer zichtbaar |
|---|---|---|---|
| Crawlbaarheid | zoekbot geblokkeerd in robots.txt | laag | na de volgende crawl |
| Schema | geen Organization-markup | laag | na herindexering |
| Entiteiten | inconsistente bedrijfsomschrijving | middel | maanden |
| Citaties | geen citeerbare content op koopvragen | hoog | maanden |
Een geblokkeerde crawler of ontbrekende basis-schema fix je snel.
Een sterke entiteit opbouwen vraagt maanden.
Koppel elke gap aan pipeline
Een vermelding op een vraag zonder koopintentie weegt minder dan zichtbaarheid op de vragen die je beste leads stellen.
Dat is het verschil tussen zichtbaarheid najagen en pipeline bouwen. Hoe je leads uit AI meet, lees je in GEO-attributie: leads uit AI.
Bij Customer Impact behandelen we SEO en AI-zichtbaarheid als één acquisitielaag van dezelfde groeimotor. We zorgen dat je gevonden én geciteerd wordt, altijd richting omzet.
Wil je sparren met een seo consultant die deze audit uitvoert?
Plan dan gerust een gesprek.
Veelgestelde vragen
Hoe lang duurt een AI-zichtbaarheidsaudit?
Een eerste nulmeting doe je in enkele uren: robots.txt, een schema-check en een vragenset per platform. Een volledige audit met entiteiten en concurrenten duurt langer, afhankelijk van het aantal vragen en markten.
Moet ik GPTBot blokkeren om mijn content te beschermen?
Dat is een keuze. GPTBot blokkeren stopt het gebruik voor training, maar haalt je niet uit ChatGPT search; daarvoor telt OAI-SearchBot. Blokkeer nooit een zoekbot als je geciteerd wil worden.
Hoe vaak herhaal ik de audit?
Herhaal de citatiemeting met dezelfde vragenset op een vast ritme, bijvoorbeeld elk kwartaal. Zo vergelijk je echte vooruitgang met je nulmeting in plaats van met een gevoel.
Is een AI-zichtbaarheidsaudit hetzelfde als een GEO-audit?
Ze overlappen sterk. Deze audit is de compacte versie in vier lagen; de complete GEO-audit gaat dieper in op citaties en concurrenten.
Begin met je nulmeting
Een AI-zichtbaarheidsaudit hoeft geen project van maanden te zijn.
Je begint met een foto van waar je vandaag staat, in vier lagen, en vertaalt die naar een korte actielijst. Leg vooral een baseline vast, zodat je later echte vooruitgang kan aantonen.
De snelste nulmeting is onze AI-zichtbaarheidsscan: 55 vragen die jouw klanten typen, gesteld aan Google en ChatGPT, met per vraag wie genoemd wordt.
Wil je de audit samen doen en meteen aan je pipeline koppelen? Neem contact op en we leggen je nulmeting samen vast.
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.