
SEO & GEO
Qu'est-ce qu'un large language model (LLM) ? Explication pour marketeurs

Copier pour l'IA
Un large language model (LLM) est une IA qui prédit le texte suivant.
Il est entraîné sur des quantités gigantesques de texte.
Il construit chaque réponse en devinant, fragment après fragment, ce qui vient logiquement ensuite.
C’est la technologie derrière 4 outils que vos clients utilisent déjà : ChatGPT, Google Gemini, Microsoft Copilot et Perplexity.
Le verdict : un LLM ne connaît pas les faits, il connaît le langage. Votre marque n’apparaît dans ses réponses que si elle est décrite clairement et de façon cohérente.
Qu’est-ce qu’un large language model exactement ?
C’est un programme qui traite et génère du langage humain, après avoir appris des motifs dans une immense collection de texte.
Les 3 mots du nom
Les 3 mots disent déjà presque tout :
- Large : le texte d’entraînement et le modèle lui-même sont gigantesques
- Language : il travaille avec des mots et des phrases, pas avec une base de données
- Model : un système mathématique qui applique des motifs appris à de nouvelles questions
Pas un moteur de recherche avec des réponses toutes prêtes
Un LLM ne contient pas une liste de faits qu’il consulte.
Pendant l’entraînement, il a appris comment le langage est structuré.
Il sait quels mots et quelles idées vont ensemble, et quelle phrase suit généralement quelle autre.
Sur cette base, il reconstruit chaque réponse sur le moment.
Comment un LLM arrive-t-il à une réponse ?
Il construit sa réponse morceau par morceau.
À chaque pas, il calcule quel fragment de texte suivant est le plus probable.
Voici la boucle en une image :
Étape 1 : votre question devient des tokens
Votre question est découpée en petits fragments appelés « tokens ».
Un token est le plus souvent un mot ou une partie de mot.
Votre phrase devient ainsi une suite de tokens que le modèle peut traiter.
Étape 2 : le modèle prédit le token suivant
Le modèle examine cette suite et calcule une probabilité pour le fragment suivant.
Compte tenu de tout ce qui précède, quel token vient le plus logiquement ?
Il en choisit un et l’accole à la phrase.
Puis il recommence.
Le cours d’apprentissage automatique de Google résume d’ailleurs les LLM comme « essentiellement des mécanismes de saisie automatique ».
Étape 3 : token après token, la réponse se forme
Mot après mot, la réponse entière apparaît.
Dans un chatbot, vous voyez donc le texte s’afficher progressivement : il est littéralement calculé à ce moment-là.
Des statistiques, pas du hasard
Pendant l’entraînement, le modèle a vu des milliards de fois des motifs.
Il en a déduit quels mots vont ensemble dans quel contexte.
Il ne calcule pas l’intention d’un humain. Il calcule des statistiques.
Comment un LLM est-il entraîné ?
On lui fait « lire » d’énormes quantités de texte et prédire encore et encore le mot suivant. Il se corrige ensuite sur la base de ses erreurs.
Deviner le mot manquant, des milliards de fois
Imaginez ce processus :
- Le modèle reçoit une phrase dont le dernier mot a été retiré.
- Il doit deviner ce qui devrait s’y trouver.
- Si c’est juste, l’approche est conservée.
- Si c’est faux, ses réglages internes sont légèrement ajustés.
Répétez cela un nombre inimaginable de fois, sur une montagne de texte.
Le modèle devient alors de plus en plus fort.
Du modèle de base à l’assistant
Ce modèle de base n’est pas encore un assistant. Il lui manque une étape.
Les chatbots passent ensuite par un entraînement supplémentaire, l’ajustement (fine-tuning). Il leur apprend à suivre des instructions et à mieux accomplir des tâches précises.
D’où vient le texte d’entraînement ?
En grande partie de l’internet public : articles, sites web, forums, ouvrages de référence et bien plus.
Deux conséquences en découlent :
- Une date limite : le modèle ne connaît pas de lui-même les événements postérieurs à son entraînement
- Les lacunes du web : il apprend aussi les trous et les partis pris de ce qui est en ligne
Ce qui est décrit de façon claire et cohérente, il l’apprend bien. Ce qui est à peine ou mal décrit, il le connaît mal.
Et c’est précisément là que vous, en tant que marque, avez de l’influence.
Qu’est-ce qu’un LLM fait bien, et qu’est-ce qu’il fait mal ?
Un LLM excelle dans le langage et reste faible sur la certitude factuelle. Cette distinction décide comment l’utiliser intelligemment.
Fort : tout ce qui touche à la forme
Il est puissant pour ce type de travail :
- résumer et réécrire
- traduire et adapter le ton
- générer des idées
- rendre de longs textes compréhensibles
Faible : les faits
Un modèle construit la réponse la plus probable, pas la réponse vraie.
Il peut donc inventer, avec pleine conviction, quelque chose de plausible mais faux. Ce phénomène s’appelle l’hallucination.
Selon Google Cloud, le manque d’ancrage dans des données fiables y contribue.
Le modèle produit alors des sorties plausibles mais incorrectes.
Il ne ment pas volontairement. Il suit simplement le motif de langage le plus probable, même quand celui-ci ne correspond pas à la réalité.
Mémoire seule ou sources en direct ?
De nombreux outils d’IA modernes atténuent ce risque.
Ils laissent le modèle consulter des sources actuelles pendant la rédaction, au lieu de s’appuyer uniquement sur sa mémoire.
La différence se voit tout de suite. Voici la réponse de ChatGPT gratuit à notre propre prompt GEO, sans recherche :
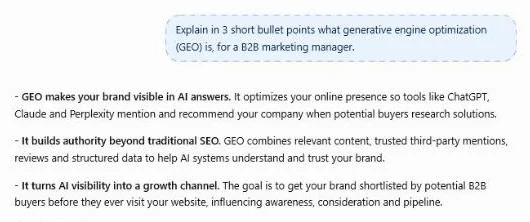 ChatGPT gratuit (chat temporaire), 17 octobre 2026 : trois puces, environ 90 mots, aucune source.
Le modèle a répondu en 3 puces et environ 90 mots, depuis sa seule mémoire, sans 1 seule source.
Le même prompt dans Perplexity, qui cherche sur le web avant de répondre, donne autre chose. Regardez le panneau des sources :
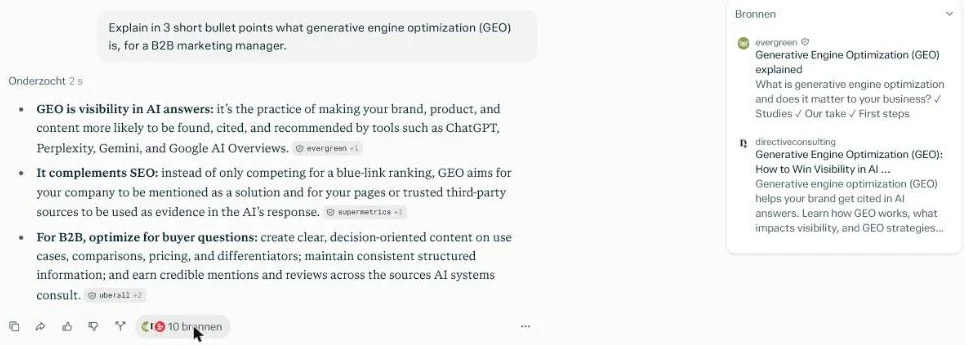 Le panneau des sources de Perplexity pour notre propre prompt de test, 17 octobre 2026 : 10 pages web derrière une seule réponse.
Ici, 10 pages web nourrissent la réponse.
C’est parmi ces pages que votre marque veut figurer.
Pourquoi un LLM est-il pertinent pour vous, marketeur ?
Parce que de plus en plus de gens posent leurs questions à une IA plutôt qu’à un moteur de recherche classique. Et cette IA décide quelles marques et quelles sources figurent dans sa réponse.
De la liste de liens à la réponse unique
Avant, vous vous battiez pour une place parmi 10 liens bleus.
Aujourd’hui, la question change. Votre entreprise est-elle seulement mentionnée dans la réponse que l’IA formule elle-même ?
Ce que cela change pour votre contenu
Tout ce qui précède se rejoint ici. Un LLM répond à partir de motifs vus dans du texte, et de plus en plus à partir de sources récupérées sur le moment.
Deux types de contenu en découlent :
- Clair, cohérent et structuré : facile à comprendre et à réutiliser pour un modèle
- Mince, vague ou contradictoire : ignoré
Optimiser votre visibilité dans ces réponses s’appelle le GEO. Tout est expliqué dans notre guide complet sur le generative engine optimization.
L’ajustement de votre contenu aux modèles de langage s’appelle aussi LLMO. Ce que recouvre exactement le LLMO (large language model optimization), vous le lisez séparément.
Ce que nous mesurons
Chez Customer Impact, nous ne regardons pas des chiffres de vanité, mais ce que cela rapporte.
La question clé : êtes-vous mentionné quand un client B2B potentiel pose une question d’achat à une IA ?
Ce n’est pas une affaire d’astuces. Un modèle cite volontiers un contenu fiable et trouvable.
Le résumé en bref
Un LLM prédit le texte suivant, token par token, à partir de motifs appris.
Il ne comprend rien comme un humain : il calcule des probabilités sur le langage.
Il est donc fort en rédaction et faible sur les faits durs.
Les moteurs de recherche IA reposent sur ces modèles. La clarté de votre contenu décide donc si votre marque apparaît dans leurs réponses.
Vous voulez savoir si votre entreprise apparaît aujourd’hui dans les réponses d’IA ? Découvrez comment nous travaillons sur la visibilité dans les moteurs de recherche IA.
Ou contactez-nous et nous regardons ensemble où votre marque apparaît déjà.
Scan gratuit de votre site
Indiquez votre site et recevez en quelques minutes une analyse automatique avec des points d'amélioration techniques et SEO concrets. Sans discours commercial.
Nous utilisons vos données uniquement pour votre scan. Pas de spam, désinscription à tout moment.