
SEO & GEO
Que sont les embeddings ? L'explication marketing des vecteurs de sens

Copier pour l'IA
Les embeddings transforment le sens d’un texte en une suite de chiffres.
C’est ainsi que ChatGPT ou Google « lisent » réellement votre contenu.
Et cela explique pourquoi une page est citée par l’IA alors qu’une autre ne l’est pas.
Le verdict : avec les embeddings, l’IA compare le sens, pas les mots. Couvrir votre sujet clairement rapporte plus que répéter un mot-clé.
Cela paraît technique.
Mais l’idée est étonnamment simple, et elle change votre regard sur votre contenu.
Voici ce que sont les embeddings et pourquoi ils comptent.
Pour vous, marketeur, ils décident de votre visibilité dans les moteurs IA.
Que sont exactement les embeddings ?
Un embedding est une manière de transformer le sens en chiffres.
Un modèle d’IA ne « comprend » pas comme un humain.
Il calcule.
Tout ce qu’il traite doit d’abord être traduit en quelque chose avec quoi il peut calculer : une longue suite de chiffres.
Le vecteur, cette suite de chiffres
Cette suite de chiffres, nous l’appelons un vecteur.
Le vecteur qui capture le sens d’un morceau de texte, c’est l’embedding.
OpenAI le décrit ainsi : un embedding est un vecteur de nombres.
La distance entre deux vecteurs mesure le lien entre deux textes (OpenAI, guide des embeddings).
Petite distance, textes proches. Grande distance, textes sans rapport.
Le sens, pas les mots
Le mot important ici est le sens.
Un embedding ne fixe pas quels mots figurent dans un texte, mais de quoi le texte parle à peu près.
Prenons un exemple.
Ces deux phrases n’ont presque aucun mot en commun :
- « une voiture abordable pour la ville »
- « une auto bon marché pour les trajets domicile-travail quotidiens »
Elles signifient pourtant quelque chose de très proche.
Dans le monde des embeddings, elles se retrouvent donc voisines.
L’idée en une phrase : des textes au sens semblable reçoivent des vecteurs semblables.
Des textes qui parlent de choses complètement différentes se retrouvent éloignés.
Le modèle n’a pas besoin de dictionnaire pour savoir que « voiture » et « auto » désignent la même chose.
Leurs vecteurs sont proches. Cela suffit.
D’où vient l’idée ?
L’idée n’est pas nouvelle.
En 2013, Tomas Mikolov et ses collègues ont publié word2vec. Cette méthode apprend des vecteurs de mots sur de très grands corpus.
Leur modèle a appris sur environ 1,6 milliard de mots en moins d’une journée.
Les résultats sur la similarité de sens étaient bons (Mikolov et al., 2013).
Les modèles actuels font pareil.
Mais pour des phrases et des pages entières.
Imaginez une carte du sens
Une manière utile de se représenter les embeddings : une gigantesque carte où chaque notion reçoit une place.
Sur une telle carte, les choses apparentées se retrouvent voisines.
Voici un exemple simplifié, en deux dimensions :
« Génération de leads », « prise de rendez-vous » et « entretiens commerciaux » forment ensemble un quartier.
« Vacances », « plages » et « billets d’avion » se situent tout ailleurs.
Des centaines de dimensions, pas deux
La différence avec une vraie carte : celle-ci n’a pas deux directions (nord-sud, est-ouest), mais des centaines, voire des milliers.
Le modèle text-embedding-3-small d’OpenAI produit par exemple des vecteurs de 1 536 dimensions par défaut, et text-embedding-3-large de 3 072 (OpenAI).
Chacune de ces directions capte un autre fragment de sens. Vous ne pouvez pas vous la représenter visuellement, et ce n’est pas nécessaire.
Ce qui compte : la distance sur cette carte équivaut à la différence de sens. Proche veut dire apparenté, loin veut dire sans rapport.
Comment une question trouve sa réponse
Lorsque quelqu’un pose une question à une IA, cette question devient elle aussi un point sur la carte.
Le modèle regarde ensuite quels morceaux de contenu se situent le plus près de ce point. Ce sont probablement les plus pertinents pour répondre.
Voilà comment l’IA fait correspondre une question à du contenu. Pas en cherchant vos mots à la lettre, mais en regardant quel sens s’en rapproche le plus.
Ces vecteurs sont stockés et comparés dans une base de données vectorielle. Le principe général s’appelle la recherche sémantique.
Pourquoi cela change toute la logique de la visibilité
Parce que vous n’optimisez plus pour un mot, mais pour un sujet.
Le réflexe classique en SEO a longtemps été : choisir un mot-clé et le répéter.
Si quelqu’un cherchait « voiture de société abordable », ce terme exact devait figurer le plus souvent possible sur votre page. Les moteurs de recherche faisaient en effet largement correspondre les mots.
Répéter un mot-clé ne rapporte plus
Les embeddings renversent cette logique. Comme l’IA compare le sens et non les mots exacts, vous ne gagnez plus rien à répéter dix fois un terme.
Pire encore : une page qui répète de force le même mot-clé apparaît, dans l’espace du sens, étroite et unilatérale.
Une page qui creuse vraiment le sujet varie naturellement ses mots. Son vecteur est plus riche et mieux placé.
La densité de mots-clés perd donc son sens comme objectif.
Une autre question à se poser
L’ancienne question était : « combien de fois mon mot-clé apparaît-il ? ».
La nouvelle question est : « est-ce que je traite ce sujet assez complètement pour être proche de chaque façon de poser la question ? ».
C’est une autre façon d’écrire. Elle explique pourquoi un contenu approfondi et bien structuré l’emporte sur des pages maigres pleines de répétitions.
Google le confirme pour ses fonctions IA
Google décrit pour AI Overviews et AI Mode une technique de « query fan-out » : plusieurs recherches liées sont lancées sur des sous-sujets pour construire une réponse (Google Search Central, fonctionnalités d’IA).
Google précise aussi qu’aucune optimisation spéciale n’est requise. Les bonnes pratiques SEO restent valables.
Une page qui couvre les sous-sujets d’un thème a donc plus de chances d’être retenue. Notre article sur le query fan-out dans AI Mode détaille le mécanisme.
Chez Customer Impact, nous insistons donc sur la couverture du sujet. Pas sur la densité de mots-clés.
Le cadre plus large se trouve dans notre guide complet sur la generative engine optimization.
Ce que les embeddings signifient pour votre contenu
Quatre conséquences pratiques, si l’IA évalue votre contenu sur le sens.
1. Écrivez autour du sujet complet, pas autour d’un seul terme
Traitez les variantes, les questions connexes et le contexte qu’un lecteur attend logiquement.
Plus votre thème est couvert, plus les questions s’approchent de votre contenu. Il est alors choisi plus souvent.
Par exemple, une page sur le coût d’un site web gagne à couvrir aussi la maintenance, l’hébergement et les délais. Ce sont les questions voisines qu’un acheteur se pose.
Cette couverture construit votre autorité thématique.
2. Utilisez un langage naturel
Les synonymes, les notions apparentées et les mots que vos clients emploient réellement renforcent votre position dans l’espace du sens.
Vous n’avez pas à craindre de « rater » un mot-clé si vous le formulez autrement. Le modèle reconnaît le sens.
3. Soyez explicite et concret
Un texte vague reçoit un vecteur vague. Il n’est proche de rien.
Une explication spécifique et claire obtient une position nette. Elle se rapproche plus facilement d’une question précise.
C’est l’une des raisons pour lesquelles un contenu clair performe mieux dans les réponses IA. Notre article sur le copywriting pour LLM en donne les règles d’écriture.
4. Structurez par question
Les moteurs de réponse aiment les morceaux délimités. Un morceau, une question.
Un titre clair suivi d’une réponse complète forme, dans l’espace du sens, un bloc net et facile à sélectionner.
Découper ainsi votre page s’appelle le content chunking.
Ce que cela veut dire au fond
Un bon contenu pour l’IA est en fait tout simplement un bon contenu pour les humains.
Les embeddings récompensent la clarté, la complétude et l’honnêteté sur votre sujet.
Les astuces ne marchent plus. Le modèle lit le sens.
Comment les embeddings s’intègrent dans le tableau plus large de la recherche IA
Les embeddings sont un rouage dans un ensemble plus vaste.
Ils déterminent comment le contenu et les questions se rapprochent sur le sens. Mais votre présence dans une réponse IA dépend d’autres facteurs :
- Recherche en direct : le modèle va-t-il chercher des sources sur le web ?
- Autorité : comment pèse-t-il la fiabilité d’une source ?
- Citabilité : votre texte est-il facile à reprendre ?
Le mécanisme qui combine recherche de passages et génération s’appelle le RAG. Le rôle du modèle de langage lui-même est expliqué dans notre article sur les LLM.
À quoi cela ressemble dans une réponse IA
Le résultat est visible dans les outils. Perplexity, par exemple, affiche les pages web qu’il a retenues pour construire sa réponse :
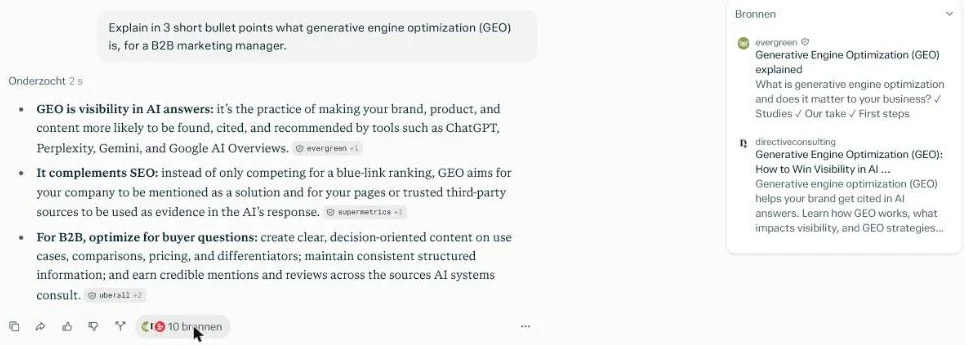 Notre propre test dans Perplexity, octobre 2026 : 10 sources derrière une seule réponse.
Ces sources sont les passages les plus proches de la question. Le reste du web n’apparaît pas.
Où se joue la visibilité de votre marque
Ces mécanismes, nous les traitons séparément, pour que cet article reste sur les vecteurs de sens eux-mêmes.
Être visible dans ChatGPT, les Google AI Overviews et Perplexity ? C’est le travail de notre service GEO pour les moteurs de recherche IA.
Nous y traduisons les embeddings en méthode. Le but : plus de mentions IA, puis des leads.
Pour un premier aperçu, testez votre page avec notre vérificateur GEO gratuit.
Questions fréquentes sur les embeddings
Les embeddings remplacent-ils les mots-clés ?
Non, ils en changent le rôle. Le mot-clé reste utile pour savoir ce que les gens cherchent. Mais la page n’a plus besoin de le répéter : elle doit couvrir le sujet et ses questions voisines.
Quelle est la différence entre un embedding et un token ?
Un token est un morceau de texte que le modèle découpe, souvent une partie de mot. L’embedding est le vecteur de chiffres qui représente le sens d’un token, d’une phrase ou d’un passage entier.
Faut-il un outil spécial pour optimiser ses embeddings ?
Non. Vous n’avez pas accès aux vecteurs des moteurs IA. Vous contrôlez la clarté, la structure et la complétude de votre contenu. C’est ce qui donne un bon vecteur.
Le résumé court
Les embeddings sont la manière dont l’IA transforme le sens en chiffres. Elle compare ainsi des textes sur ce qu’ils signifient, plutôt que sur les mots qu’ils contiennent.
Imaginez une carte où les notions apparentées se retrouvent proches. Une question devient un point sur cette carte, et le modèle choisit le contenu le plus proche.
La leçon : arrêtez d’optimiser pour des mots-clés isolés. Traitez votre sujet de façon complète, claire et honnête.
C’est ce que l’IA récompense, parce que c’est ce qui produit un bon vecteur de sens.
Où se positionne votre contenu dans l’espace du sens ? Contactez-nous : nous regardons ensemble où vous laissez filer de la visibilité IA.
Scan gratuit de votre site
Indiquez votre site et recevez en quelques minutes une analyse automatique avec des points d'amélioration techniques et SEO concrets. Sans discours commercial.
Nous utilisons vos données uniquement pour votre scan. Pas de spam, désinscription à tout moment.