
SEO & GEO
Qu'est-ce que le RAG (retrieval-augmented generation) ? Explication pour marketeurs

Copier pour l'IA
Le RAG fait récupérer du contenu externe à une IA avant qu’elle ne réponde.
RAG signifie retrieval-augmented generation.
L’IA récupère d’abord du contenu pertinent dans une source externe, puis formule sa réponse à partir de ce contenu.
Notre verdict : l’étape de récupération décide si votre page sert de source dans une réponse d’IA. Si vous n’y êtes pas sélectionné, vous n’existez pas pour la réponse.
Voici ce qu’est le RAG, et ce qu’il change pour votre contenu.
Qu’est-ce que le RAG exactement ?
Le RAG est une approche où un modèle de langage ne puise pas seulement dans sa propre mémoire.
Pendant qu’il répond, il récupère d’abord du contenu externe.
Il l’intègre ensuite dans sa réponse.
Le mot le dit lui-même :
- retrieval : la récupération
- generation : la génération
- augmented : la récupération vient « augmenter », autrement dit renforcer, la génération
Notre définition du RAG le résume en une ligne.
Un modèle sans RAG
Un modèle de langage (LLM) ordinaire sans RAG répond uniquement à partir de ce qu’il a appris pendant son entraînement.
Cette mémoire est un instantané. Elle a trois limites :
- elle prend du retard
- elle ne contient aucune information interne ou récente
- le modèle ne peut pas indiquer d’où provient telle ou telle chose
Ce que le RAG ajoute
Le RAG résout cela.
Il ajoute une étape intermédiaire.
Avant de répondre, le modèle cherche, dans un ensemble de documents, les passages les plus pertinents pour la question. Il construit sa réponse sur ces passages récupérés.
AWS décrit le RAG comme un moyen d’optimiser la réponse d’un LLM avec une base de connaissances fiable, externe à ses données d’entraînement.
Pourquoi pas simplement réentraîner le modèle ?
Réentraîner un modèle à chaque nouvelle information coûte cher et prend du temps.
Selon AWS, le RAG est une approche plus rentable pour introduire de nouvelles données dans un LLM. Il permet aussi de présenter l’information avec l’attribution de la source.
Pour vous : une page publiée aujourd’hui peut être récupérée demain, sans attendre le prochain entraînement.
D’où vient l’idée ?
L’idée vient d’un article de recherche de Patrick Lewis et ses collègues de Facebook AI Research, publié en mai 2020.
Les chercheurs y ont montré qu’un modèle qui récupère des connaissances externes répond de façon plus factuelle.
Et plus précise. Dans leur cas, ces connaissances venaient de Wikipédia.
Le modèle de comparaison s’appuyait uniquement sur ses propres paramètres.
Depuis, le RAG est la norme pour donner aux IA une information actuelle.
Comment fonctionne le processus de récupération et de génération ?
Dans le RAG, une réponse se déroule toujours en deux phases : d’abord récupérer, ensuite générer.
Cet ordre est important.
L’étape de récupération détermine dans quoi le modèle est autorisé à puiser.
Voici le processus, simplifié :
Étape 1 : la question arrive
Quelqu’un pose une question à l’IA.
Par exemple : « quel CRM B2B convient à une petite équipe commerciale ».
Étape 2 : le système récupère du contenu pertinent
Il cherche dans une source les passages les plus proches de la question. Cette source peut être :
- un index de pages web
- une base de connaissances interne
- un ensemble de documents
Cela se fait en grande partie sur le sens, pas sur les mots exacts.
Comment fonctionne cette correspondance sur le sens, vous le lisez dans notre explication sur les embeddings pour marketeurs.
En pratique : les textes sont convertis en vecteurs et stockés dans une base de données vectorielle. La question devient elle aussi un vecteur, comparé aux passages stockés.
Étape 3 : les passages récupérés sont transmis comme contexte
Le modèle reçoit les morceaux de texte trouvés en arrière-plan de la question d’origine.
AWS parle d’« augmenter » l’instruction de l’utilisateur avec les données récupérées pertinentes.
Étape 4 : le modèle génère la réponse
Il formule une réponse qui s’appuie sur ces passages récupérés.
Souvent avec un renvoi vers la source.
L’essentiel pour vous
Le modèle ne peut utiliser que ce qui a été récupéré à l’étape 2.
Si votre page n’y est pas sélectionnée, elle n’existe pas pour la réponse. Aussi bon que soit votre texte.
Conclusion : la bataille pour la visibilité se joue en grande partie dans l’étape de récupération.
Pourquoi les moteurs de recherche IA utilisent-ils le RAG ?
Le RAG s’attaque à deux grandes faiblesses des modèles de langage seuls :
- les connaissances périmées
- les faits inventés
Il réduit ces problèmes sans les supprimer.
Un modèle peut encore mal lire une source récupérée, comme l’explique notre article sur les hallucinations de l’IA.
En récupérant des sources en direct ou récentes, la réponse peut être actuelle. Et renvoyer vers une source reconnaissable.
Pourquoi les réponses affichent des sources
C’est précisément pour cela que les réponses d’IA affichent aujourd’hui si souvent des liens vers des sources.
Un système qui construit sa réponse sur du contenu récupéré peut aussi montrer d’où vient cette réponse. Perplexity le fait de façon très visible :
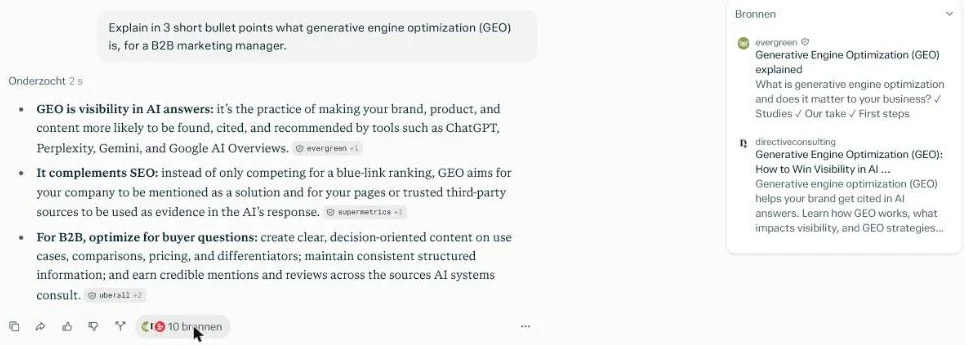 Le panneau des sources de Perplexity pour notre propre prompt de test, 17 octobre 2026 : 10 pages web derrière une seule réponse.
Ces 10 pages sont le résultat de l’étape de récupération.
La réponse ne peut citer que celles-là.
Toutes les sources récupérées ne sont pas citées
Récupérer ne veut pas dire citer.
La documentation de xAI pour Grok le dit noir sur blanc :
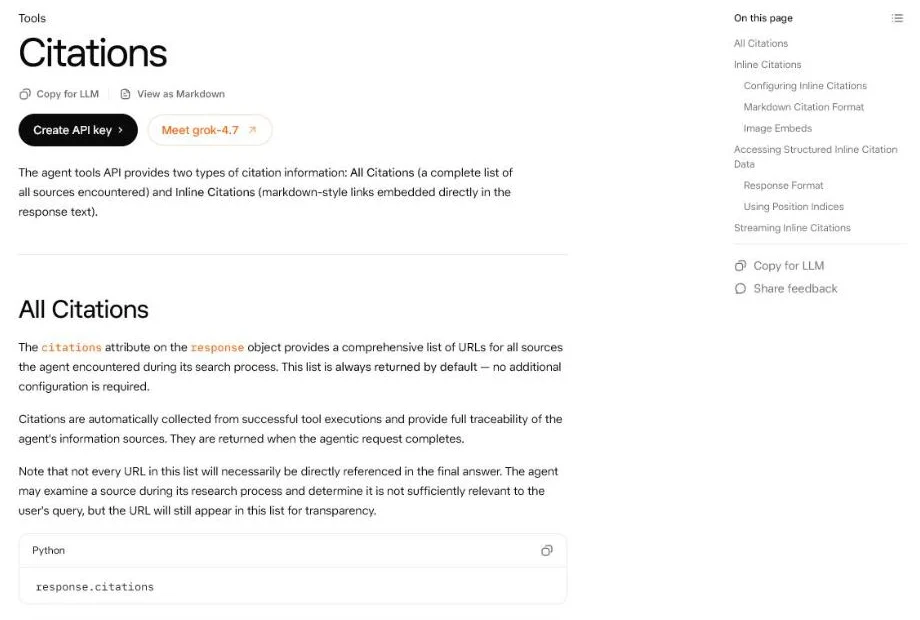 La documentation développeur de xAI sur les citations, octobre 2026. L’agent peut examiner une source puis l’écarter.
Être récupéré est donc nécessaire, mais pas suffisant.
Une nouvelle forme de visibilité
Pour l’utilisateur, les sources rassurent.
Il peut vérifier.
Pour vous en tant que marque, elles signifient une nouvelle forme de visibilité. Non pas un lien bleu en troisième position, mais une mention au cœur même de la réponse.
Le lien avec le grounding
La récupération de sources est étroitement liée au grounding.
C’est le processus par lequel l’IA ancre ses affirmations dans une information vérifiable.
Nous traitons cela à part dans grounding : comment l’IA détermine ce qui est vrai.
Retenez : le RAG est le moteur sous ce grounding.
Qu’est-ce que le RAG signifie pour votre contenu ?
Une réponse d’IA se construit sur des morceaux de texte récupérés.
Votre contenu doit donc être facile à trouver et facile à utiliser dans ce processus.
Quatre choix en découlent.
1. Assurez-vous que votre contenu puisse être récupéré
Votre page doit être accessible et indexable pour les systèmes qui récupèrent du contenu.
Derrière un login, techniquement peu accessible ou indexée nulle part ? Elle n’arrivera jamais dans l’étape de récupération.
Google le dit clairement pour ses AI Overviews et l’AI Mode : une page doit être indexée et éligible à un extrait dans la recherche, sans balisage spécial ni fichier propre à l’IA.
Vérifiez aussi que vous n’avez pas bloqué les robots par erreur.
Notre guide pour autoriser les crawlers IA détaille le fichier robots.txt.
Notre expérience : dans nos analyses de logs, les visites d’agents IA augmentent nettement chaque année.
2. Écrivez en morceaux délimités et autonomes
Le RAG ne récupère pas un site entier.
Il récupère des passages.
Un titre suivi d’une réponse complète à une seule question est une unité propre et récupérable.
Un long pavé où la réponse est cachée l’est beaucoup moins.
Comment structurer vos pages pour cela, vous le lisez dans l’architecture de contenu pour l’extraction par l’IA. Le content chunking va plus loin sur la taille des morceaux.
3. Rendez chaque réponse factuelle et autonome
Le modèle utilise votre passage comme source de faits.
Vous gagnez donc avec des affirmations claires, concrètes et exactes.
Un langage marketing vague ou exagéré n’ajoute rien à une réponse.
Il est rarement repris.
Par exemple, « notre outil s’intègre à Salesforce et HubSpot » est récupérable. « Notre solution révolutionnaire transforme votre business » ne l’est pas.
4. Traitez votre sujet de façon complète
Répondez à un maximum de questions pertinentes autour d’un thème.
Votre contenu sera plus souvent « assez proche » de ce que quelqu’un demande.
C’est la même logique qui guide l’approche plus large de la generative engine optimization.
Les systèmes IA découpent d’ailleurs une question en sous-questions.
Notre article sur le query fan-out montre comment.
Du travail bien fait, pas des astuces
Optimiser pour le RAG ne tient pas à des astuces.
C’est du travail bien fait : un contenu trouvable, clairement structuré et exact.
Cela rejoint la manière dont, chez Customer Impact, nous voyons la visibilité IA. Nous visons une visibilité qui mène à des leads et du chiffre d’affaires, pas des mentions creuses.
Soyons clairs sur la limite : personne ne peut garantir une citation dans une réponse d’IA. Le processus de récupération reste en partie une boîte noire.
Vous pouvez en revanche augmenter cette chance.
Notre checklist de contenu citable par l’IA vous donne les points à vérifier.
Ce que le RAG ne résout pas pour vous
Le RAG détermine si votre contenu peut être récupéré et utilisé.
Ce n’est pas une garantie que cela se produise.
Que votre passage soit effectivement choisi dépend de plus de facteurs :
- la qualité de la correspondance sur le sens
- l’autorité de votre marque autour du sujet
- votre position face aux sources concurrentes qui disent la même chose
Notre article sur la sélection des sources par l’IA détaille ces facteurs.
Un mécanisme, pas un bouton
Ce n’est donc pas un bouton que vous actionnez.
C’est un mécanisme sur lequel vous alignez votre contenu.
Le gain réside dans la production constante d’un contenu facile à récupérer, facile à comprendre et qui vaut la peine d’être cité.
Faites cela sur l’ensemble de votre thème.
Vous cumulez alors de petits avantages jusqu’à une position structurellement meilleure dans les réponses d’IA.
Testez où vous en êtes : notre test de visibilité IA montre si les modèles vous citent déjà.
Vous voulez savoir comment votre marque devient concrètement visible dans ChatGPT, Google AI Overviews et Perplexity ? C’est le travail de notre service GEO pour les moteurs de recherche IA.
Nous y traduisons le RAG en plus de mentions IA.
Mesurées en leads.
Le résumé en bref
Le RAG, retrieval-augmented generation, fait récupérer du contenu externe à une IA avant qu’elle ne réponde.
Il réduit deux faiblesses des modèles de langage seuls : les connaissances périmées et les faits inventés. Et il explique pourquoi les réponses d’IA affichent des sources.
Pour vous en tant que marketeur, la leçon tient en trois points :
- votre contenu doit être trouvable pour l’étape de récupération
- il doit être composé de morceaux délimités et factuels
- il doit couvrir votre sujet de façon complète
C’est ce qui augmente la chance que votre page se retrouve comme source dans une réponse d’IA.
Où laissez-vous de la visibilité IA de côté ?
Contactez-nous et nous regardons ensemble où se trouvent vos opportunités.
Scan gratuit de votre site
Indiquez votre site et recevez en quelques minutes une analyse automatique avec des points d'amélioration techniques et SEO concrets. Sans discours commercial.
Nous utilisons vos données uniquement pour votre scan. Pas de spam, désinscription à tout moment.