
SEO
Orphan pages opsporen: waardevolle pagina's die niemand intern linkt
 Tanguy De Keyzer Oprichter & digitale strateeg · Bijgewerkt 12 november 2026 · ◷ 11 min leestijd
Kopieer voor AI
Een orphan page, of weespagina, is een pagina zonder enkele interne link.
Voor orphan pages en SEO is dat een probleem. Crawlers volgen het web via links, dus ze vinden zo’n pagina nauwelijks.
Ze krijgt vrijwel geen interne autoriteit en blijft onzichtbaar in de zoekresultaten.
Het verdict: orphan pages opsporen doe je niet met een gewone crawl.
Je legt je crawl naast je sitemap, je analytics en je serverlogs, en beslist daarna per pagina.
Het vervelende is dat vaak net je waardevolle pagina’s verweesd raken.
Denk aan een oude dienstpagina, een goed artikel of een productpagina.
Vaak vielen ze bij een redesign uit het menu.
Wat is een orphan page precies?
Een pagina die bestaat, maar waar geen enkele interne link naartoe loopt.
Zoekmachines ontdekken pagina’s grotendeels door links te volgen.
Vanaf je homepage hopt een crawler naar je menu, naar categoriepagina’s, naar artikels en dienstpagina’s.
Elke pagina die in dat netwerk hangt, wordt gevonden. Een orphan page zit buiten dat netwerk, dus de crawler heeft geen pad om er te komen.
Google is daar duidelijk over: “elke pagina die je belangrijk vindt, zou een link moeten hebben vanaf minstens één andere pagina op je site”.
Wees of gewoon slecht gelinkt?
Dat is iets anders dan een pagina die slecht gelinkt is.
Een pagina met één enkele link diep in je site is zwak gepositioneerd, maar nog steeds bereikbaar. Een echte weespagina heeft nul interne links.
Ze bestaat wel en je kan ze via de directe URL openen. Maar binnen je interne linkstructuur is ze er niet.
| Echte orphan page | Slecht gelinkte pagina | |
|---|---|---|
| Interne links | 0 | 1 of enkele, diep in de site |
| Vindbaar via crawl | Nee | Ja, traag |
| Fix | Eerst opsporen, dan linken | Meer en betere links |
Hoe ontstaan weespagina’s?
De meest voorkomende oorzaken:
- een websitemigratie waarbij links niet meegenomen werden
- pagina’s die uit een menu of filter verdwenen
- geïmporteerde content die nooit ingelinkt werd
- losse landingspagina’s voor campagnes buiten de hoofdstructuur
Hoe groter en ouder je site, hoe meer wezen er stilletjes ontstaan.
Ook programmatic SEO, waarbij je pagina’s op schaal genereert, produceert snel weespagina’s als je de interne links niet meteen mee inbouwt.
Vuistregel: plan bij elke nieuwe pagina meteen twee of drie links vanuit bestaande content.
Dan ontstaat er geen wees.
Waarom vindt een gewone crawl ze niet?
Omdat een crawl links volgt, en net die links ontbreken.
Tools zoals Screaming Frog crawlen je site net zoals Google. Ze starten op de homepage en volgen links.
Maar precies omdat een orphan page geen interne links heeft, kan zo’n crawl ze per definitie niet bereiken.
De pagina die je wil vinden, is onzichtbaar voor de methode die je gebruikt.
Je hebt de crawler wel nodig als vertrekpunt. Zo ziet de SEO Spider eruit:
 De productpagina van Screaming Frog SEO Spider, oktober 2026. De crawler draait op Windows, macOS en Linux.
Vergelijk de crawl met andere bronnen
De oplossing: leg de crawl naast bronnen die pagina’s kennen via een ander kanaal dan interne links.
Een orphan page komt namelijk vaak nog voor op drie plekken:
- in je XML-sitemap
- in je analytics, als ze bezoek krijgt
- in je serverlogs, als een bot of bezoeker ze ooit opent
Door die lijsten naast je crawl te leggen, vallen de pagina’s op die wél bestaan maar in de crawl ontbreken:
Hoe vind je weespagina’s via sitemap-data?
Door de URL’s uit je sitemap te zoeken die niet in je crawl opduiken.
De snelste eerste stap is je XML-sitemap. Je sitemap is in principe je eigen complete inventaris van pagina’s die je geïndexeerd wil zien.
Zo pak je het aan
Veel SEO-crawlers laten je toe om naast de gewone crawl ook de sitemap-URL’s mee te laden.
Screaming Frog zegt het letterlijk: de tool crawlt een XML-sitemap apart of als deel van een crawl, om ontbrekende en verweesde pagina’s te vinden. De gratis versie stopt bij 500 URL’s.
De werkwijze:
- Laad je sitemap-URL in de crawler, naast de gewone crawl.
- Laat de tool je site crawlen én je sitemap lezen.
- Zet beide lijsten tegenover elkaar.
- Filter op URL’s die in de sitemap staan maar niet in de crawl.
Dat zijn pagina’s die je belangrijk genoeg vond voor de sitemap, maar waar nergens in je site naartoe gelinkt wordt.
Het is je eerste, meest betrouwbare lijst van verdachte weespagina’s.
Wat een sitemap precies is, lees je ook kort in de wiki onder sitemap.
Hoe vind je weespagina’s via analytics en Search Console?
Door de URL’s met bezoek of vertoningen te vergelijken met je crawl.
Je analytics-pakket en Google Search Console kennen pagina’s die ooit bezocht of weergegeven werden, los van je interne links.
Exporteer de lijst van URL’s die in de afgelopen maanden bezoek of vertoningen kregen, bijvoorbeeld de laatste 3 tot 6 maanden. Vergelijk die dan met je crawl.
De presterende wees
Een pagina die verkeer of impressies binnenhaalt maar niet in je crawl zit, is dubbel interessant. Ze presteert al, ondanks dat ze verweesd is.
Dat is vaak een pagina die je makkelijk verder kan laten groeien. Een paar interne links volstaan.
Hoe je dat paginarapport leest, staat in onze uitleg over het indexeringsrapport in Search Console.
Check de interne links per pagina
Search Console heeft ook een Links-rapport. Daarin zie je per pagina hoeveel interne links ernaartoe lopen:
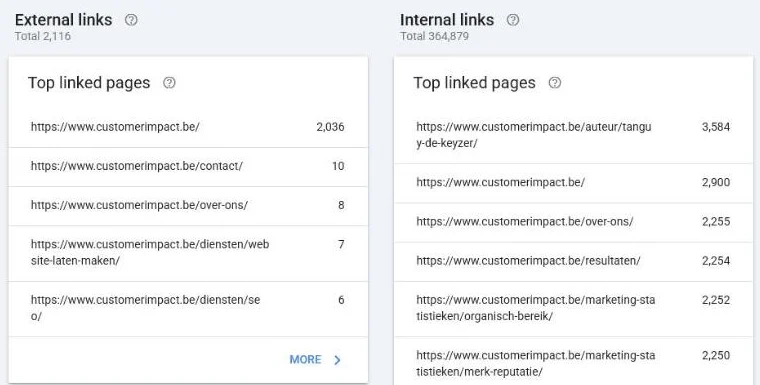 Het Links-rapport in onze eigen Search Console voor customerimpact.be, oktober 2026: 364.879 interne links. Het is een steekproef, niet elke link die Google kent.
Een pagina die daar ontbreekt of maar één interne link toont, verdient een tweede blik. Meer over dat rapport in onze uitleg over Google Search Console.
Waar analytics tekortschiet
Let bij deze bron op één detail. Analytics kent enkel pagina’s die de afgelopen periode bezoek kregen.
Een waardevolle pagina die al langer geen verkeer trekt, juist omdat ze verweesd is, blijft zo onder de radar.
Daarom combineer je analytics altijd met je sitemap en logs. Pas met de drie bronnen samen krijg je een volledig beeld van wat buiten je structuur leeft.
Hoe je überhaupt zorgt dat pagina’s in de index belanden, lees je in ons artikel over je website laten indexeren.
Hoe vind je weespagina’s via logfile-analyse?
Door alle URL’s uit je serverlogs te vergelijken met je crawl.
De grondigste bron zijn je serverlogs. Een logfile registreert elk verzoek aan je server:
- welke URL werd opgevraagd
- door welke bot of bezoeker
- wanneer
Daarmee zie je de ruwe werkelijkheid van hoe Googlebot je site crawlt. Niet hoe je denkt dat hij dat doet.
Twee checks in je logs
Voor het opsporen van orphan pages doe je twee dingen.
Eerst haal je alle unieke opgevraagde URL’s uit de logs en vergelijk je die met je crawl.
Pagina’s die in de logs zitten maar niet in de crawl, zijn kandidaat-wezen.
Daarna zie je welke pagina’s Googlebot zelden of nooit bezoekt. Dat hangt samen met hoe je crawlbudget verdeeld wordt.
Verweesde pagina’s krijgen doorgaans weinig botbezoek, omdat er geen links zijn die de bot ernaartoe sturen.
Een eerste indruk krijg je zonder logs, in de Crawlstatistieken van Search Console:
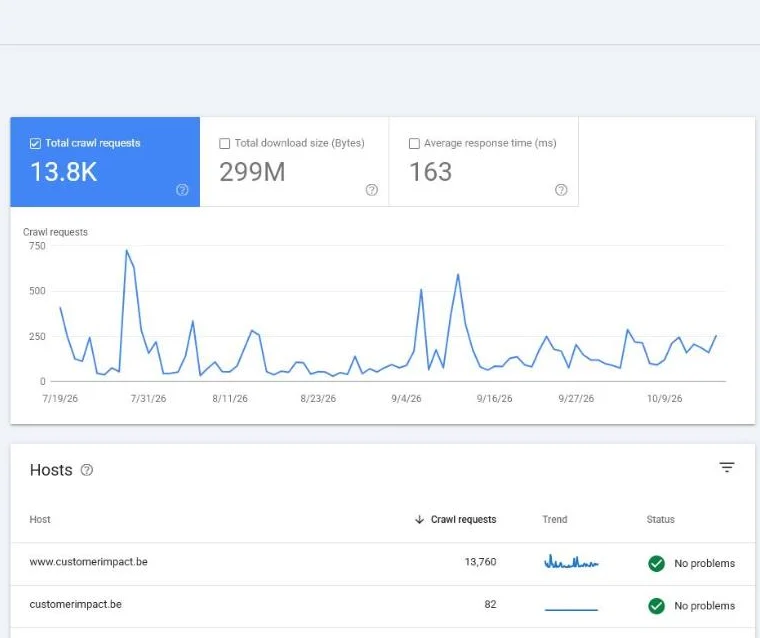 Crawlstatistieken in onze eigen Search Console voor customerimpact.be, oktober 2026.
Hoe je dat botverkeer leest, lichten we toe in ons artikel over de crawlstatistieken in Search Console.
Tools voor logfile-analyse
Voor de echte logs gebruik je een aparte tool, zoals de Log File Analyser van Screaming Frog:
 De Log File Analyser is een ander product dan de SEO Spider. Hij verifieert zoekmachinebots en draait op Windows, macOS en Linux.
Een vergelijking van alternatieven vind je in logfile-analyse tools vergeleken. De methode zelf staat in logfile-analyse voor SEO.
Onze ervaring: we doen veel logfile-analyse, vooral voor grotere bedrijven. Het aantal AI-agents dat websites bezoekt, groeit jaar na jaar sterk.
Dus ook AI-crawlers volgen links. Een wees is voor hen even onzichtbaar.
Wanneer loont het?
Logfile-analyse is bewerkelijker dan een sitemap-export. Het vraagt toegang tot je serverlogs, die niet elke hosting standaard ontsluit.
Voor een kleine site is het vaak overkill en volstaan sitemap en analytics.
Voor grote sites met duizenden pagina’s, waar crawlbudget echt telt, is het de enige manier om zeker te weten welke pagina’s Google negeert.
Beslisregel: schaal je inspanning naar de omvang en de inzet van je site.
Hoort elke wees terug in je structuur?
Nee. Sommige pagina’s zijn bewust verweesd, en dat hoort zo.
Voor je begint te linken: niet elke orphan page is een fout. Denk aan:
- bedankpagina’s na een formulier
- aparte landingspagina’s voor een betaalde campagne
- pagina’s die je expliciet uit de organische index wil houden
Die wil je niet plots in je menu of content gaan inlinken.
Drie categorieën, drie acties
Beoordeel daarom elke gevonden pagina op bedoeling. Grofweg vallen ze in drie categorieën:
| Categorie | Voorbeeld | Actie |
|---|---|---|
| Waardevol, per ongeluk verweesd | Oude dienstpagina, sterk artikel | Terug in je structuur met relevante interne links |
| Verouderd of dun, zonder waarde | Oude actie, dubbele pagina | Samenvoegen, herschrijven of via een redirect afvoeren |
| Bewust verweesd | Bedankpagina, campagne-landingspagina | Met rust laten, eventueel met een noindex |
Bij de middelste groep check je na het afvoeren of je redirects kloppen, bijvoorbeeld met onze redirect checker.
Veel dunne pagina’s tegelijk opruimen heet index bloat opschonen.
Twijfel je tussen noindex, canonical of robots? Lees dan noindex vs canonical vs robots-directives.
Die afweging is precies waar een goede seo specialist het verschil maakt.
Niet blind alles inlinken, maar kiezen wat bijdraagt aan pipeline.
Hoe ga je van opsporen naar inlinken?
Met een paar contextuele links vanuit verwante, sterke pagina’s.
Voor de pagina’s die wél terug moeten, is de fix vaak verrassend eenvoudig. Zoek bestaande pagina’s die thematisch verwant zijn en voeg daar een natuurlijke, contextuele link toe.
Een paar relevante links vanuit sterke content geven de pagina alsnog crawlpaden en interne autoriteit.
Kies je anchors bewust
Tip: gebruik een beschrijvende anchortekst die zegt waar de pagina over gaat. Nooit “klik hier”.
Meer daarover in anchortekst voor interne links. Werk je met honderden pagina’s, lees dan interne links automatiseren.
Een logische plek in je website-architectuur zorgt dat de winst blijvend is in plaats van eenmalig.
De volgorde telt
Belangrijk is de volgorde van je optimalisaties. Eerst opsporen via sitemap, analytics en logs. Dan beoordelen op bedoeling.
Dan pas linken, mergen of afvoeren. Zo ziet dat eruit:
Wie meteen links legt zonder de waarde te checken, vervuilt zijn structuur opnieuw.
Onze ervaring: we beginnen bij een nieuw SEO-traject zelden met backlinks. Meestal herstructureren we eerst de site: interne links, titels en beschrijvingen.
Zo wordt voor Google duidelijk welke pagina’s ertoe doen. De basisbegrippen vind je in de wiki onder internal linking en crawlbudget.
Orphan pages in je groei-engine
Bij Customer Impact behandelen we orphan pages niet als een losse technische opkuis. Ze horen bij één groei-engine.
SEO is de acquisitielaag die je laat ranken én je geciteerd laat worden in AI-zoekmachines zoals ChatGPT en Google AI.
Het doel is nooit een mooie lijst opgeloste wezen, maar pagina’s die bijdragen aan aanvragen.
Meer over die aanpak lees je op de pijlerpagina over wat SEO is.
Wil je weten welke waardevolle pagina’s op jouw site onzichtbaar in de marge hangen?
Neem contact op en we brengen je verweesde pagina’s en hun potentieel in kaart.
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.