
SEO
Noindex, canonical of robots.txt: welke directive wanneer?
 Tanguy De Keyzer Oprichter & digitale strateeg · Bijgewerkt 12 november 2026 · ◷ 10 min leestijd
Kopieer voor AI
Robots.txt regelt crawlen, noindex regelt indexeren, canonical kiest welke versie telt.
Toch worden noindex, canonical en robots.txt constant door elkaar gehaald. Ze klinken alle drie als manieren om Google iets te verbieden.
Het verdict: bij noindex vs canonical vs robots.txt kies je niet de “sterkste”, maar de directive die past bij je vraag.
Wie ze willekeurig inzet, krijgt het omgekeerde resultaat. Pagina’s die je weg wilde houden staan in de index, en pagina’s die je wilde tonen verdwijnen.
Hieronder vind je een beslismatrix per situatie, plus de combinaties die vaak het tegenovergestelde doen van wat je verwacht.
Wil je eerst de basis scherp, lees dan onze pillar over wat SEO is.
Noindex vs canonical vs robots.txt: welke vraag stelt elke directive?
Elke directive beantwoordt een andere vraag, op een ander moment in het proces van Google.
De fout begint bijna altijd op hetzelfde punt. Mensen denken dat de drie hetzelfde doen, namelijk “een pagina uit Google halen”.
Dat klopt niet. Google doorloopt drie stappen: eerst crawlen, dan indexeren, dan beslissen welke versie telt.
Drie directives, drie verschillende vragen
Zo verdeel je ze over die drie stappen:
- Robots.txt: mag Google deze pagina of map crawlen? Regelt toegang, niet zichtbaarheid.
- Noindex: mag de gecrawlde pagina in de index? Regelt indexatie.
- Canonical: welke variant telt als de echte? Regelt consolidatie, niet uitsluiting.
Google zegt het zelf vrij hard: robots.txt is “not a mechanism for keeping a web page out of Google” (Google over robots.txt).
Het bestand dient vooral om crawlerverkeer naar je server te sturen.
Hoe ziet een open robots.txt eruit?
Een robots.txt kan heel kort zijn. Kijk naar de enige regel en de sitemap-verwijzing:
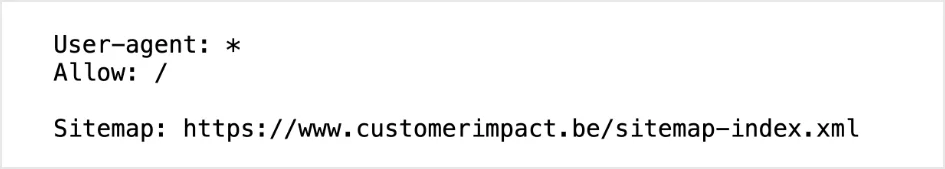 De robots.txt van customerimpact.be, oktober 2026: één regel die alle crawlers toelaat, plus de sitemap.
Hier wordt dus niets geblokkeerd. Wat niet in de index hoort, regel je dan per pagina met een meta robots-tag.
Zodra je de vraag achter elke directive scherp hebt, lossen de meeste twijfelgevallen zich vanzelf op.
De kunst is niet de syntax kennen, maar weten welke vraag je eigenlijk stelt.
Hoe werkt de beslismatrix?
Loop vier vragen in volgorde af. De eerste die “ja” oplevert, geeft je directive.
Zo ziet de matrix eruit in één beeld:
1. Wil je dat Google deze pagina niet crawlt?
Bijvoorbeeld omdat ze waardeloos is voor je crawlbudget, of gevoelig is.
Gebruik dan robots.txt met een Disallow. Denk aan interne zoekresultaten, filtercombinaties die oneindig genereren, of admin-paden.
Let op: dit houdt de pagina niet noodzakelijk uit de index. Linken anderen ernaar, dan kan Google de URL toch tonen, alleen zonder de inhoud te kennen.
Google bevestigt dat: een geblokkeerde URL “can still appear in search results”, maar dan zonder beschrijving.
2. Moet de pagina gecrawld worden, maar niet in de zoekresultaten?
Gebruik een noindex: <meta name="robots" content="noindex"> of de X-Robots-Tag als HTTP-header.
Dit is de juiste keuze voor:
- bedanktpagina’s en login-schermen
- dunne tag-archieven
- een staging-omgeving
Google bezoekt de pagina, ziet de instructie en laat ze weg uit de index.
Cruciaal: de pagina mag dan níét geblokkeerd zijn in robots.txt, anders ziet Google de noindex nooit (Google Search Central).
3. Staat dezelfde inhoud op meerdere URL’s?
Wil je dat één versie alle signalen krijgt, gebruik dan een canonical: <link rel="canonical" href="...">.
Klassiek voorbeeld: een productpagina die bereikbaar is via meerdere categoriepaden, of URL’s met tracking-parameters.
De canonical tag bundelt linkwaarde en voorkomt dat varianten elkaar kannibaliseren. Alle versies blijven bereikbaar voor de gebruiker.
Meer over het probleem erachter lees je in onze uitleg over duplicate content.
4. Moet echt identieke inhoud volledig verdwijnen?
Dan is canonical te zacht. Je wilt niet consolideren, je wilt opruimen.
Kies een 301-redirect als de oude URL weg mag. Kies een noindex als de pagina moet blijven bestaan, maar onzichtbaar.
Vuistregel: Google noemt een redirect een “strong signal” en een sitemap een “weak signal” voor de canonieke keuze (Google over duplicate URL’s).
Controleer na een redirect of je geen ketens bouwt, bijvoorbeeld met onze redirect checker.
| Situatie | Directive | Pagina blijft bereikbaar? |
|---|---|---|
| Interne zoekresultaten, admin | Robots.txt | Ja, maar niet gecrawld |
| Bedanktpagina, staging | Noindex | Ja |
| Varianten van één pagina | Canonical | Ja |
| Oude, overbodige URL | 301-redirect | Nee, doorverwezen |
Waarom gaan de intuïtieve combinaties mis?
Omdat de directives op verschillende stappen werken, kunnen ze elkaar uitschakelen.
Drie combinaties lopen het vaakst fout.
Robots.txt en noindex stapelen op dezelfde pagina
Het lijkt logisch: dubbel zo zeker dat de pagina weg is. In werkelijkheid sluiten ze elkaar uit.
Een noindex is een instructie die ín de pagina staat.
Verbiedt robots.txt het crawlen, dan opent Google de pagina nooit. Het leest de noindex dus ook nooit.
Resultaat: de URL kan alsnog in de index belanden. Je hebt de enige instructie die hem eruit zou houden onbereikbaar gemaakt.
Canonical gebruiken om ongewenste pagina’s te verbergen
Een tweede misverstand. Een canonical is een hint, geen bevel.
Google mag hem negeren als de signalen tegenspreken. Bijvoorbeeld wanneer de twee pagina’s inhoudelijk te veel verschillen.
Voor echte duplicaten werkt het prima. Maar reken er niet op om dunne of ongewenste pagina’s “stil” te krijgen.
Daarvoor heb je noindex of een redirect nodig. Zie je tegenstrijdige signalen, lees dan hoe je canonical-conflicten oplost.
Let op: omgekeerd raadt Google noindex af om binnen één site een canonieke versie te kiezen. Dat “will completely block the page from Search”.
Paginatie en facetnavigatie in webshops
Een derde valkuil. Veel teams plakken een canonical van pagina 2, 3 en verder naar pagina 1.
Dat verbergt je dieper liggende producten voor de index.
Bij paginering is het meestal beter elke pagina zichzelf te laten zijn. Consolideer alleen bij echte parameter-duplicaten.
Hoe je filters onder controle houdt, lees je in onze gids over faceted navigation.
De afweging hangt af van je structuur. Precies daar voegt een seo specialist waarde toe: niet de regel toepassen, maar de uitzondering herkennen.
Hoe past dit in je bredere indexatiestrategie?
Directives zijn de fijnafstelling bovenop een gezonde basis, geen losse trucs.
Voordat je gaat blokkeren of consolideren, wil je weten welke pagina’s überhaupt waarde hebben.
Een pagina noindexen die wél leads zou kunnen opleveren, is net zo schadelijk als een waardeloze pagina laten indexeren.
Daarom begint elke directive-keuze met een inhoudelijk oordeel: wat doet deze pagina voor je pipeline?
Praktische volgorde per pagina
Loop deze vier stappen af:
- Heeft de pagina zoekwaarde? Zo nee, overweeg noindex of verwijderen. Zo ja, laat haar indexeerbaar.
- Versnippert een variant je linkwaarde? Consolideer met canonical of een redirect.
- Verspilt crawlen budget? Sluit oneindige URL-ruimtes af in robots.txt, nooit waar een noindex moet werken.
- Volgt Google je instructies? Controleer het in Search Console.
Meer over stap 3 vind je in ons stuk over crawlbudget. Te veel dunne pagina’s in de index? Dan helpt index bloat opschonen.
Verifieer in Search Console
Die laatste stap wordt het vaakst overgeslagen.
Een directive instellen is geen garantie dat Google hem leest of respecteert. Je verifieert het in de praktijk.
Het rapport Pagina-indexering toont per reden welke URL’s niet geïndexeerd zijn:
Elke directive krijgt er een eigen reden, zodat je per type ziet of hij werkt. Hoe je dat rapport leest, staat in onze uitleg over het indexeringsrapport in Search Console.
Daarnaast toont het crawlrapport hoe vaak Google je site echt bezoekt:
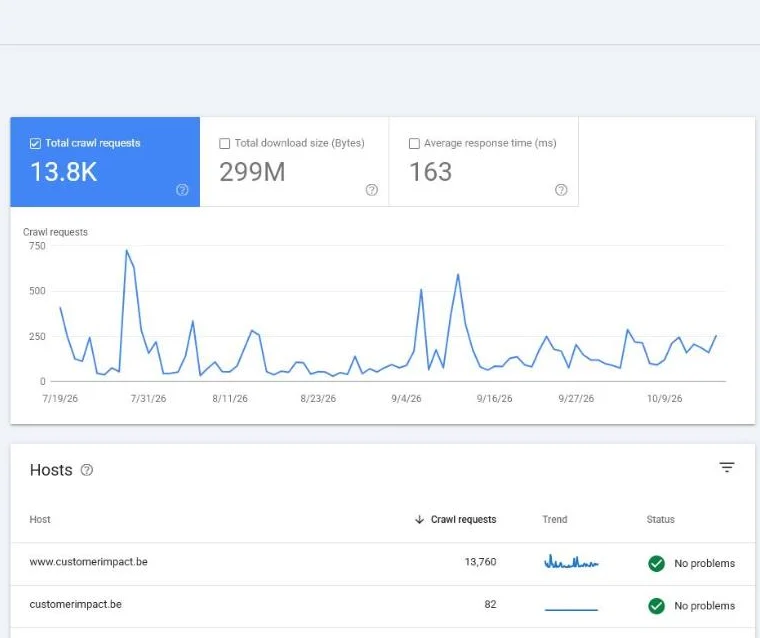 Crawlstatistieken in onze eigen Search Console voor customerimpact.be, oktober 2026 (Engelse interface): 13,8K crawlverzoeken en 163 ms gemiddelde reactietijd.
Bij ons kreeg de www-host 13.760 verzoeken en de host zonder www 82.
Zie je daar veel verzoeken naar filter- of zoekpagina’s, dan is robots.txt het juiste middel. Meer in crawlstatistieken in Search Console.
Wil je het crawlproces zelf beter sturen, dan helpt onze uitleg over een XML-sitemap opzetten je verder.
Onze kijk: directives zijn pipeline-keuzes, geen technische trucs
Bij Customer Impact zijn crawl- en indexatiedirectives geen aparte technische to-do.
Ze zijn een onderdeel van één groeimotor, met één meetlat: gekwalificeerde pipeline.
Elke pagina die je laat indexeren of bewust weghoudt, is een keuze over waar je autoriteit en aandacht naartoe gaan.
Hetzelfde geldt voor AI-zoekmachines
ChatGPT, Google AI en Perplexity citeren bronnen op basis van helderheid en structuur.
Is je index een rommeltje van duplicaten en dunne pagina’s, dan verzwak je ook je kans om geciteerd te worden.
Schone directives maken je vindbaar én citeerbaar: twee lagen van dezelfde beweging.
Let op: robots.txt stuurt ook AI-crawlers zoals GPTBot. Lees eerst of je AI-bots blokkeert of binnenlaat.
De fout die we het vaakst zien
Teams zetten directives reactief in, pagina voor pagina, zonder beeld van welke inhoud ertoe doet.
Daardoor blokkeren ze soms hun beste pagina’s en laten ze hun zwakste staan.
De matrix hierboven werkt pas als hij bovenop een duidelijke inhoudelijke prioritering ligt. Die past in een bredere technische SEO-aanpak.
Veelgestelde vragen
Wat is het verschil tussen noindex en canonical?
Noindex houdt één pagina uit de index. Canonical wijst bij varianten één versie aan die de signalen krijgt, terwijl alle varianten bereikbaar blijven.
Haalt robots.txt een pagina uit Google?
Nee. Robots.txt verbiedt alleen het crawlen. Een geblokkeerde URL kan nog in de zoekresultaten staan, maar dan zonder beschrijving.
Mag ik noindex en canonical op dezelfde pagina zetten?
Liever niet. Ze sturen tegenstrijdige signalen: de ene zegt “niet indexeren”, de andere “tel die andere versie”. Kies de directive die bij je vraag past.
Hoe weet ik of Google mijn directive volgt?
Kijk in het rapport Pagina-indexering van Search Console. Daar staat per reden, zoals noindex of canonical, welke URL’s uitgesloten zijn.
Aan de slag
Kies per pagina eerst de vraag, dan pas de directive.
Twijfel je welke directive op welke pagina hoort, of vermoed je dat een verkeerde combinatie je vindbaarheid in de weg zit? Vertel ons je situatie en je doel.
Neem contact op en je hoort binnen 24 uur waar je grootste kansen liggen, in zowel Google als AI-antwoorden.
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.