
Website & Development
HTML sémantique : rendez vos pages lisibles pour l'IA

Copier pour l'IA
Le HTML sémantique, c’est la bonne balise pour le bon contenu.
Un titre est un vrai <h2>, une liste un vrai <ul>, un tableau un vrai <table>.
Ainsi, un crawler lit le sens de votre page. Il ne devine plus.
Le verdict : le HTML sémantique n’est pas une astuce IA. C’est du bon travail de construction qui sert l’IA, l’accessibilité et vos visiteurs.
Vous voulez que ChatGPT, les AI Overviews de Google ou Perplexity comprennent et citent vos pages ?
Alors votre contenu doit aussi parler aux machines. Pas seulement aux humains.
Qu’est-ce que le HTML sémantique exactement ?
C’est du HTML où chaque balise décrit ce que le contenu signifie, et non de quoi il a l’air.
Un <h2> dit “ceci est un titre de section”. Un <ul> dit “ceci est une liste”. Un <table> dit “ce sont des données en lignes et en colonnes”.
Ces balises portent du sens.
Et ce sens, c’est ce dont une machine a besoin.
La définition de MDN
La documentation de MDN sur la sémantique le résume bien. La sémantique, c’est “quel est le rôle ou le but de cet élément HTML”, plutôt que “à quoi ressemble-t-il”.
MDN prend l’exemple d’un <span> stylé en grand.
Il ressemble à un titre. Il n’en a aucun avantage.
MDN cite aussi un gain de maintenance : un développeur retrouve plus vite des blocs significatifs qu’une multitude de div.
Notre définition du HTML reprend les bases si vous partez de zéro.
Balisage d’apparence contre balisage de sens
L’inverse du HTML sémantique, c’est un balisage qui ne pilote que l’apparence. Par exemple, un titre qui n’est qu’une <div> en gros caractères gras.
Ou une “liste” faite de lignes isolées précédées de tirets.
Pour un humain, cela paraît identique. Pour une machine, la différence est énorme :
<!-- Apparence seulement -->
<div class="grand-gras">Combien coûte un site B2B ?</div>
<div>• Design</div>
<div>• Développement</div>

<!-- Sens explicite -->
<h2>Combien coûte un site B2B ?</h2>
<ul>
  <li>Design</li>
  <li>Développement</li>
</ul>
La première variante laisse un bloc de texte indifférencié.
La seconde indique le rôle de chaque élément.
En bref : ce que vous montrez à l’écran doit aussi exister dans le code. C’est ce code que l’IA voit.
Pourquoi l’IA lit-elle votre HTML et non votre mise en forme ?
Parce que les crawlers IA travaillent sur le HTML brut, pas sur l’image finie dans le navigateur.
Les couleurs, tailles de police et positions définies en CSS sont, pour l’extraction, du bruit.
Ce qui compte, c’est l’arborescence des balises.
Voici comment une machine voit deux pages qui se ressemblent à l’écran :
Comment l’IA découpe votre page
Quand une IA traite votre page, elle essaie de la découper en morceaux porteurs de sens :
- quel est le titre principal ;
- quelles questions la page traite ;
- quelle réponse va avec quel titre ;
- quelles sont les énumérations et les données.
Si tout est placé dans des balises sémantiques, le modèle extrait ces morceaux directement.
Sinon, il devine.
Et deviner produit des erreurs.
Notre article sur le content chunking pour l’IA montre comment ces morceaux sont formés.
Pourquoi deux pages identiques performent différemment
Deux pages identiques pour un humain peuvent avoir des performances totalement différentes dans les réponses de l’IA.
L’une livre des blocs bien délimités et citables.
L’autre livre un mur de texte.
Un balisage propre augmente la chance qu’un morceau précis de votre page soit retenu comme réponse.
Le texte doit exister dans le HTML
Une précision s’impose. Google dit lui-même qu’il n’existe aucune optimisation spéciale requise pour apparaître dans les AI Overviews ou AI Mode.
Il demande en revanche que le contenu important soit disponible sous forme de texte.
Un contenu chargé uniquement en JavaScript côté client, ou enfermé dans une image, reste donc difficile à lire. Voyez notre article sur le rendu côté client et les moteurs IA.
Un crawler doit aussi avoir le droit de lire la page. Notre propre robots.txt, par exemple, laisse entrer tous les bots :
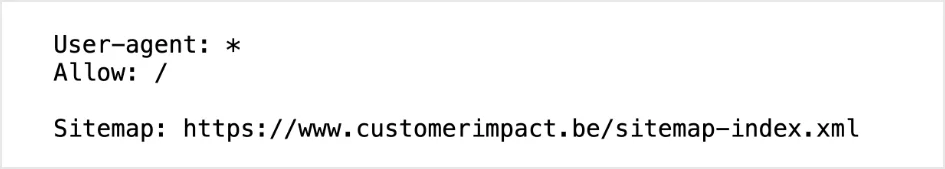 Notre propre robots.txt, octobre 2026 : une seule règle pour tous les crawlers, donc chaque bot IA peut lire le HTML du site.
Le détail est dans notre guide pour autoriser les crawlers IA.
Comment rendre son contenu extractible par les machines ?
En commençant par une structure de titres logique, puis en utilisant de vraies listes et de vrais tableaux.
Voici les choix qui font le plus de différence, dans l’ordre.
1. Une seule hiérarchie de titres claire
Un <h1> avec le sujet principal. En dessous, des <h2> pour les sous-questions. Et des <h3> seulement pour les éléments à l’intérieur d’une section.
Ne sautez pas de niveaux. Le tutoriel du W3C sur les titres le dit clairement : sauter des rangs de titres peut prêter à confusion et doit être évité.
Choisissez le niveau selon le sens, pas selon la taille du texte.
Une hiérarchie propre est une table des matières pour la machine.
2. Des titres formulés comme la question posée
“Combien coûte un site web B2B ?” est bien plus utile pour une IA que “Investissement”.
Le titre correspond déjà à une vraie question.
Faites-le suivre d’une réponse courte et complète. Développez ensuite.
Ainsi, chaque section devient un bloc autonome et citable.
Notre guide du contenu citable par l’IA donne d’autres exemples de formulation.
3. De vraies listes pour les énumérations
Une série de points a sa place dans un <ul> ou un <ol>.
Pas dans des paragraphes avec des tirets.
Une vraie liste dit explicitement : ce sont des éléments distincts et de même niveau.
C’est précisément le type de contenu qui revient souvent sous forme de puces dans les réponses de l’IA.
4. Des tableaux uniquement pour de vraies données
Vous comparez des options, des prix ou des spécifications ?
Utilisez un <table> avec des cellules d’en-tête <th> propres.
Un bon tableau avec des en-têtes clairs est l’une des formes de données les plus faciles à extraire.
Attention : ne détournez pas les tableaux pour la mise en page. Vous enverriez un faux signal sur le sens du contenu.
Notre article sur les tableaux et les citations IA détaille ce point.
5. Les bons éléments pour les autres rôles
Plus vous rendez de rôles explicites, moins une machine doit interpréter. Les éléments les plus courants :
| Contenu | Élément | Ce qu’il dit à la machine |
|---|---|---|
| Contenu principal | <main> | Voici le cœur de la page |
| Navigation | <nav> | Ce sont des liens de menu, pas du contenu |
| Citation | <blockquote> | Ce texte vient d’une autre source |
| Code | <code> | Ceci est du code, pas de la prose |
| Article autonome | <article> | Ce bloc tient debout seul |
Le point commun : vous dites à la machine ce qu’une chose est. Elle n’a plus à le déduire.
Comment le HTML sémantique se rapporte-t-il au balisage schema ?
Ils se complètent : le premier structure le contenu visible, le second ajoute une couche de sens explicite.
Les balises sémantiques disent qu’une chose est un titre, une liste ou un tableau. Le balisage schema, les données structurées, dit en plus qu’un bloc décrit une FAQ, un produit ou une organisation.
Le bon ordre : d’abord la base, puis la finition
Vous avez besoin des deux, mais dans le bon ordre.
Du balisage schema sur une page au HTML brouillon, c’est du vernis sur une base bancale.
Commencez par une construction propre. Ajoutez ensuite des données structurées là où elles apportent quelque chose.
Ce fonctionnement est expliqué dans notre article sur le balisage schema et le principe plus large des données structurées.
Vérifiez que le schema colle au texte visible
Google demande que vos données structurées correspondent au texte visible de la page. Un validateur montre ce que la machine trouve :
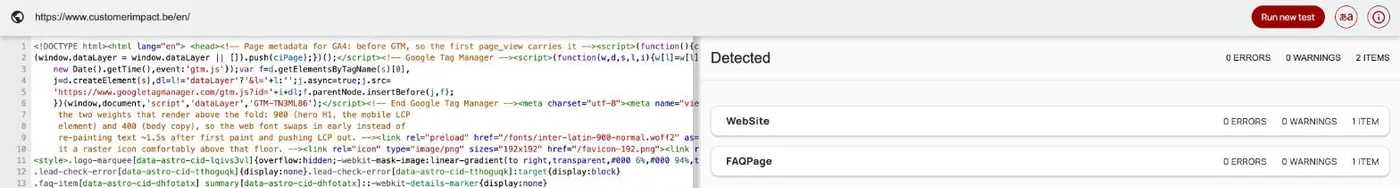 Le Schema Markup Validator sur notre page d’accueil anglaise, octobre 2026 : 2 types détectés, 0 erreur.
Le FAQPage détecté ici ne vaut que parce que la FAQ existe aussi en vrais titres et paragraphes. Voyez comment tester votre balisage schema.
Le piège ? Croire que le schema compense une structure de page négligée. Il ne le peut pas.
Est-ce uniquement pour l’IA, ou aussi pour vos visiteurs classiques ?
Les deux : ce qui rend votre contenu lisible pour l’IA le rend aussi plus accessible et plus clair.
Ce n’est pas une astuce IA à part.
C’est du travail de qualité qui paie sur plusieurs fronts. Voici l’effet par public :
| Public | Effet du HTML sémantique | Force de l’effet |
|---|---|---|
| Lecteurs d’écran | Navigation par titres et repères | Immédiat |
| Visiteurs | Ils trouvent plus vite leur réponse | Direct |
| Moteurs IA | Blocs plus faciles à extraire | Réel, sans garantie |
| Classement Google | Pas de gain de classement des balises seules | Limité |
Pour l’accessibilité, l’effet est immédiat
Les lecteurs d’écran s’appuient sur les balises sémantiques pour lire une page à voix haute et la rendre navigable.
Le W3C rappelle que les navigateurs et technologies d’assistance utilisent les titres pour la navigation dans la page.
Un utilisateur qui saute de titre en titre ne peut le faire que si vos titres sont réellement des titres.
Un balisage négligé exclut une partie de vos visiteurs.
C’est l’une des erreurs de notre article sur les erreurs d’accessibilité fréquentes.
Pour le cadre légal et les bases, voyez aussi notre guide de l’accessibilité d’un site web.
Pour le SEO classique, l’effet est plus limité qu’on ne le dit
Le guide de démarrage SEO de Google recommande des titres pour aider les utilisateurs à naviguer.
Mais il précise que l’ordre des titres n’a pas d’importance pour la recherche Google. Et que Google peut rarement s’appuyer sur le sens caché dans la spécification HTML, car une grande partie du web n’utilise pas un HTML valide.
N’attendez donc pas de gain de classement des seules balises.
Pour vos visiteurs, c’est une question de vitesse
Avec des titres clairs, ils trouvent plus vite ce qu’ils cherchent.
Cela aide directement à transformer des visiteurs en leads.
Chez Customer Impact, nous construisons donc de façon indépendante de la plateforme, sur une base propre et sémantique.
Que votre site tourne sous Webflow, WordPress ou en headless, le principe ne change pas.
Pour le contexte stratégique, lisez notre guide sur le generative engine optimization.
Puis passez au crible avec notre checklist d’un site lisible par l’IA.
Comment vérifier le HTML sémantique de votre site ?
En 4 contrôles rapides, sans outil payant. Comptez une demi-heure pour vos pages clés.
Contrôle 1 : inspectez le code d’un titre
Faites un clic droit sur un titre de votre page, puis “Inspecter”.
Vous voyez un <h2> ou un <h3> ? Bien. Vous voyez une <div> ou un <span> ? Ce titre n’en est pas un pour la machine.
Répétez le test sur une liste et sur un tableau. Ce sont les deux autres blocs que l’IA reprend volontiers.
Contrôle 2 : dressez le plan de vos titres
Listez tous les titres de la page, dans l’ordre. Le HTML en prévoit 6 niveaux, de <h1> à <h6>.
Le plan doit se lire comme une table des matières. Un seul <h1>, pas de saut de <h2> à <h4>.
Exemple : une page de service avec trois <h1> envoie un signal flou sur son sujet principal.
Contrôle 3 : naviguez au clavier ou au lecteur d’écran
Activez le lecteur d’écran de votre système et sautez de titre en titre.
Si la page se parcourt sans peine, la structure tient. Si des blocs entiers manquent, le balisage cache quelque chose.
Contrôle 4 : comparez avec ce que lit l’IA
Collez l’URL dans un assistant IA et demandez un résumé par section.
Les sections reviennent dans le bon ordre, avec les bonnes réponses ? Votre structure passe. Sinon, revenez au contrôle 2.
Attention : ce dernier test est indicatif. Une IA peut aussi s’appuyer sur d’autres sources que votre page.
Les points qui reviennent le plus souvent lors de ces contrôles :
- titres créés avec des
<div>stylées ; - plusieurs
<h1>sur une même page ; - listes faites de tirets tapés à la main ;
- tableaux utilisés pour la mise en page.
Questions fréquentes
Le HTML sémantique améliore-t-il mon classement Google ?
Pas directement. Google dit que l’ordre des titres n’a pas d’importance pour le classement. Le gain se trouve dans l’accessibilité, la clarté pour le visiteur et l’extraction par l’IA.
Quelles balises sémantiques comptent le plus ?
Les titres (<h1> à <h3>), les listes (<ul>, <ol>), les tableaux (<table> avec <th>) et <main>. Ce sont elles qui découpent votre contenu en blocs lisibles.
Le balisage schema peut-il remplacer le HTML sémantique ?
Non. Le schema ajoute une couche de sens par-dessus. Sur une page mal structurée, il ne compense rien, et il doit correspondre au texte visible.
Mon constructeur de site produit-il du HTML sémantique ?
Pas toujours. Beaucoup d’outils génèrent des <div> pour tout. Inspectez le code d’une page et vérifiez que vos titres et listes utilisent les bonnes balises.
Le résumé en bref
Le HTML sémantique, c’est la bonne balise pour le bon contenu, pour qu’une machine lise directement la structure de votre page.
Les modèles d’IA lisent ce code sous-jacent, pas votre mise en forme. Une hiérarchie de titres logique, de vraies listes et de vrais tableaux rendent votre contenu facile à extraire et à citer.
Le balisage schema vient s’y ajouter, mais ne remplace jamais une base négligée.
Le gain est double : la même construction propre aide l’IA et rend votre site plus accessible et plus agréable.
Vous voulez que notre concepteur de site web place vos pages sur une base propre et lisible par les machines ?
Contactez-nous et nous regardons ensemble où votre site laisse de la structure de côté.
Scan gratuit de votre site
Indiquez votre site et recevez en quelques minutes une analyse automatique avec des points d'amélioration techniques et SEO concrets. Sans discours commercial.
Nous utilisons vos données uniquement pour votre scan. Pas de spam, désinscription à tout moment.