
SEO & GEO
Mechanistic interpretability voor merken: kijken in het brein van het model

Kopieer voor AI
Mechanistic interpretability toont hoe een AI-model je merk intern voorstelt, niet alleen wat het zegt.
Het verdict: voor merken is het een diagnose-instrument voor gevorderden. Je hebt het niet nodig om zichtbaar te zijn, maar het verklaart waarom je wel of niet genoemd wordt.
In bijna elk gesprek over AI-zichtbaarheid behandelen we taalmodellen als een black box.
We meten wat eruit komt: citaties, vermeldingen, antwoorden. En we sleutelen aan wat erin gaat: content, structuur, boodschap.
Dat werkt prima. Je boekt forse vooruitgang zonder ooit te weten wat er binnenin het model gebeurt.
Maar er bestaat een dieper niveau. Een niveau dat niet alleen toont dat je merk vermeld wordt, maar ook waarom: de interne mechanismen die de vermelding veroorzaken.
Dat is mechanistic interpretability: de opkomende wetenschap die probeert te begrijpen hoe neurale netwerken informatie echt verwerken.
Voor merken biedt het iets wat geen andere aanpak kan geven: zicht op hoe een AI-systeem je bedrijf, producten en categorie intern voorstelt en erover redeneert.
Hieronder leg ik in mensentaal uit wat je ziet als je in dat model kijkt, en wat je ermee kan.
Het is een gevorderd onderdeel van de ultieme GEO-handleiding, waarbij GEO staat voor generative engine optimization. Nieuw met taalmodellen? Begin dan bij wat een LLM is voor marketeers.
Verwacht geen knoppen die je morgen zelf indrukt. Wel een mentaal model dat je helpt scherpere keuzes te maken.
Hoe scoort jouw pagina? Check je GEO-readiness met onze gratis GEO-tool.
Wat legt mechanistic interpretability bloot over je merk?
De interne representatie van je merk: welke concepten, welk sentiment en welke zekerheid het model eraan koppelt.
Verwerkt een taalmodel je merknaam, dan activeert het specifieke patronen door zijn neurale netwerk heen. Die activatiepatronen zijn de interne representatie van je merk: hoe het model over je “denkt”.
Door die patronen te onderzoeken, komen een paar dingen aan het licht.
Associatiestructuur
Welke concepten lichten op naast je merk?
Bijvoorbeeld: stel dat een fictief “DataFlow Platform” het model binnenkomt. Dan zou je kunnen zien dat dit sterk activeert:
- Sterk: data-integratie en real-time verwerking
- Matig: enterprise software en cloud
- Nauwelijks: consumententoepassingen
Die interne associatiekaart toont wat het model echt aan je merk koppelt. Niet wat jij in je marketing beweert, maar wat het model heeft geleerd.
Sentiment en zekerheid
Modellen dragen ook een impliciete waardering met zich mee.
Activeren er bij je merk vooral positieve of negatieve sentimentcircuits? Sterk positief intern sentiment is een structureel voordeel in aanbevelingscontexten. Het model “voelt” zich goed bij je naam.
Daarnaast is er zekerheid. Hoe zeker is het model over jou?
Activeren er veel onzekerheidscircuits, dan voorspelt dat hedging in de output: “DataFlow Platform lijkt te zijn…” in plaats van “DataFlow Platform is…”.
Vuistregel: voorzichtige taal van het model is vaak een symptoom van een onzekere interne representatie.
Aan de outputkant zie je alleen het antwoord zelf, zoals hier:
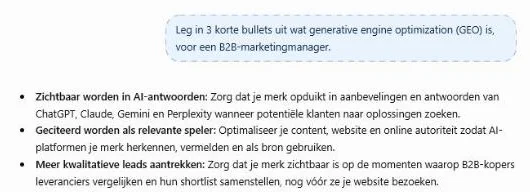 ChatGPT (gratis versie) op onze eigen GEO-vraag, oktober 2026. Geen bronnen in beeld: het model antwoordt uit wat het al weet.
Het antwoord vertelt je wat het model zegt. Interpretability probeert te tonen waarom het dat zegt. Hoe je die toon vandaag al meet, lees je in sentiment in AI-merkvermeldingen meten.
Wat het onderzoek over bekende namen vond
Echt onderzoek maakt dit concreet.
Anthropic traceerde in Claude 3.5 Haiku hoe het model met namen omgaat. Weigeren te antwoorden bleek het standaardgedrag. Een feature voor “bekende entiteit” onderdrukt die weigering bij namen die het model kent.
Vuurt die feature verkeerd, dan kan het model een antwoord verzinnen over een naam die het eigenlijk niet kent.
Voor merken is dat een sterk signaal: bekend zijn bij het model is letterlijk een intern mechanisme. Wat er misgaat als dat faalt, lees je in wat een AI-hallucinatie is.
Redeneerpaden en selectie
Naast statische representaties kan je traceren hoe het model redeneert.
Bij een vraag als “Wat is het beste platform voor real-time data-integratie?” doorloopt het model ruwweg deze stappen:
- Intentie parsen: het herkent een vraag om een aanbeveling.
- Categoriekennis activeren: het cluster rond “real-time data-integratie” licht op.
- Kandidaten ophalen: meerdere merkrepresentaties activeren.
- Kandidaten evalueren: vergelijkingscircuits springen aan.
- Antwoord selecteren: de kandidaat met de hoogste zekerheid wint.
- Output genereren: het natuurlijke antwoord rolt eruit.
Visueel versmalt die keten van een brede vraag naar één gekozen merk. Elke laag zeeft kandidaten weg, en je doel is om al vroeg in het pad mee te activeren:
Door dit pad te volgen, zie je waar je merk de redenering binnenkomt, of net niet.
Drie vragen om aan je eigen merk te stellen:
- Activeer je al bij stap 3?
- Hoe sterk?
- Hoe doe je het in de vergelijking bij stap 4?
Dat sluit nauw aan bij hoe ik de anatomie van AI-bronselectie beschrijf: niet één moment, maar een keten van beslissingen.
Welke technieken zitten achter de schermen?
Vijf hoofdtechnieken, van activaties aflezen tot er bewust op ingrijpen.
Je hoeft deze methodes niet zelf te implementeren. Maar ze begrijpen helpt om bevindingen te interpreteren.
De vijf technieken in begrijpelijke termen
- Activatie-analyse: voer je merknaam in, registreer welke neuronen per laag oplichten en map dat naar interpreteerbare concepten.
- Attention-analyse: transformermodellen gebruiken attention om te bepalen waar ze naar “kijken”. Die gewichten tonen welke context je merkverwerking beïnvloedt.
- Probing classifiers: train een eenvoudig modelletje op de activaties. Zo test je of een eigenschap als “enterprise-gericht” echt in je representatie gecodeerd zit.
- Causale interventie: pas activaties bewust aan en kijk hoe de output verandert. Zo onderscheid je correlatie van echte oorzaak.
- Circuitanalyse: traceer het volledige pad van input tot output, om te begrijpen welk onderdeel wat bijdraagt.
Wat het werk van Anthropic aantoonde
Dat causale interventie werkt, toonde Anthropic aan door interne features kunstmatig te versterken of te onderdrukken.
Het team haalde met dictionary learning miljoenen features uit de middelste laag van Claude 3.0 Sonnet, een productiemodel. Elke feature hoort bij een menselijk herkenbaar concept, zoals een stad, een persoon of een wetenschapsdomein.
Versterkten ze de feature voor de Golden Gate Bridge, dan bracht het model die brug zelfs ter sprake bij vragen die er niets mee te maken hadden.
Let op: de onderzoekers zeggen zelf dat de gevonden features maar een klein deel zijn van alle geleerde concepten.
Waar staat je merk in de representatieruimte?
In een hoog-dimensionale embeddingruimte, waar je buren je associaties verraden.
Een van de toegankelijkste analyses kijkt naar die embeddingruimte. Moderne modellen stellen woorden en concepten voor als vectoren. Je merk neemt daar een positie in.
Hoe zulke vectoren werken, lees je in wat is vectorzoeken.
Gezonde en ongezonde buren
Zit je merk dicht bij concurrenten en categoriebegrippen, dan is dat gezonde positionering. Je activeert mee bij categorievragen.
Zit een merk vooral in “startup-ruimte”, naast termen als emerging of unproven? Dan activeert het mogelijk niet bij categorievragen. Het ligt simpelweg niet in de buurt van de juiste concepten.
Dat is een fundamenteel ander probleem dan een zwakke tekst. Het vraagt om een andere oplossing, zoals een consistentere entiteit op het hele web. Daarover gaat entiteitsconsistentie voor AI-zichtbaarheid.
Welke attributen sterk gecodeerd zijn
Je kan ook testen welke attributen sterk gecodeerd zijn.
Misschien sta je stevig bekend als enterprise-gericht en real-time-capabel. Maar zwak als gebruiksvriendelijk of kostenefficiënt, terwijl een concurrent net die laatste positionering bezit.
Dat vertelt je precies waar je perceptiekloof zit.
Het geheugen van het model
Hier raakt interpretability aan iets dat ik vaker benadruk. Zichtbaarheid is geen toeval, maar het gevolg van hoe sterk en stabiel je in het geheugen van het model zit.
Wie dit wil opvolgen zonder in de modelinterne keuken te duiken, kan beginnen bij brand salience meten. Dat stelt dezelfde vraag vanaf de outputkant.
Tools als Ahrefs Brand Radar doen dat aan de outputkant, met share of voice over AI-antwoorden:
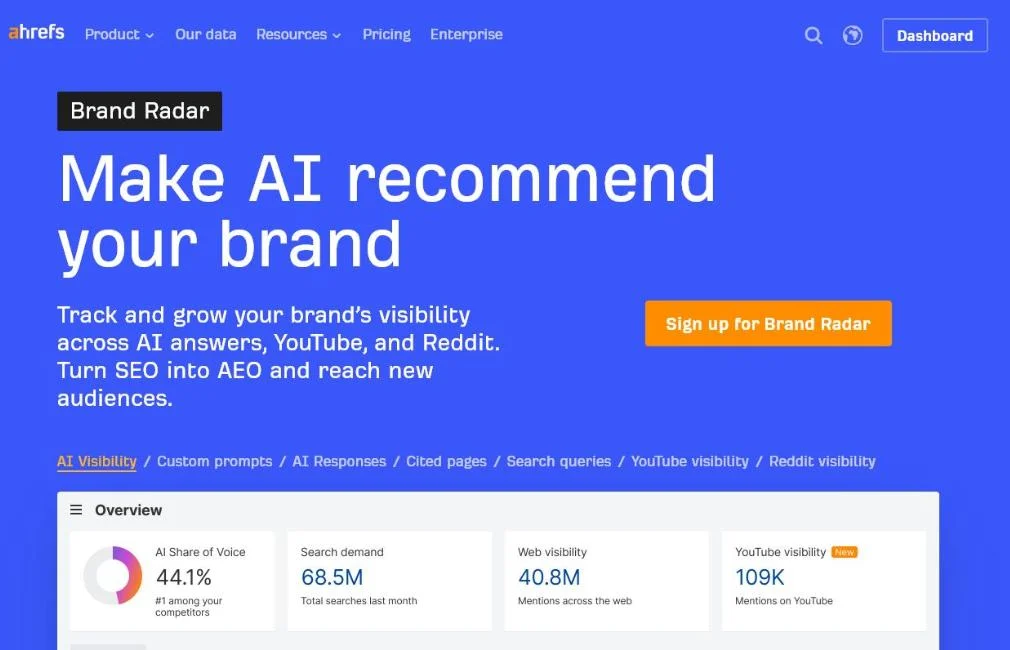 De productpagina van Ahrefs Brand Radar, oktober 2026 (Engelse versie). Een demo-overzicht van AI share of voice.
Zo’n score toont dat je meer of minder genoemd wordt. Meer daarover in AI share of voice meten.
Hoe vergelijk, selecteer en grijp je in?
Door vergelijkingscircuits af te lezen en daarna gericht op representaties in te grijpen.
Het echt interessante gebeurt bij vergelijking en interventie.
Waar je een vergelijking verliest
Bij een directe “jij versus concurrent”-vraag activeren vergelijkingscircuits die attributen wegen.
Bijvoorbeeld: stel dat je sterk scoort op feature-volledigheid en prijs-waardeverhouding. Maar je verliest op marktaanwezigheid en merkvertrouwen, en net die twee wegen samen dertig procent van de vergelijking.
Dan weet je meteen waar je optimalisatie-energie naartoe moet.
Niet gokken op basis van de output, maar rechtstreeks aflezen welke factoren de doorslag geven.
Interventie als bewijs
De krachtigste techniek is ingrijpen op de interne representaties en kijken wat verandert.
Een paar voorbeelden van wat zoiets kan aantonen:
- Activation steering: versterk kunstmatig de “enterprise-gerichte” activatie van je merk. Schuift je merk daardoor naar voren in het antwoord, dan heb je een causaal verband aangetoond.
- Concept-erasure: onderdruk een concurrent in de overweging van het model. Activeert jouw merk daardoor sterker, dan dempte die concurrent jouw activatie actief. Jullie vechten letterlijk om dezelfde ruimte.
- Representation editing: voeg een attribuutvector als “innovatief” toe aan je merk-embedding. Beschrijft het model je dan als “vooruitstrevend”, dan is de link tussen representatie en taalgebruik bevestigd.
Belangrijk: dit zijn analysetechnieken om te begrijpen, geen knoppen om productiemodellen te manipuleren.
Ze tonen wat zou werken als je de onderliggende perceptie in de echte wereld versterkt.
Waarvoor gebruik je het in de praktijk?
Voor diagnose, prioritering en het vroeg zien van concurrenten.
Diagnose
Is je zichtbaarheid lager dan verwacht, dan helpt interpretability de oorzaak vinden:
| Symptoom | Mogelijke bevinding | Actie |
|---|---|---|
| Lage selectie ondanks goede content | Zwak autoriteitssignaal in de activatie | Bouw autoriteit op in bronnen die het model voedt |
| Niet vermeld bij categorievragen | Merk ligt niet dicht bij categorieconcepten | Versterk de categorie-associatie in al je communicatie |
| Vermeld, maar met voorzichtige taal | Hoge onzekerheidsactivatie | Vergroot je aanwezigheid in gezaghebbende bronnen |
Prioritering
Interpretability toont ook welke optimalisaties het zwaarst wegen.
Wegen selectiecircuits semantische relevantie zwaarder dan autoriteit? Dan heeft relevantiewerk meer impact dan linkbuilding.
Voorspelling
En het is voorspellend. Zie je de embedding van een nieuwe concurrent richting je categorieruimte bewegen, dan versterk je je positionering voordat die echt opduikt.
Die voorsprong sluit aan bij wat ik bij primary bias beschrijf. Wie eerst stevig in het modelgeheugen zit, bouwt een blijvend voordeel op.
Wat zijn de grenzen, en hoe gebruik je het eerlijk?
De bevindingen zijn benaderingen, en de techniek hoort bij verdiende zichtbaarheid, niet bij manipulatie.
Benaderingen, geen absolute waarheid
Interpretability is niet perfect.
De bevindingen komen vaak van open analysemodellen zoals Llama of Mistral. Die dienen als proxy voor gesloten modellen als GPT of Gemini. En ze kunnen verouderen zodra modellen updaten.
Ook het werk van Anthropic zelf vangt volgens de onderzoekers maar een fractie van de berekening van het model. Het begrijpen van de circuits bij prompts van enkele tientallen woorden kost nu nog enkele uren mensenwerk.
De ethische lijn
En er is een ethische lijn.
Begrijpen hoe modellen werken om betere content te maken die gebruikers dient, is iets anders dan modellen bespelen voor onverdiende aanbevelingen.
De intentie maakt het verschil. Optimaliseren voor verdiende zichtbaarheid blijft het uitgangspunt.
Veelgestelde vragen
Heb ik mechanistic interpretability nodig om zichtbaar te zijn in AI?
Nee. Vrijwel alles wat je zichtbaarheid oplevert, werkt zonder dat je ooit in een model kijkt.
Het is een frontier-techniek voor organisaties die maximaal voordeel zoeken en de infrastructuur en expertise in huis hebben of inkopen. Voor de meeste merken zijn degelijke content, structuur en autoriteitsopbouw belangrijker en haalbaarder.
Kan ik dit zelf toepassen op ChatGPT of Gemini?
Niet rechtstreeks. Gesloten modellen geven hun gewichten en activaties niet vrij.
Onderzoekers werken dus met open modellen als proxy en valideren bevindingen tegen de output van de gesloten modellen. Je accepteert een benadering in ruil voor diepgang.
Publieke API’s van gesloten modellen geven je hooguit signalen aan de outputkant, zoals tokenkansen. Echte interne analyse vereist open-weight modellen.
Wat is het verschil met gewoon mijn AI-vermeldingen meten?
Vermeldingen meten gebeurt aan de outputkant: je ziet dat je genoemd wordt en in welke context.
Interpretability kijkt naar de redenering zelf en toont waarom: welke associaties, welk sentiment en welke zekerheid het model aan je merk koppelt.
Het ene vertelt je de score, het andere het mechanisme erachter. Zonder tools beginnen kan ook, zie AI-zichtbaarheid meten zonder tools.
Welke concrete actie levert dit op voor mijn marketing?
Vooral scherpere prioritering.
In plaats van te gokken, lees je af of het om relevantie, autoriteit, categorie-associatie of de perceptie van een attribuut gaat.
Die diagnose stuurt je budget naar de hefboom die echt telt: betere content, meer gezaghebbende bronnen of een sterkere categoriepositionering.
Hulp nodig?
Wil je dit vertalen naar uitvoering? Bekijk hoe we dit aanpakken met AI-vindbaarheid.
100 GEO-tips om genoemd te worden in ChatGPT en Google AI
- 10 hoofdstukken:van robots.txt en Bing tot meten
- Copy-paste:regex voor Search Console en GA4
- Sjablonen:koopvragen per fase en een 30-dagenplan
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.