
SEO & GEO
Interprétabilité mécaniste pour les marques : regarder dans le cerveau du modèle

Copier pour l'IA
L’interprétabilité mécaniste montre comment un modèle d’IA se représente votre marque, en interne.
Elle ne montre pas seulement que votre marque est mentionnée, mais pourquoi : les mécanismes qui provoquent la mention.
Le verdict : une technique de pointe, pas indispensable pour être visible dans l’IA.
Mais un modèle mental précieux pour faire des choix plus tranchés.
En anglais, on parle de mechanistic interpretability : la science émergente qui cherche à comprendre comment les réseaux neuronaux traitent réellement l’information.
Quel est le score de votre page ? Vérifiez votre préparation au GEO avec notre outil GEO gratuit.
Pourquoi regarder dans la boîte noire ?
Parce que mesurer la sortie dit ce qui se passe, pas pourquoi.
Dans presque toutes les discussions sur la visibilité dans l’IA, nous traitons les modèles de langage comme une boîte noire.
La méthode habituelle : entrée et sortie
Nous mesurons ce qui en sort : citations, mentions, réponses. Et nous ajustons ce qui y entre : contenu, structure, message.
Cela fonctionne très bien. Vous réalisez de solides progrès sans jamais savoir ce qui se passe à l’intérieur du modèle.
Voici à quoi ressemble ce côté sortie, une réponse brute à une question sur le GEO :
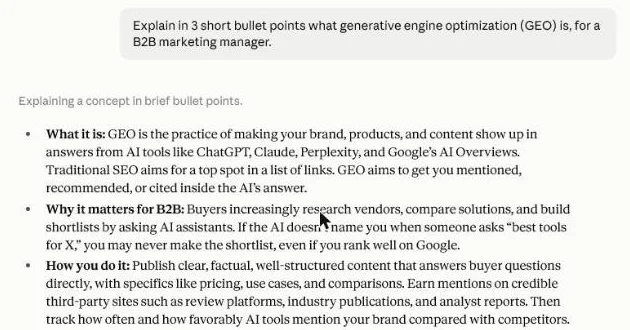 Claude, 17 octobre 2026, testé sur un plan payant en chat incognito. Une question, une réponse, et la conversation s’arrête là.
Vous voyez le texte. Vous ne voyez pas pourquoi ces trois idées, et pas d’autres.
Le niveau plus profond
L’interprétabilité ajoute un niveau de compréhension. Elle regarde les mécanismes internes qui produisent la réponse.
Ce n’est plus de la théorie.
En mai 2024, Anthropic a cartographié des millions de « features » dans Claude 3 Sonnet, un modèle en production.
Ce sont des schémas d’activation qui correspondent chacun à un concept lisible par un humain.
Pour les marques : une vue sur la façon dont un système d’IA se représente votre entreprise, vos produits et votre catégorie, et raisonne à leur sujet.
Sortie ou mécanisme : la différence en un tableau
Les deux approches répondent à des questions différentes :
| Mesure côté sortie | Interprétabilité mécaniste | |
|---|---|---|
| Question | Suis-je cité, et où ? | Pourquoi suis-je cité, ou pas ? |
| Matière | Réponses, citations, mentions | Activations, attention, circuits |
| Accès | Tout modèle, via ses réponses | Surtout des modèles open-weight |
| Effort | Faible à moyen | Élevé, expertise de recherche |
| Usage | Suivi et reporting | Diagnostic et priorisation |
Règle empirique : commencez toujours par la sortie. Le mécanisme ne vaut la peine que lorsque la sortie déçoit sans cause visible.
Ce que vous en tirez
Nous l’expliquons ici en langage humain : ce que vous voyez dans le modèle, et ce que vous pouvez en faire.
C’est une partie avancée du guide ultime du GEO, où GEO signifie generative engine optimization.
Attention aux attentes : pas de boutons à actionner dès demain. Plutôt un modèle mental qui aide à mieux choisir.
Que met au jour l’interprétabilité ?
La représentation interne de votre marque : la manière dont le modèle « pense » à vous.
Lorsqu’un LLM traite le nom de votre marque, il active des schémas spécifiques à travers son réseau.
Le nom est d’abord découpé en tokens.
En examinant ces schémas d’activation, plusieurs choses apparaissent.
Structure d’association
Quels concepts s’allument à côté de votre marque ?
Prenons une « DataFlow Platform » fictive qui entre dans le modèle. Vous pourriez voir ce profil :
- Forte activation : intégration de données, traitement en temps réel.
- Activation modérée : enterprise software, cloud.
- Quasi aucune activation : applications grand public.
Cette carte montre ce que le modèle relie vraiment à votre marque.
Pas ce que vous affirmez dans votre marketing, mais ce que le modèle a appris.
Sentiment et certitude
Les modèles portent aussi une appréciation implicite.
Votre marque active-t-elle surtout des circuits de sentiment positif ou négatif ?
Un sentiment interne fortement positif est un avantage structurel dans les contextes de recommandation. Le modèle « se sent » bien avec votre nom. Côté sortie, voyez comment suivre le sentiment des mentions de marque dans l’IA.
Vient ensuite la certitude. À quel point le modèle est-il sûr de vous ?
Si beaucoup de circuits d’incertitude s’activent, la sortie devient prudente.
« DataFlow Platform semble être… » au lieu de « DataFlow Platform est… ».
Un langage prudent de la part du modèle est donc souvent le symptôme d’une représentation interne incertaine.
Ce que dit la recherche sur la certitude
La recherche va dans ce sens.
Dans ses travaux de traçage des circuits de Claude 3.5 Haiku (mars 2025), Anthropic décrit un circuit par défaut qui refuse de répondre.
Une feature d’« entité connue » le désactive quand le modèle reconnaît un nom.
Le revers : si cette feature s’active à tort, le modèle invente des réponses avec aplomb.
C’est l’une des sources des hallucinations de l’IA.
Notre expérience : un positionnement clair vient en premier.
Si vous ne savez pas raconter votre histoire, le modèle comble le vide et commence à halluciner.
Chemins de raisonnement et sélection
Au-delà des représentations statiques, vous pouvez tracer la façon dont le modèle raisonne.
Face à une question comme « Quelle est la meilleure plateforme pour l’intégration de données en temps réel ? », le modèle parcourt grosso modo ces étapes :
- Analyser l’intention : il reconnaît une demande de recommandation.
- Activer la connaissance de la catégorie : le cluster autour de « intégration de données en temps réel » s’allume.
- Récupérer les candidats : plusieurs représentations de marques s’activent.
- Évaluer les candidats : les circuits de comparaison se déclenchent.
- Sélectionner la réponse : le candidat avec la plus haute certitude l’emporte.
- Générer la sortie : la réponse naturelle se déroule.
Visuellement, cette chaîne se rétrécit d’une question large vers une seule marque choisie.
Chaque couche filtre des candidats, et votre objectif est de vous activer le plus tôt possible :
En suivant ce parcours, vous voyez où votre marque entre dans le raisonnement. Ou justement pas.
Vous activez-vous dès l’étape 3 ? À quel point ? Et comment vous en sortez-vous dans la comparaison à l’étape 4 ?
Cela rejoint étroitement la façon dont nous décrivons l’anatomie de la sélection des sources par l’IA.
Non pas un moment unique, mais une chaîne de décisions.
Quelles techniques tournent en coulisses ?
Cinq méthodes principales. Vous n’avez pas besoin de les implémenter, mais les comprendre aide à lire les résultats.
- Analyse d’activation : quels neurones s’allument, couche par couche, pour votre marque.
- Analyse de l’attention : où le modèle « regarde » dans le contexte.
- Probing classifiers : un petit modèle teste si une propriété est encodée.
- Intervention causale : modifier les activations et observer la sortie.
- Analyse de circuits : tracer tout le chemin de l’entrée à la sortie.
Comment les lire
Activation : introduisez le nom de votre marque, enregistrez les activations, et faites-les correspondre à des concepts interprétables.
Vous voyez ainsi quelles associations logent dans votre représentation.
Attention : les modèles transformers utilisent l’attention pour déterminer où ils « regardent ».
Ses poids révèlent quels facteurs de contexte influencent le traitement de votre marque.
Probing : vous testez par exemple si « orienté enterprise » est réellement encodé dans votre représentation.
Intervention : c’est ce qui distingue la corrélation de la véritable cause.
Circuits : vous comprenez quel composant contribue à quoi.
Où se trouve votre marque dans l’espace de représentation ?
Quelque part dans l’espace d’embeddings, à côté de voisins qui trahissent vos associations.
C’est l’une des analyses les plus accessibles. Les modèles modernes représentent mots et concepts comme des vecteurs dans un espace de haute dimension. Notre article sur les embeddings l’explique pas à pas.
Bon voisinage, mauvais voisinage
Positionnement sain : votre marque se situe près de vos concurrents et des notions de catégorie.
Vous vous activez avec eux lors des questions de catégorie.
Positionnement risqué : une marque se trouve surtout dans un « espace startup », à côté de termes comme emerging ou unproven.
Elle ne s’activera peut-être pas sur les questions de catégorie. Simplement parce qu’elle n’est pas proche des bons concepts.
À retenir : c’est un problème fondamentalement différent d’un texte faible. Il appelle une autre solution.
Les attributs encodés
Vous pouvez aussi tester quels attributs sont fortement encodés.
Par exemple, vous êtes peut-être solidement connu comme orienté enterprise et capable en temps réel.
Mais faible sur la facilité d’utilisation ou l’efficacité en termes de coût.
Si un concurrent possède précisément ce dernier positionnement, vous connaissez votre écart de perception.
Le lien avec la visibilité
Ici, l’interprétabilité touche à un point que nous soulignons souvent.
La visibilité n’est pas un hasard.
C’est la conséquence de la force et de la stabilité de votre présence dans la mémoire du modèle.
Qui veut suivre cela sans plonger dans la cuisine interne du modèle peut commencer par mesurer la brand salience.
Elle pose la même question depuis le côté de la sortie.
Des outils de suivi comme Ahrefs Brand Radar mesurent eux aussi ce côté sortie, en part de voix :
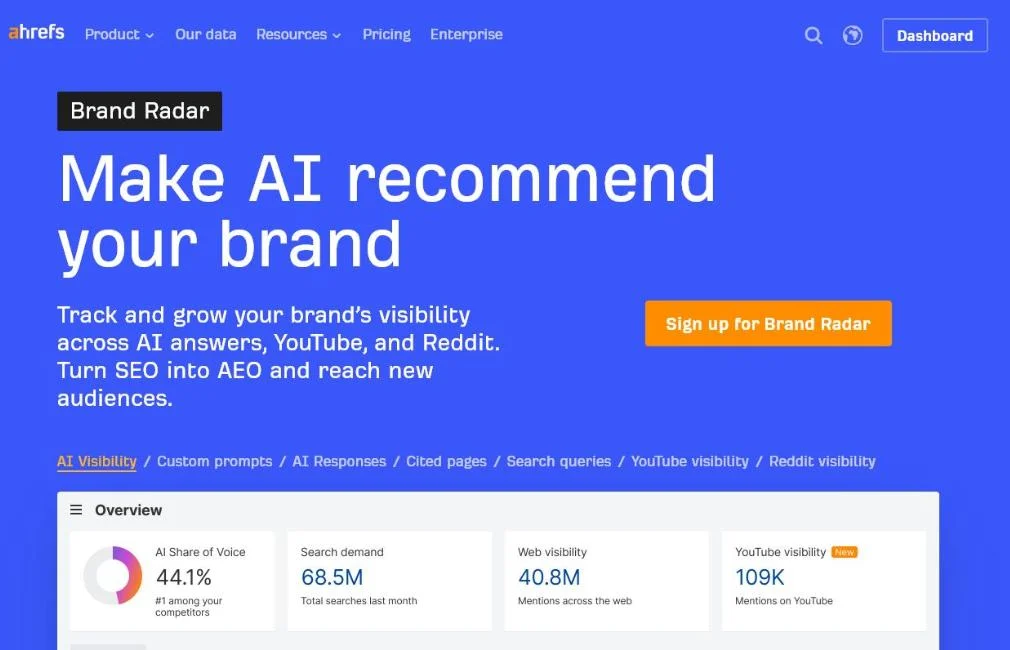 La page produit d’Ahrefs Brand Radar, octobre 2026. Le 44,1 % est un chiffre de démonstration d’Ahrefs, pas une mesure pour notre site.
Ce tableau dit combien de fois vous êtes cité. L’interprétabilité tente d’expliquer pourquoi. Voyez notre avis sur Ahrefs Brand Radar.
Comment comparer, sélectionner et intervenir ?
En lisant les circuits de comparaison, puis en intervenant pour prouver la cause.
Où vous perdez une comparaison
Face à une question directe « vous contre un concurrent », des circuits de comparaison s’activent et pèsent les attributs.
Supposons ce profil :
- Vous gagnez sur l’exhaustivité des fonctionnalités et le rapport qualité-prix.
- Vous perdez sur la présence sur le marché et la confiance dans la marque.
Supposons aussi que ces deux derniers facteurs pèsent trente pour cent dans la comparaison.
Résultat : vous savez où diriger votre énergie.
Pas de devinettes à partir de la sortie, mais une lecture directe des facteurs qui font la différence.
L’intervention comme preuve
La technique la plus puissante intervient sur les représentations internes, puis observe ce qui change.
Quelques exemples de ce qu’elle peut démontrer :
- Activation steering : renforcer une association et voir si la marque avance.
- Concept erasure : retirer un concurrent et voir si vous montez.
- Representation editing : ajouter un attribut et voir s’il change le langage.
Steering : si renforcer « orienté enterprise » fait avancer votre marque dans la réponse, vous avez démontré un lien causal entre cette association et votre position de recommandation.
Erasure : si votre marque s’active plus fortement sans le concurrent, celui-ci atténuait votre activation. Vous vous battez littéralement pour le même espace.
Editing : si le modèle vous décrit soudain comme « avant-gardiste » après l’ajout d’« innovant », le lien entre représentation interne et langage est confirmé.
L’exemple du Golden Gate Bridge
L’exemple le plus connu vient d’Anthropic.
Les chercheurs ont amplifié la feature « Golden Gate Bridge » dans Claude 3 Sonnet.
Dans sa démonstration Golden Gate Claude de mai 2024, le modèle ramenait le pont dans presque chaque réponse.
Il répondait même qu’il ressemblerait au Golden Gate Bridge. La démo publique est restée en ligne 24 heures. La preuve qu’une feature agit causalement sur la sortie.
Important : ce sont des techniques d’analyse pour comprendre, pas des boutons pour manipuler des modèles en production.
Elles montrent ce qui fonctionnerait si vous renforciez la perception sous-jacente dans le monde réel.
À quoi cela sert-il en pratique ?
À diagnostiquer, prioriser et anticiper.
Diagnostic
Si votre visibilité est plus faible que prévu, l’interprétabilité aide à en trouver la cause :
| Symptôme | Constat possible | Action |
|---|---|---|
| Faible sélection malgré un bon contenu | Signal d’autorité faible dans l’activation | Construisez de l’autorité dans les sources qui alimentent le modèle |
| Pas mentionné sur les questions de catégorie | La marque n’est pas proche des concepts de catégorie | Renforcez l’association à la catégorie dans toute votre communication |
| Mentionné, mais avec un langage prudent | Activation d’incertitude élevée | Augmentez votre présence dans des sources faisant autorité |
Pour la dernière ligne, voyez quels signaux de confiance externes l’IA reprend.
Priorisation
L’interprétabilité montre aussi quelles optimisations pèsent le plus lourd.
Si les circuits de sélection accordent plus de poids à la pertinence sémantique qu’à l’autorité, le travail sur la pertinence a plus d’impact que le netlinking.
Prédiction
Et c’est prédictif.
Si l’embedding d’un nouveau concurrent se déplace vers votre espace de catégorie, vous pouvez renforcer votre positionnement avant qu’il n’émerge vraiment.
Cette avance rejoint ce que nous décrivons à propos du primary bias.
Celui qui s’installe le premier solidement dans la mémoire du modèle bâtit un avantage durable.
Quelles sont les limites, et quel usage honnête ?
Les constats sont des approximations, pas la vérité absolue.
L’interprétabilité n’est pas parfaite. Ses constats proviennent souvent de modèles d’analyse ouverts, comme Llama ou Mistral.
Ils servent de proxy pour des modèles fermés comme GPT ou Gemini.
Et ils peuvent vieillir dès que les modèles se mettent à jour.
Traitez donc ces enseignements avec la modestie qui s’impose.
En pratique : notez toujours la version du modèle étudié et la date de l’analyse. Un constat sans date ne se compare à rien.
Même les chercheurs de pointe le reconnaissent
Anthropic indique que le traçage de circuits ne capte qu’une fraction du calcul du modèle, même sur des prompts courts.
Et comprendre un prompt de quelques dizaines de mots demande déjà quelques heures de travail humain.
La ligne éthique
Comprendre les modèles pour créer un contenu réellement meilleur, c’est une chose.
Jouer avec les modèles pour obtenir des recommandations non méritées, c’en est une autre.
L’intention fait la différence. Optimiser pour une visibilité méritée reste le point de départ.
Questions fréquentes
Ai-je besoin de l’interprétabilité mécaniste pour être visible dans l’IA ?
Non. Presque tout ce qui vous procure de la visibilité fonctionne sans que vous regardiez jamais dans un modèle. C’est une technique de pointe pour les organisations qui cherchent un avantage maximal et qui disposent en interne de l’infrastructure et de l’expertise, ou les achètent. Pour la plupart des marques, un contenu solide, une bonne structure et la construction d’autorité sont plus importants et plus réalisables.
Puis-je appliquer cela moi-même à ChatGPT ou Gemini ?
Pas directement. Les modèles fermés ne divulguent ni leurs poids ni leurs activations, les chercheurs travaillent donc avec des modèles ouverts comme proxy et valident leurs constats face à la sortie des modèles fermés. Vous acceptez donc une approximation en échange de profondeur. Les API publiques des modèles fermés ne livrent au mieux que des signaux côté sortie, comme les probabilités de tokens : une vraie analyse interne exige donc des modèles open-weight.
Quelle est la différence avec le simple fait de mesurer mes mentions dans l’IA ?
Mesurer les mentions se fait du côté de la sortie : vous voyez que vous êtes cité et dans quel contexte. L’interprétabilité regarde du côté de l’entrée du raisonnement et montre pourquoi : quelles associations, quel sentiment et quelle certitude le modèle associe en interne à votre marque. L’un vous donne le score, l’autre le mécanisme qui se cache derrière. Pour le côté score, voyez nos métriques de visibilité IA.
Quelle action concrète cela apporte-t-il à mon marketing ?
Surtout une priorisation plus fine. Au lieu de deviner quel facteur pilote votre visibilité, vous lisez s’il s’agit de pertinence, d’autorité, d’association à la catégorie ou de perception d’un attribut spécifique. Ce diagnostic oriente votre budget vers le levier qui compte vraiment, qu’il s’agisse d’un meilleur contenu, de sources plus autoritaires ou d’un positionnement de catégorie plus fort.
Besoin d’aide ?
Pas besoin d’un laboratoire pour en profiter. Commencez par mesurer ce que l’IA dit de vous aujourd’hui avec notre test de visibilité IA.
Votre prochaine étape : découvrez comment nous traduisons cela en exécution avec la visibilité dans l’IA.
100 conseils GEO pour être cité dans ChatGPT et l'IA de Google
- 10 chapitres :du robots.txt et de Bing jusqu'à la mesure
- Copier-coller :regex pour Search Console et GA4
- Modèles :questions d'achat par phase et un plan de 30 jours
Scan gratuit de votre site
Indiquez votre site et recevez en quelques minutes une analyse automatique avec des points d'amélioration techniques et SEO concrets. Sans discours commercial.
Nous utilisons vos données uniquement pour votre scan. Pas de spam, désinscription à tout moment.