
Leadgeneratie
Lead scoring modellen vergelijken: rule-based vs predictive

Kopieer voor AI
Sommige links in dit artikel zijn affiliatelinks. Kies je via zo'n link voor een tool, dan krijgen wij mogelijk een commissie. Dat kost jou niets extra en verandert niets aan onze beoordeling.
Lead scoring modellen zijn er in twee smaken: rule-based en predictive.
Het verdict: kies je model op basis van hoeveel schone, afgesloten deals je hebt, niet op wat het slimst klinkt.
Bij rule-based scoring leg je zelf de regels vast.
Bij predictive lead scoring ontdekt een algoritme de patronen in je historische deals.
Beide bepalen welke lead klaar is voor sales. Maar ze stellen heel andere eisen aan je data, je team en je geduld.
Hieronder vergelijken we beide modellen op drie assen die er echt toe doen: data, complexiteit en betrouwbaarheid.
Eerst de basis?
Wat is leadgeneratie geeft het overzicht waarin lead scoring past.
De basis van lead scoring zelf staat in een apart stuk.
Waarom heb je een lead scoring model nodig?
Zonder model is “klaar voor sales” een buikgevoel.
De ene verkoper belt te vroeg. De andere laat een warme lead koud worden.
Een scoringsmodel maakt die beslissing expliciet en herhaalbaar.
Het zet profiel en gedrag om in een getal. Boven een afgesproken drempel gaat een lead naar sales, het moment waarop een MQL een SQL wordt.
Het model is geen doel op zich
Het doel is sales-ready pipeline, niet een mooie dashboardscore.
Een model dat technisch indrukwekkend is maar door niemand vertrouwd wordt, stuurt geen enkele actie.
Daarom begint elke modelkeuze met twee vragen:
- Hoeveel bruikbare data heb je echt?
- Hoeveel deals heb je effectief afgesloten, gewonnen én verloren?
Rule-based scoring: hoe werkt het als jij de regels bepaalt?
Bij rule-based scoring ken je zelf punten toe aan kenmerken en acties.
Je werkt met twee soorten punten:
- Fit: een beslisser bij een passend bedrijf, de juiste sector, de juiste omvang.
- Gedrag: een bezoek aan de prijspagina, een aangevraagde demo, een gedownloade gids.
Tel ze op, kies een drempel, en je hebt een werkend model.
HubSpot werkt met precies die indeling: een fit-score, een engagement-score en een gecombineerde score (HubSpot).
Hoe fit en gedrag van elkaar verschillen, lees je in lead grading vs lead scoring.
Een voorbeeld van een puntentabel
Stel: je verkoopt software aan productiebedrijven en zet de drempel op 60 punten. Een eerste versie kan er bijvoorbeeld zo uitzien:
| Signaal | Type | Punten |
|---|---|---|
| Functietitel is beslisser | Fit | +20 |
| Bedrijf in je doelsector | Fit | +15 |
| Prijspagina bezocht | Gedrag | +15 |
| Demo aangevraagd | Gedrag | +30 |
| Alleen blogs gelezen | Gedrag | +5 |
| Student of concurrent | Fit | -50 |
Een beslisser uit je sector die een demo aanvraagt, haalt 65 punten en gaat naar sales.
Een student die tien blogs leest, blijft ver onder de drempel.
Tip: zet ook een plafond. HubSpot geeft zelf het voorbeeld van een totaal van 100 punten, verdeeld over groepen van 60 en 40.
Waarom transparantie de grootste kracht is
Iedereen ziet waarom een lead scoort.
Vraagt sales “waarom is dit een SQL?”, dan wijs je naar de regels: webinar bijgewoond, brochure opgevraagd, juiste functietitel.
Die uitlegbaarheid houdt sales en marketing op één lijn. De discussie gaat niet meer over een mysterieus cijfer, maar over afspraken die je samen bijstelt in een sales-marketing SLA.
Rule-based op de drie assen
Op data. Een rule-based model vraagt weinig historische data. Je hebt alleen een helder beeld van je ideale klant en een paar duidelijke koopsignalen nodig.
Je kunt vandaag starten.
Op complexiteit. Laag. Een spreadsheet of de ingebouwde scoring van je CRM volstaat om te beginnen.
Het onderhoud is handwerk: je past de regels aan naarmate je leert welke signalen tot klanten leiden.
Op betrouwbaarheid. Zo betrouwbaar als je aannames.
Het risico is dat je punten toekent op basis van wat je dénkt dat werkt, niet op basis van wat effectief tot deals leidt.
Let op: een veelgemaakte fout is enthousiasme overscoren. Iemand die al je content leest, zoals elke nieuwsbrief en elk blog, maar nooit zal tekenen, klimt in een naïef model naar de top.
Onze ervaring: we bouwden lead scoring-flows in HubSpot, ActiveCampaign en Brevo. Make en Zapier dichtten daarbij de gaten tussen automations.
Predictive scoring: hoe zoekt het algoritme het patroon?
Bij predictive scoring voed je een model met je historische data.
Het vergelijkt je gewonnen deals met je verloren kansen en leidt zelf af welke signalen voorspellend zijn.
Het weegt meer variabelen tegelijk dan een mens met de hand kan, zoals bedrijfsgrootte, bezochte pagina’s en timing samen. Soms ontdekt het verbanden die je zelf niet had bedacht.
Dat klinkt verleidelijk, en in de juiste omstandigheden is het dat ook.
Maar predictive scoring is geen knop die je omzet. Het staat of valt met de kwaliteit en hoeveelheid van je data.
Hoeveel data vraagt een predictive model?
Meer dan de meeste B2B-teams denken. Twee grote CRM’s leggen een harde ondergrens:
- HubSpot: minstens 50 contacten, waarvan 25 geconverteerd en 25 niet-geconverteerd (HubSpot).
- Microsoft Dynamics 365: minstens 40 gekwalificeerde en 40 gediskwalificeerde leads, aangemaakt en afgesloten in de trainingsperiode (Microsoft Learn).
Dat is een minimum, geen streefcijfer. Microsoft schrijft zelf dat meer leads in de training betere voorspellingen geven.
Heb je weinig deals of rommelige data, dan vindt het model toevallige correlaties die in de praktijk niets betekenen.
Predictive op de drie assen
Op data. Hoog en veeleisend. Je hebt een substantiële berg afgesloten deals nodig, gelabeld als gewonnen of verloren.
Op complexiteit. Hoog. Je hebt schone, gekoppelde data nodig over de hele keten, van eerste contact tot getekend contract.
Dat betekent een werkende koppeling tussen je marketingtools en je CRM, en iemand die het model bewaakt. Hoe je die basis legt, staat in CRM en lead management opzetten.
Op betrouwbaarheid. Potentieel hoger dan rule-based, maar alleen op schone data.
En hier zit de adder: predictive scoring op slechte data versterkt vooral je bestaande fouten.
Is je lead-to-deal data onvolledig, dan leert het model van een vertekend beeld. Het geeft je een score die overtuigend oogt, maar nergens op slaat.
De zwakke plek is ook de meest voorkomende
De meeste bedrijven kunnen hun conversie van lead naar klant niet betrouwbaar tracken.
Net dat cijfer is de brandstof van elk predictive model. Zonder lead-to-deal attributie voed je het algoritme met gaten.
Onze ervaring: de fouten die we in CRM’s het vaakst zien, zijn data die niet synchroniseert, deals die niet bijgewerkt worden en notificaties die niet werken. Juist die gaten maken een predictive model blind.
Welk lead scoring model past bij jouw situatie?
Er is geen universeel beste model. Er is een model dat past bij waar jij nu staat.
| Situatie | Kies | Waarom |
|---|---|---|
| Weinig deals, jonge of rommelige data | Rule-based | Je leert je koopsignalen en bouwt historiek op |
| Veel deals, schone gekoppelde data, iemand die het onderhoudt | Predictive (bovenop regels) | Het weegt meer signalen dan handwerk |
| Twijfel | Rule-based | Een gebruikt model wint van een slim model op drijfzand |
Weinig deals of rommelige data?
Begin rule-based.
Je leert je eigen koopsignalen kennen en bouwt ondertussen de schone datahistoriek op die je later nodig hebt.
Een simpel model dat je team gebruikt, verslaat een geavanceerd model dat op drijfzand draait.
Veel deals en schone data?
Dan kan predictive scoring scherper sturen dan handwerk ooit kan.
Zie het wel als een verfijning bovenop een werkend fundament, niet als een vervanging van nadenken.
Twijfel je?
Dan is het antwoord bijna altijd rule-based starten.
Ook Google’s regels voor machine learning beginnen daar: is machine learning niet strikt nodig, gebruik het dan niet tot je de data hebt.
De meeste B2B’ers hebben meer baat bij een helder, gebruikt model dan bij een tool die belooft het denken over te nemen.
Het hybride pad
Veel teams kiezen uiteindelijk een hybride.
Een rule-based skelet zorgt voor uitlegbaarheid. Een predictieve laag komt erbij zodra de data het draagt.
Zo behoud je het vertrouwen van sales en win je geleidelijk aan scherpte:
Wil je ook op accountniveau scoren, lees dan account scoring met fit en intent.
Waar komt het bij lead scoring echt op aan?
Beide modellen falen op dezelfde manier: slechte data.
Een score, uit regels of uit een algoritme, is maar zo goed als de gegevens eronder.
Investeer daarom eerst in kwalitatieve leads en in een betrouwbare meting van wat een lead na de overdracht doet.
Die overdracht vraagt eigen afspraken, zie lead overdracht van marketing naar sales.
In HubSpot volg je dat pad met lifecycle stages. Kijk vooral naar de definities van MQL en SQL in deze lijst:
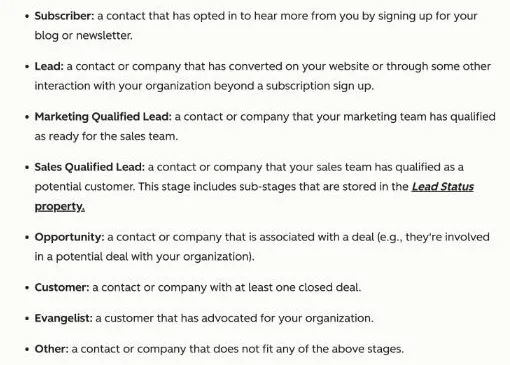 De lifecycle stages in de HubSpot Knowledge Base, schermafbeelding oktober 2026. Je scoringsdrempel bepaalt wanneer een lead van MQL naar SQL schuift.
Elke fase is een meetpunt. Zie lead lifecycle fasen voor de volledige reeks.
Lees ook leads opvolgen, want een goed gescoorde lead kan alsnog blijven liggen.
Stuur op de juiste metric
Stuur niet op het aantal leads boven de drempel.
Stuur op cost per qualified lead en uiteindelijk op lead-to-deal: hoeveel van je gescoorde leads worden klant?
Dat is het enige cijfer dat over beide modellen heen eerlijk toont of je scoring werkt of alleen mooi oogt.
Hoe gaat een model naar pipeline?
Lead scoring is geen losstaand trucje.
Het is de schakel waarmee leadgeneratie de capture-laag wordt van een georkestreerde groeimachine.
Alleen als de juiste leads op het juiste moment bij sales landen, vertaalt aandacht zich in omzet.
Daar sturen we op wanneer we voor je meer leads genereren: pipeline die je salesteam kan sluiten, met attributie van lead tot deal.
Wat dat in de praktijk oplevert
Bij de trajecten die we uitrollen, zien we vaak een verdubbeling tot verdrievoudiging van het aantal aanvragen.
Zo leverde onze aanpak voor Get Driven een vier keer hogere conversieratio op.
De conversieratio steeg van 1,8% naar 7,3%.
Welk model past bij jouw data?
Vertel ons hoeveel deals je hebt afgesloten en hoe je nu leads doorgeeft.
We helpen je kiezen tussen een rule-based start en een predictieve uitbouw, zonder je iets aan te praten wat je data nog niet draagt.
We zijn een klein team, dus we bewegen snel. Neem contact op en je hoort binnen 24 uur waar je kansen liggen.
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.