
SEO & GEO
Je GEO-optimalisatiepijplijn bouwen: van audit naar continue verbetering

Kopieer voor AI
Een GEO-optimalisatiepijplijn maakt van losse ingrepen een herhaalbaar, deels geautomatiseerd systeem.
Je oogst query’s, genereert snippets, simuleert de selectie, beoordeelt en herschrijft. Daarna begint de lus opnieuw.
Het verdict: handwerk werkt, maar het schaalt niet. Wie honderden pagina’s zichtbaar wil maken in AI-antwoorden, moet een pijplijn bouwen die test op machinetempo.
GEO staat voor Generative Engine Optimization: optimaliseren voor generatieve zoekmachines zoals AI Mode, AI Overviews en ChatGPT. In die oorspronkelijke paper stellen de auteurs dat GEO de zichtbaarheid in generatieve antwoorden tot 40% kan verhogen.
Een pijplijn laat je honderden snippetvarianten testen voordat je er één publiceert.
De iteratie gebeurt op machinetempo, niet op het ritme van redactionele cycli.
Dit is het uitvoeringsdeel van de ultieme GEO-handleiding: het moment waarop strategie infrastructuur wordt. Is GEO nog nieuw voor je, begin dan bij wat GEO is.
Direct toepassen: laat onze GEO-check zien welke AI-signalen je pagina mist.
Waarom een pijplijn en geen losse ingrepen?
Handmatige optimalisatie werkt prima, maar ze is traag en oncontroleerbaar.
Waarom ik met handwerk stopte
Toen ik begon met optimaliseren voor AI-zoekmachines, deed ik het zoals iedereen: pagina voor pagina, met de hand.
Ik herschreef een passage, publiceerde, en wachtte tot de AI-systemen de wijziging oppikten. Dan keek ik of mijn content vaker geciteerd werd.
Dat duurde weken per iteratie. En het schaalde voor geen meter.
Met honderden pagina’s en tientallen relevante query’s per pagina kom je met handwerk nooit rond.
Drie redenen waarom je naar een systeem moet:
- Snelheid van feedback: minuten in plaats van weken.
- Schaal: veel sterke passages over veel query’s.
- Reproduceerbaarheid: je weet wat je veranderde en wat het deed.
Snelheid van feedback
Wachten op echte AI-systemen betekent publiceren, wachten op crawling en herverwerking, en dan pas resultaat zien.
Dat is een feedbacklus van weken.
Een pijplijn met simulatie geeft je feedback in minuten.
Schaal
Eén perfecte passage volstaat niet. AI breekt elke vraag op in deelvragen, de query fan-out die Google beschrijft als “multiple related searches across subtopics and data sources”.
Je hebt dus veel sterke passages nodig over veel query’s. Hoe je die deelvragen indeelt, lees je in query fan-out en intentclassificatie.
Dat is alleen haalbaar als je het werk systematiseert.
Reproduceerbaarheid
Een pijplijn legt vast wat je veranderde, waarom, en wat het effect was.
Zonder die registratie optimaliseer je in het donker.
Je leert nooit wat werkt.
Kort gezegd: losse ingrepen zijn ambacht, een pijplijn is een fabriek. Voor AI-zichtbaarheid heb je de fabriek nodig.
De optimalisatielus in vijf stappen
De motor van de hele pijplijn is een lus.
Ik doorloop hem als een genummerd proces, want de volgorde is wat hem laat werken.
In beeld draait die lus rond: elke ronde voedt de volgende, met de selectiesimulatie als scharnier.
Stap 1: oogst de query’s
Begin met je seed-onderwerpen en entiteiten. Waaier uit naar verwante query’s, vraagvarianten en verschillende intenties.
Dit levert het querycorpus op waartegen je test.
Hoe completer dit corpus, hoe representatiever de rest van de pijplijn.
Stap 2: genereer snippetvarianten
Voor elke query maak je meerdere kandidaatpassages: synthetische varianten die je tegen elkaar en tegen concurrenten uitspeelt.
Hier begint het testen, nog vóór er iets live staat. Hoe je passages zo afbakent dat AI ze los kan gebruiken, staat in content chunking voor AI-zoekmachines.
Stap 3: simuleer de selectie
Leg de query en de kandidaatsnippets voor aan een taalmodel dat de rol van keuzejury speelt.
De vraag is eenvoudig: “Hier zijn de kandidaten, welke zou jij kiezen voor je antwoord?” Het model voorspelt zo het echte selectiegedrag.
Stap 4: beoordeel het resultaat
Het jurymodel geeft niet alleen een keuze, maar ook een motivering.
Die redenering vertelt je waarom een concurrent voorging, bijvoorbeeld door relevantie, informatiedichtheid, extraheerbaarheid of unieke waarde.
Stap 5: herschrijf en herhaal
Verwerk de motivering in een betere versie van je snippet. Draai de simulatie opnieuw, en herhaal tot jouw passage consistent wint.
Pas dan publiceer je.
Deze lus is het hart van wat ik Selection Rate Optimization noem. Het verschil met handwerk: elke ronde duurt minuten, omdat je lokaal test in plaats van te wachten op productiesystemen.
De modules van een volwassen pijplijn
Rond die lus bouw je infrastructuur.
Een volwassen pijplijn bestaat uit zes modules die elk een punt in de keten bedienen.
Zo ziet de opbouw eruit:
| Module | Wat ze oplevert |
|---|---|
| Querygeneratie | het querycorpus |
| Responscaptuur | de ruwe AI-antwoorden |
| Citatieanalyse | je selectieratio tegenover concurrenten |
| Snippetvergelijking | de concrete gaten in je content |
| Optimalisatie-workflow | geregistreerde wijzigingen op schaal |
| Rapportage en alerting | een bestuurbaar programma |
Querygeneratie-module
Deze module genereert automatisch queryvariaties. Je start met seed-onderwerpen en entiteiten, en waaiert uit naar verwante query’s en vraagvarianten.
Het resultaat is het querycorpus dat de rest van de pijplijn voedt.
Let op: weerspiegelt je corpus de echte vragen van je doelgroep niet, dan optimaliseer je voor de verkeerde dingen.
Responscaptuur-module
Hier bevraag je de AI-systemen geautomatiseerd.
Je dient query’s in over meerdere platformen en vangt de volledige responsen op.
Daarna haal je de citaten en snippets eruit die je nodig hebt. Zo ziet één opgevangen respons eruit:
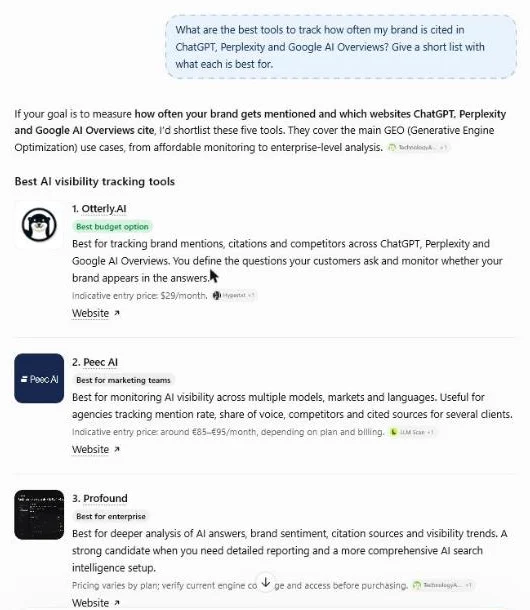 Onze eigen ChatGPT-test van 17 oktober 2026. Naam, volgorde en label gaan elk in een eigen kolom.
Dat is de datafundering van je meting.
Eén platform volstaat niet: AI Mode, AI Overviews en de chatassistenten gedragen zich allemaal anders. Die verschillen meet je met cross-model-analyse.
Citatieanalyse-module
Deze module verwerkt de opgevangen responsen. Ze identificeert alle geciteerde bronnen en koppelt citaten aan je eigen domeinen.
Daarna berekent ze je selectieratio’s en volgt ze je positie tegenover concurrenten. Bij Perplexity zie je de bronnen achter één antwoord in één paneel:
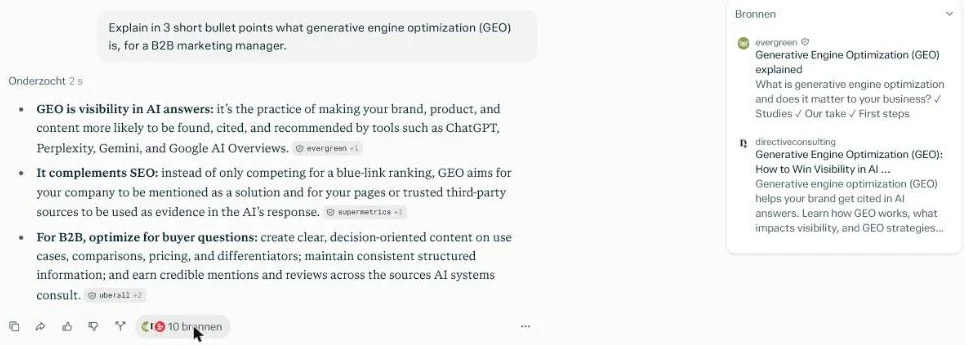 De 10 bronnen achter het antwoord van Perplexity, één klik vanaf de voettekst, oktober 2026.
Dit is de meetlat die je optimalisatie stuurt.
De details vind je in citation mining.
Snippetvergelijking-module
Hier vergelijk je je passages met die van concurrenten. Je extraheert de winnende snippets, identificeert de gaten en scoort je competitieve positie.
Deze module legt concrete kansen bloot.
Niet “doe het beter”, maar “hier mis je informatiedichtheid tegenover deze concurrent”.
Hoe je die vergelijking opzet, staat in concurrenten benchmarken in AI-zoekresultaten.
Optimalisatie-workflow
Dit operationaliseert de verbetering op schaal. Je prioriteert pagina’s op hun kans en past optimalisatietemplates toe.
Je registreert welke wijzigingen je doorvoerde, en koppelt alles terug aan de meting.
Zonder die terugkoppeling weet je nooit of je ingreep effect had.
Rapportage en alerting
De laatste module geeft zicht op de hele pijplijn: een dashboard, trendvisualisatie, alerts bij competitieve verschuivingen en detectie van afwijkingen.
Dit maakt van losse modules een bestuurbaar programma. Een tool zoals Ahrefs Brand Radar toont bijvoorbeeld je aandeel naast concurrenten:
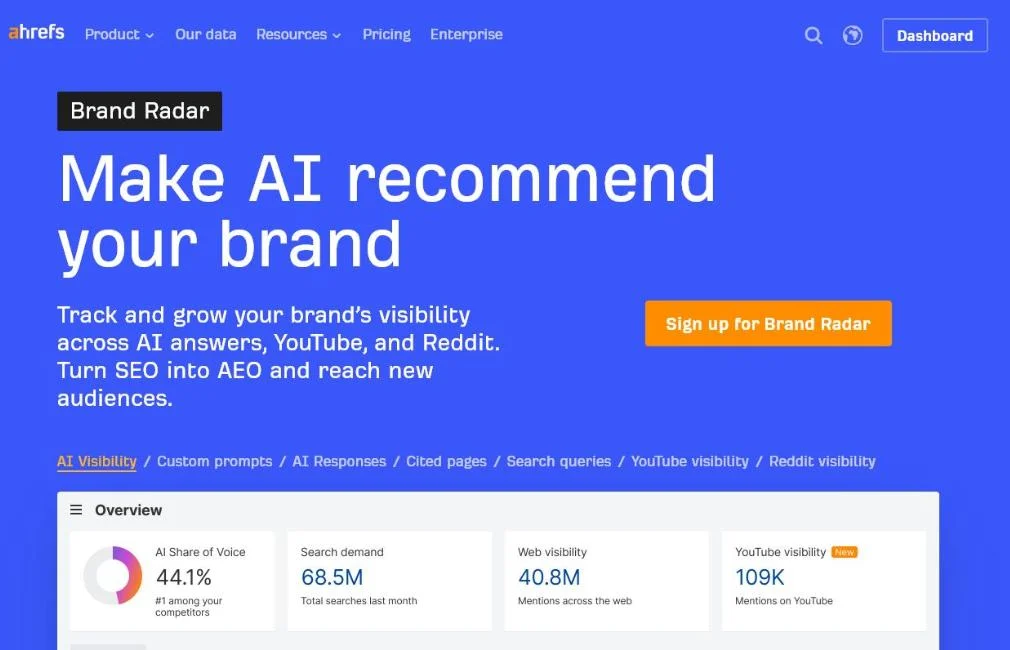 De productpagina van Ahrefs Brand Radar, oktober 2026: je aandeel in AI-antwoorden naast concurrenten.
Wil je het dashboard zelf bouwen, lees dan een GEO-dashboard bouwen en AI share of voice meten.
Selectie simuleren zonder te publiceren
De krachtigste techniek in de pijplijn is de selectiesimulatie.
In plaats van te wachten tot echte AI-systemen je content beoordelen, simuleer je dat proces lokaal.
Zo werkt het
Vijf stappen, in deze volgorde:
- Verzamel je huidige snippets en die van concurrenten.
- Leg ze voor aan een taalmodel dat als keuzejury optreedt.
- Vraag: “Gegeven deze query en deze kandidaatsnippets, welke zou je kiezen?”
- Registreer de keuze én de motivering.
- Itereer op je snippets tot ze consistent winnen.
De jury-prompt is het scharnierpunt
Je laat het model expliciet redeneren over vier dingen:
- directe relevantie;
- informatiekwaliteit en -dichtheid;
- extraheerbaarheid en helderheid;
- unieke waarde.
De keuze plus de motivering laten precies zien wat werkt en wat niet. Hoe echte systemen die afweging maken, lees je in de anatomie van AI-bronselectie.
Kalibreer tegen echte data
Vergelijk daarom de voorspellingen van je simulatie met de echte uitkomsten in je citatiedata.
Stel je prompting en methode bij naarmate je leert hoe accuraat de voorspellingen zijn. Hoe meer je kalibreert, hoe betrouwbaarder de simulatie als kompas.
Houd er ook rekening mee dat AI-antwoorden per keer verschillen. Waarom dat zo is, staat in de probabilistische aard van AI-antwoorden.
De pijplijn laten schalen
Voor organisaties met veel content moet de pijplijn schalen.
Drie zaken maken dat mogelijk.
Prioritering
Niet elke pagina verdient intensieve optimalisatie. Ik scoor pagina’s op vier dimensies om een prioriteitswachtrij op te bouwen:
| Dimensie | Vraag die je stelt |
|---|---|
| Businesswaarde | Welke pagina’s bedienen waardevolle query’s of stuwen omzet? |
| Verbeterpotentieel | Welke pagina’s hebben een lage selectieratio maar hoge kwaliteitspotentie? |
| Competitieve kwetsbaarheid | Waar dreigen concurrenten je te verdringen? |
| Benodigde inspanning | Welke ingrepen geven het beste rendement op tijd? |
Vuistregel: begin bij pagina’s met hoge businesswaarde en een lage selectieratio. Daar levert elke ronde het meest op.
Templates
Voor grote contentsets ontwikkel je optimalisatietemplates.
Neem een definitietemplate voor “Wat is X?”-query’s. Voeg een H2 “Wat is [X]?” toe, en open met “[X] is [heldere definitie]. [Kernkenmerken]. [Concreet voorbeeld].”
Een vergelijkingstemplate voor “X versus Y”-query’s werkt analoog.
Templates geven consistente optimalisatie over veel pagina’s, zonder dat je elke pagina apart analyseert.
Automatisering
Delen van het werk laat je over aan machines:
- querygeneratie uit seed-onderwerpen;
- responscaptuur over platformen;
- citaatextractie en -analyse;
- berekening van de selectieratio;
- competitieve benchmarking.
De automatisering neemt het repetitieve datawerk over.
Zo komt menselijke inzet vrij voor strategische analyse en creatieve optimalisatie.
Hoe je begint: de eerste pijplijn
Je hoeft niet op dag één een volledige fabriek te bouwen. Zo zou ik het opbouwen, in vier stappen.
Stap 1: start met een audit
Voordat je optimaliseert, moet je weten waar je staat. Breng in kaart welke query’s je doelgroep stelt, en waar je nu wel en niet geciteerd wordt.
Dat is precies wat de complete GEO-audit oplevert: het vertrekpunt van je pijplijn.
Controleer ook of de AI-bots je content überhaupt kunnen bereiken. OpenAI schrijft bijvoorbeeld dat sites die OAI-SearchBot blokkeren, niet getoond worden in de zoekantwoorden van ChatGPT, en dat een wijziging in robots.txt ongeveer 24 uur nodig heeft.
Stap 2: bouw de meetlaag eerst
Begin met responscaptuur en citatieanalyse.
Zonder meting optimaliseer je blind, dus dit komt vóór elke optimalisatie.
Stap 3: voeg de simulatielus toe
Eens je meet, zet je de vijf-stappenlus op met een jurymodel.
Hier begin je echt snippets te verbeteren vóór publicatie.
Stap 4: schaal met prioritering en templates
Pas als de lus draait, breid je uit naar veel pagina’s.
Je gebruikt dan een prioriteitswachtrij en herbruikbare templates.
Behandel het als infrastructuur
Het geheel is doorlopende infrastructuur, geen project met een einddatum.
AI-modellen veranderen zonder aankondiging en je concurrenten optimaliseren mee.
Wat vandaag wint, kan volgende maand verliezen.
Beslisregel: blijft je pijplijn meten en itereren, dan blijf je zichtbaar terwijl het landschap verschuift.
Veelgestelde vragen
Wat is het verschil tussen een GEO-optimalisatiepijplijn en gewone SEO?
Een GEO-pijplijn optimaliseert voor selectie binnen AI-antwoorden, niet voor positie in een lijst met blauwe links. Waar klassieke SEO mikt op een hogere ranking, mikt de pijplijn op de vraag: wordt mijn content gekozen wanneer ze is opgehaald? Technische SEO blijft een voorwaarde, maar de optimalisatie-eenheid verschuift van de pagina naar de individuele snippet.
Heb ik dure tools nodig om een pijplijn te starten?
Niet om te beginnen. De simulatielus draait in essentie op een taalmodel dat als keuzejury optreedt, en de eerste meting kun je deels handmatig opzetten. Naarmate je schaalt loont automatisering en gespecialiseerde tooling, maar de waarde zit in het systeem en het proces, niet in een specifiek stuk software.
Hoe betrouwbaar is selectiesimulatie eigenlijk?
Simulatie is richtinggevend, geen perfecte voorspelling, want het jurymodel verschilt van de echte productiesystemen. De waarde zit in de snelheid: je krijgt feedback in minuten in plaats van weken. Door je voorspellingen te kalibreren tegen echte citatiedata wordt de simulatie na verloop van tijd een steeds betrouwbaarder kompas.
Voor wie is dit de moeite waard?
Voor elke organisatie die op schaal zichtbaar wil zijn in AI-zoekopdrachten. Heb je maar een handvol pagina’s, dan volstaat handmatig werk wellicht. Maar zodra je tientallen of honderden pagina’s hebt met elk meerdere relevante query’s, is een pijplijn de enige manier om systematisch en herhaalbaar te optimaliseren in plaats van eindeloos achter de feiten aan te lopen.
Hulp nodig?
Wil je dit vertalen naar uitvoering? Bekijk hoe we de pijplijn voor je opzetten met AI-vindbaarheid, van audit tot meetlaag.
100 GEO-tips om genoemd te worden in ChatGPT en Google AI
- 10 hoofdstukken:van robots.txt en Bing tot meten
- Copy-paste:regex voor Search Console en GA4
- Sjablonen:koopvragen per fase en een 30-dagenplan
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.