
SEO & GEO
Wat is een contextvenster (context window)?
 Tanguy De Keyzer Oprichter & digitale strateeg · Bijgewerkt 20 november 2026 · ◷ 10 min leestijd
Kopieer voor AI
Een contextvenster is de hoeveelheid tekst die een AI-model tegelijk kan “zien”.
In het Engels heet dat de context window. Alles wat erin past, kan het model meewegen terwijl het een antwoord opbouwt.
Alles wat er net buiten valt, bestaat op dat moment niet voor het model.
Het verdict: een groter venster is geen beter geheugen. Wil je geciteerd worden, zet je antwoord dan vooraan en maak het zelfstandig leesbaar.
Hieronder: hoe een contextvenster werkt, waarom groot niet hetzelfde is als betrouwbaar, en wat het betekent voor je AI-zichtbaarheid.
Wat is een contextvenster (context window) precies?
Een contextvenster is het werkgeheugen van een AI-model: alle tekst die het in één keer vasthoudt om een antwoord te genereren.
Anthropic omschrijft de context window als alle tekst waar een taalmodel naar kan verwijzen tijdens het antwoorden, het antwoord zelf inbegrepen.
Dat is iets anders dan de enorme hoeveelheid data waarop het model getraind is.
Wat er allemaal in zit
Daar zit alles in wat op dat moment relevant is:
- de vraag van de gebruiker
- de eerdere berichten in het gesprek
- eventuele instructies
- bij AI-zoekmachines: de stukken brontekst die het systeem van het web haalde
Die laatste is voor jou het belangrijkste. Daar moet jouw content in terechtkomen.
Gemeten in tokens
De grootte wordt gemeten in tokens. Een token is een stukje tekst, vaak een woord of een deel van een woord.
Vuistregel: een token komt grofweg overeen met ongeveer vier tekens. Dat is de regel die Google geeft voor zijn Gemini-modellen. De korte definitie staat in onze wiki over het token.
Een contextvenster van honderdduizenden tokens klinkt abstract.
Het komt neer op honderden pagina’s tekst die het model in theorie tegelijk kan overzien.
Tijdelijk, niet permanent
Het sleutelwoord is tegelijk. Het contextvenster is geen permanent geheugen.
Het is een tijdelijke ruimte die telkens opnieuw gevuld wordt voor één antwoord.
Wat er niet in past, of wat in een vorig gesprek stond, weet het model niet meer.
Bijvoorbeeld: wat je in een vorig gesprek vertelde, zit niet vanzelf in het venster van een nieuw gesprek.
Tenzij de tool het er zelf opnieuw in zet, zoals een geheugenfunctie.
Waarom heeft een model een limiet?
Omdat het verwerken van context rekenkracht kost, en die loopt snel op naarmate de tekst langer wordt.
Hoe meer tokens een model in één keer moet afwegen, hoe meer geheugen en rekentijd elk antwoord vraagt.
Een venster is dus altijd een afweging tussen hoeveel je wil meegeven en wat technisch en financieel haalbaar blijft.
Hoe snel de vensters gegroeid zijn
De afgelopen jaren zijn die vensters spectaculair gegroeid. Google beschrijft het verloop in zijn documentatie over lange context:
Vroegere generatieve modellen verwerkten volgens Google maar 8.000 tokens tegelijk. Later werd dat 32.000 of zelfs 128.000.
Vandaag werken de grootste modellen met 1 miljoen tokens.
Google vertaalt dat naar ongeveer 8 Engelstalige romans van gemiddelde lengte, of 50.000 regels code.
Bij Anthropic hebben de nieuwste Claude-modellen ook een venster van 1 miljoen tokens. Andere Claude-modellen werken met 200.000 tokens.
Op een rij, met de cijfers uit de documentatie van Google en Anthropic:
| Model | Contextvenster | Bron |
|---|---|---|
| Vroegere generatieve modellen | 8.000 tokens | |
| Latere modellen | 32.000 tot 128.000 tokens | |
| Andere Claude-modellen | 200.000 tokens | Anthropic |
| Nieuwste Claude-modellen | 1 miljoen tokens | Anthropic |
| Huidige Gemini-modellen | 1 miljoen tokens, ongeveer 8 romans of 50.000 regels code |
Groter opent nieuwe toepassingen
De trend is duidelijk: vensters worden groter.
Dat opent de deur voor toepassingen die hele documenten of lange gesprekken in één keer verwerken.
Maar groter is niet vanzelf beter. Juist daar zit het verhaal dat voor jou als marketeer telt.
Waarom is een groot venster niet hetzelfde als een goed geheugen?
Een groot contextvenster zegt hoeveel een model kan inladen, niet hoe betrouwbaar het alles daarvan gebruikt.
Dat onderscheid wordt vaak vergeten.
Verloren in het midden
Onderzoek naar lange contexten laat zien dat modellen het best presteren op informatie vooraan of achteraan in de tekst.
Details die diep in het midden van een lange tekst verstopt zitten, zien ze makkelijker over het hoofd.
Dat heet het “verloren in het midden” effect.
Schematisch ziet dat patroon er zo uit:
Het geadverteerde venster tegenover de effectieve context
Er is een verschil tussen het geadverteerde venster en wat een model echt gebruikt.
Een model kan honderden pagina’s inladen en toch een cruciaal feit missen dat halverwege begraven ligt.
Anthropic noemt dat in zijn eigen documentatie context rot: naarmate het aantal tokens groeit, nemen nauwkeurigheid en herinnering af.
De passage staat bovenaan de documentatiepagina over het contextvenster:
Hoe voller je het venster propt, hoe groter de kans dat een specifiek detail wegvalt in de ruis.
Wat dit niet betekent
Dit is geen reden om grote vensters te wantrouwen. Het is een reden om te begrijpen hoe ze zich gedragen.
En het heeft directe gevolgen voor hoe je schrijft als je gevonden wil worden.
Wat betekent het contextvenster voor je AI-zichtbaarheid?
Zet je belangrijkste antwoord vooraan en maak het zelfstandig leesbaar. Een AI-model weegt je hele pagina lang niet altijd even zwaar.
Je pagina deelt het venster met andere bronnen
Vraagt iemand iets aan ChatGPT, Perplexity of Google AI Overviews? Dan haalt het systeem doorgaans relevante stukken van het web op.
Die komen samen in het contextvenster, naast de stukken van andere bronnen.
Je ziet dat goed in Perplexity. Bij één vraag over GEO stonden er 10 bronnen achter het antwoord:
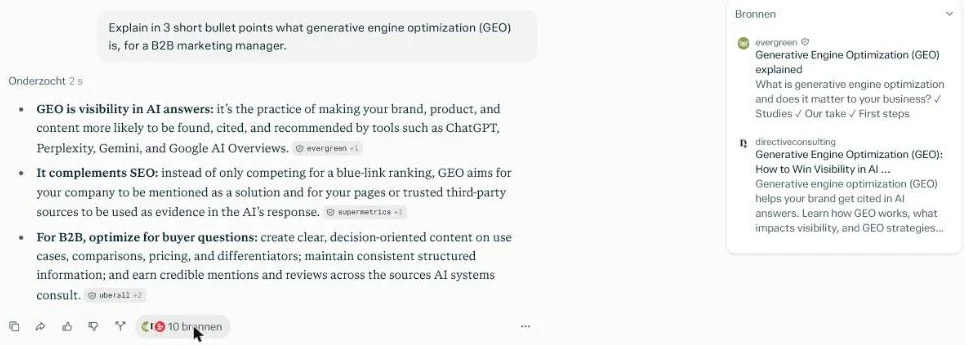 De 10 bronnen achter een antwoord van Perplexity, één klik vanaf de voettekst, oktober 2026.
Jouw pagina concurreert dus om ruimte en aandacht met al die andere pagina’s.
Hoe een systeem die bronnen kiest, lees je in de anatomie van AI-bronselectie.
Een antwoord in de laatste alinea loopt risico
Een lange pagina waarbij het echte antwoord pas in de laatste alinea valt, kan genegeerd worden.
Zelfs als dat antwoord uitstekend is.
Het stuk dat wordt opgehaald, is misschien net niet het stuk met jouw kernpunt.
Content die vooraan een compleet, citeerbaar antwoord geeft, heeft een veel grotere kans om in het AI-antwoord te belanden.
Hoe dat ophalen technisch werkt, staat in wat RAG is voor marketeers.
Vier schrijfregels die volgen uit het contextvenster
Concreet betekent dat het volgende voor je content:
Zet het antwoord bovenaan. Begin elke sectie met een volledige, op zichzelf staande zin die de vraag beantwoordt. Bouw de nuance daarna op.
Schrijf in zelfstandige brokken. Verdeel een lang onderwerp in secties die elk één vraag volledig beantwoorden, met een duidelijke kop erboven.
Een brok die in zijn eentje begrijpelijk is, overleeft het beter als hij los uit je pagina wordt geplukt.
Meer daarover in content chunking voor AI-zoekmachines.
Vermijd dat de kern in het midden verdwijnt. Verstop je sterkste argument of belangrijkste cijfer niet halverwege een muur van tekst.
Wees compact waar het kan. Het venster wordt gedeeld met andere bronnen. Een scherp geformuleerd antwoord neemt minder ruimte in en is makkelijker mee te nemen.
Een voorbeeld
Stel: je schrijft een pagina over de kosten van een CRM-implementatie.
Staat de prijsvork pas onderaan na vijf alinea’s context? Dan is de kans kleiner dat net dat stuk wordt opgehaald.
Staat ze in de eerste zin onder de kop “Wat kost een CRM-implementatie?”, dan heeft elk opgehaald stuk het antwoord.
Zo kijken wij naar content
Deze aanpak sluit aan op hoe wij bij Customer Impact naar content kijken.
Niet schrijven om een venster vol te krijgen, maar zo structureren dat het citeerbare antwoord altijd vindbaar is.
Hoe je pagina’s zo opbouwt dat AI ze makkelijk uitleest, behandelen we in content-architectuur voor AI-extractie.
Concrete schrijftips, zoals een antwoord in de eerste zin, staan in content schrijven die AI citeert.
Hoe past dit in het grotere AI-zoekplaatje?
Het contextvenster is één schakel in een keten.
Het bepaalt hoeveel tekst een model tegelijk verwerkt. Of jouw content in dat venster terechtkomt, hangt af van andere mechanismes:
- Grounding: hoe een AI bepaalt welke bronnen het ophaalt en vertrouwt, lees je in grounding.
- Embeddings: hoe content en vragen op betekenis worden gematcht, staat in ons stuk over embeddings.
- Het model: wat een taalmodel precies doet, lees je in wat een LLM is voor marketeers.
Het bredere kader van zichtbaar worden in AI vind je in onze complete gids over generative engine optimization.
Ook in gesprekken telt het venster
In een chatgesprek vult elke beurt het venster verder.
Daarom houdt een assistent lang de draad vast, tot het venster vol raakt.
Hoe zulke gesprekken werken, staat in wat conversational AI is.
Van inzicht naar AI-vermeldingen
Wil je dit vertaald zien naar acties die leiden tot AI-vermeldingen, en uiteindelijk naar leads en omzet?
Dat is het werk van onze GEO-dienst voor AI-zoekmachines.
Daar zorgen we dat je content op de juiste plek staat om gekozen te worden.
Veelgestelde vragen
Hoe groot is een contextvenster?
Dat verschilt per model. Google meldt dat vroegere modellen 8.000 tokens verwerkten en huidige Gemini-modellen 1 miljoen. Bij Anthropic hebben de nieuwste Claude-modellen ook 1 miljoen tokens, andere 200.000.
Onthoudt een AI-model mijn vorige gesprekken?
Niet vanzelf. Het venster wordt per antwoord opnieuw gevuld. Sommige tools zetten opgeslagen info er telkens opnieuw in, maar wat niet in het venster staat, weet het model op dat moment niet.
Moet ik mijn pagina’s korter maken voor AI?
Niet per se korter, wel beter gestructureerd. Zet het antwoord vooraan in elke sectie, zodat elk opgehaald stuk op zichzelf klopt.
De korte samenvatting
Een contextvenster is de maximale hoeveelheid tekst, gemeten in tokens, die een AI-model tegelijk verwerkt voor één antwoord.
Die vensters zijn enorm gegroeid. Maar informatie die diep in een lange tekst verstopt zit, valt makkelijk weg.
De les: zet je belangrijkste antwoord vooraan, schrijf in zelfstandige brokken en begraaf je kernpunten niet in het midden.
Wil je weten hoe goed AI-zoekmachines jouw content vandaag oppikken?
Test het met onze AI-zichtbaarheidscheck, of neem contact op en we kijken samen waar je kansen liggen.
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.