
SEO & GEO
Wat is een recommendation engine? Uitleg voor B2B

Kopieer voor AI
Een recommendation engine is een AI-systeem dat voorspelt welke items jou interesseren.
In het Nederlands heet het een aanbevelingssysteem. Het stelt die items vervolgens voor.
Het is de technologie achter de “voor jou aanbevolen” secties van Netflix, Amazon en Spotify.
Het verdict: een recommendation engine loont bij veel gebruikers en veel items. Voor de meeste B2B-sites is een slimme handmatige structuur effectiever.
Wat is een recommendation engine precies?
Een systeem dat items voorstelt op basis van data over gedrag en voorkeuren.
Volgens IBM is een recommendation engine een AI-systeem dat items voorstelt aan een gebruiker.
Het analyseert data over gedrag en voorkeuren, herkent patronen en zet die om in gerichte suggesties.
Het doel
Het doel is telkens hetzelfde: de gebruiker sneller bij iets relevants brengen.
Zo realiseer je meer engagement of omzet.
Machine learning onder de motorkap
Onder de motorkap draait zo’n systeem op machine learning.
Het leert uit voorbeelden welke items samengaan met welk gedrag. Het verfijnt zijn voorspellingen naarmate er meer data binnenkomt.
Hoe meer betrouwbare data, hoe scherper de aanbevelingen. Een korte definitie van de techniek vind je in de wiki over machine learning.
Hoe groot het effect kan zijn
Bij de grote spelers is het effect enorm. IBM haalt twee bekende cijfers aan:
- Amazon: 35% van de aankopen komt uit aanbevelingen, volgens McKinsey.
- Netflix: 80% van wat er bekeken wordt, komt uit aanbevelingen.
Netflix schat dat het daarmee jaarlijks meer dan 1 miljard dollar bespaart.
Let op: die cijfers komen van platformen met miljoenen gebruikers.
Voor een kleine B2B-site zeggen ze weinig.
Ook in marketing een thema
IBM noemt marketing expliciet als toepassing: content aanbevelen om prospects aan te trekken.
Het verwijst naar McKinsey, dat personalisatie koppelt aan 5 tot 15% meer omzet en 10 tot 15% meer verkoopconversies.
De markt groeit mee. IBM schat de markt voor recommendation engines op 6,88 miljard dollar in 2024, met een verdrievoudiging binnen vijf jaar.
Hoe werkt een recommendation engine?
Met twee klassieke aanpakken, of een combinatie van beide.
Ze verschillen vooral in de vraag die ze stellen om iets aan te bevelen.
Collaborative filtering
Het systeem beveelt items aan op basis van wat gelijkaardige gebruikers deden.
De logica: mensen die op jou lijken, vonden dit interessant, dus jij misschien ook.
IBM beschrijft dit als groeperen op gedrag. Zo werkt “klanten die dit kochten, kochten ook” bij Amazon.
Sterk als: je veel gebruikers hebt die overlappend gedrag vertonen.
Zwak punt: een nieuwe gebruiker zonder geschiedenis valt buiten de boot.
Content-based filtering
Het systeem kijkt naar de kenmerken van items die jij eerder waardeerde en zoekt vergelijkbare items.
Volgens IBM richt dit zich op de voorkeuren van één specifieke gebruiker in plaats van op een groep.
Keek je bijvoorbeeld een documentaire over ondernemerschap? Dan krijg je meer titels met datzelfde label.
Sterk als: je maar één gebruiker kent. Het werkt dan al.
Zwak punt: het blijft snel in hetzelfde straatje hangen. Het verrast je zelden met iets nieuws.
Hybride aanpak
De meeste sterke systemen combineren beide, om de zwaktes van elke methode op te vangen.
Netflix gebruikt bijvoorbeeld gedrag van gelijkaardige kijkers én de kenmerken van wat je zelf koos.
Zo vang je de cold start van de ene methode op met de kracht van de andere. IBM merkt wel op dat een hybride systeem meer rekenkracht en een complexere architectuur vraagt.
Het cold start-probleem
Een bekend struikelblok is de “cold start”.
Voor een nieuwe gebruiker of een nieuw item is er nog te weinig data om goed aan te bevelen.
Dat probleem raakt de kern van waarom aanbevelingssystemen datahonger hebben.
De twee methodes naast elkaar
| Kenmerk | Collaborative filtering | Content-based filtering |
|---|---|---|
| Basis voor aanbeveling | Gedrag van gelijkaardige gebruikers | Kenmerken van items die jij koos |
| Nodig om te starten | Veel gebruikers en interacties | Goede item-labels en jouw geschiedenis |
| Sterkste kant | Ontdekt verrassende, nieuwe items | Werkt al bij één gebruiker |
| Zwakste kant | Cold start bij nieuwe gebruikers | Blijft in hetzelfde straatje hangen |
| B2B-geschiktheid | Laag: te weinig volume | Matig: bruikbaar voor contentsuggesties |
Voor B2B is de laatste rij de belangrijkste.
Verwante technieken
Moderne systemen werken vaak met vectoren: een wiskundige weergave van betekenis.
Items die inhoudelijk op elkaar lijken, liggen dan dicht bij elkaar. Dat principe lees je in wat is vectorzoeken.
Diepere neurale netwerken spelen daar ook een rol, zoals uitgelegd in wat is deep learning.
Werkt dit ook in B2B? Een eerlijk antwoord
Zelden op volle kracht. Recommendation engines zijn groot geworden in omgevingen met veel gebruikers en veel items.
Denk aan webshops en streamingdiensten. Die twee voorwaarden ontbreken meestal in B2B.
Waarom de data ontbreekt
Je hebt een smallere doelgroep, minder “producten” en veel lagere volumes.
Daardoor krijgt een aanbevelingssysteem zelden genoeg data om betrouwbaar te worden.
Wat een te zwaar systeem kost
Bouw je een uitgebreid aanbevelingssysteem voor een B2B-site met een handvol diensten en beperkt verkeer?
Dan investeer je in complexe technologie die weinig oplevert. Dat is precies het soort keuze waar wij je vanaf raden.
Stuur liever op wat telt: gekwalificeerde leads en omzet, niet op een indrukwekkende feature.
Waar het in B2B wél helpt
Waar aanbevelingslogica in B2B wél kan helpen, is bescheidener en gerichter:
- Content aanbevelen op een kennis- of blogsectie, om bezoekers dieper in relevante artikels te leiden.
- Volgende stap voorstellen in een lange salescyclus, op basis van wat een lead al bekeek.
- Interne kennisontsluiting, waarbij medewerkers sneller het juiste document vinden.
De tweede toepassing sluit aan bij lead nurturing. De bredere techniek heet dynamische contentpersonalisatie.
Werk je met een kleine lijst topaccounts? Dan is personalisatie op accountniveau vaak de betere keuze.
Begin eenvoudig
Zelfs dan geldt: begin eenvoudig.
Een goed doordachte, handmatige interne linkstructuur en heldere navigatie doen vaak meer dan een algoritme dat te weinig data heeft.
Hoe je die structuur opbouwt, lees je in onze gids over interne links.
Een concreet B2B-voorbeeld
Neem een softwarebedrijf met een uitgebreide kennisbank en een handvol demo-aanvragen per week.
De verleiding is om een aanbevelingssysteem te bouwen dat per bezoeker de “beste volgende dienst” voorspelt.
In de praktijk zien we dat zoiets bij die volumes zelden betrouwbaar wordt. De engine baseert zich op een paar honderd sessies en gokt eigenlijk.
Wat wél werkt: aan het einde van elk kennisartikel drie inhoudelijk verwante artikels tonen, handmatig gekozen of gefilterd op onderwerp.
Dat kost geen datawetenschapper en houdt bezoekers langer in de juiste content.
Vuistregel: de winst zit in de eenvoud, niet in het algoritme.
Groepeer die artikels rond één thema en je hebt een content hub.
De keuze in een tabel
| Jouw situatie | Beste aanpak |
|---|---|
| Webshop met duizenden producten en veel verkeer | Recommendation engine, collaborative of hybride |
| Kennisbank met honderden artikels | Content-based suggesties op onderwerp |
| B2B-site met een handvol diensten | Handmatige interne links en duidelijke navigatie |
| Kleine lijst topaccounts | Personalisatie per account |
Wat zijn de veelgemaakte fouten?
Vier valkuilen komen telkens terug wanneer B2B-bedrijven met aanbevelingssystemen aan de slag gaan:
- Technologie kiezen voor het probleem is gedefinieerd.
- De datahonger onderschatten.
- De cold start negeren.
- Geen menselijke controle.
Technologie voor het probleem
Een engine bouwen omdat het indrukwekkend klinkt, niet omdat er een concrete taak achter zit.
Begin bij de vraag die je wil beantwoorden.
De datahonger onderschatten
Zonder voldoende gebruikers en interacties blijven aanbevelingen gokwerk.
Reken vooraf uit of je verkeer die volumes haalt.
De cold start negeren
Nieuwe items of bezoekers krijgen slechte suggesties.
Voorzie een terugvaloptie, bijvoorbeeld je best presterende of nieuwste content.
Geen menselijke controle
Een algoritme dat ongemerkt irrelevante of gênante combinaties toont, schaadt vertrouwen.
Houd zicht op wat het voorstelt.
Wat is de link met AI-zoekmachines?
Beide halen, op basis van context, het meest relevante naar boven.
Waar een recommendation engine items aan een gebruiker koppelt, koppelt een AI-zoekmachine bronnen aan een vraag.
Hetzelfde principe, een andere schaal
Een AI-zoekmachine kiest uit duizenden pagina’s een handvol bronnen voor één antwoord. Perplexity toont die keuze open en bloot:
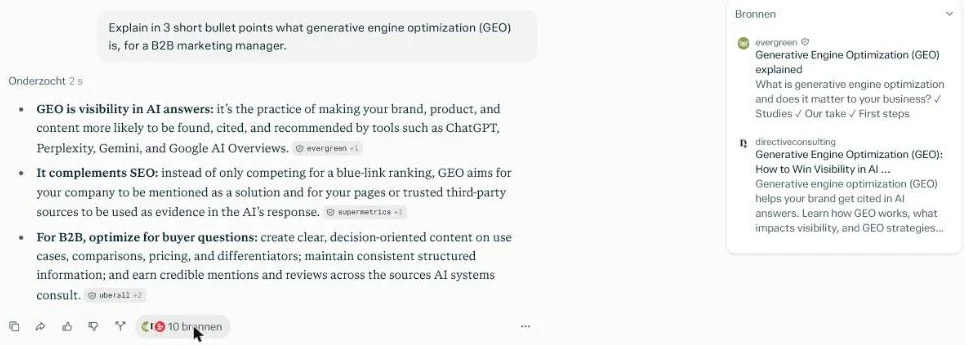 De 10 bronnen achter het antwoord van Perplexity, één klik vanaf de voettekst, oktober 2026.
Wie in dat lijstje staat, werd “aanbevolen” voor die vraag.
Bij conversationeel zoeken gebeurt dat in elke gespreksbeurt opnieuw. Veel van die systemen halen bronnen op via RAG, retrieval-augmented generation.
Dezelfde discipline loont
Zorg dat je content zo helder en goed gestructureerd is dat een systeem ze makkelijk als relevant herkent.
Dat is de kern van generative engine optimization, en het is waar onze GEO-agency aanpak op inzet.
Wil je begrijpen hoe die AI-antwoorden tot stand komen? Lees dan ook onze uitleg over large language models.
Of over semantisch zoeken.
Veelgestelde vragen
Wat is het verschil tussen collaborative en content-based filtering?
Collaborative filtering beveelt aan op basis van wat gelijkaardige gebruikers deden. Content-based filtering kijkt naar de kenmerken van items die jij eerder waardeerde. Veel systemen combineren beide in een hybride aanpak.
Heb ik veel data nodig voor een recommendation engine?
Ja. Zonder voldoende gebruikers, items en gedrag krijgt het systeem geen betrouwbare patronen. Dat maakt het lastig voor B2B met lage volumes, waar het aantal sessies en interacties vaak te klein is om een algoritme scherp te krijgen.
Loont een recommendation engine voor een B2B-website?
Meestal beperkt. Bij weinig verkeer en weinig items levert een geavanceerd systeem weinig op. Een doordachte handmatige structuur en gerichte contentsuggesties zijn vaak effectiever en goedkoper.
Wat heeft dit met AI-zoekmachines te maken?
De logica is verwant: beide halen het meest relevante naar boven op basis van context. Heldere, goed gestructureerde content helpt een systeem in beide gevallen om jou als relevant te herkennen.
Twijfel je of AI-features iets opleveren?
Geen technologie om de technologie, maar keuzes die klanten opleveren.
Vertel ons waar je staat. Neem contact op en je hoort wat wel en niet loont voor jouw B2B-situatie.
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.