
SEO & GEO
FAQPage-schema implementeren voor AI-citaties (na de Google-deprecatie)

Kopieer voor AI
Ja, FAQPage-schema is nog zinvol, maar om een andere reden dan vroeger.
Google heeft de FAQ rich results uit de zoekresultaten gehaald.
Dat uitklapbare blok onder je link verdwijnt dus.
Toch blijft de Q&A-structuur een van de best extraheerbare contentvormen voor AI-engines zoals ChatGPT, Perplexity en Google’s AI Overviews.
Het verdict: FAQPage-schema levert geen rich result meer op, maar het is goedkope verzekering voor AI-zichtbaarheid. De winst zit in de vraag-antwoorddiscipline, niet in de code.
Hieronder: wat Google veranderde, waarom FAQ-structuur nog werkt, en copy-paste JSON-LD voor B2B.
Wat is er precies veranderd bij Google?
Google toont sinds 7 mei 2026 geen FAQ rich results meer, aldus Google’s eigen documentatie-changelog.
Dat is het sluitstuk van een proces dat in 2023 begon.
Van beperking naar volledige stop
In 2023 kondigde Google aan dat FAQ rich results enkel nog zouden verschijnen voor gezaghebbende overheids- en gezondheidssites.
De reden was simpel.
Het FAQ-blok werd massaal misbruikt om meer ruimte in de SERP in te pikken, vaak met vragen die niemand stelde.
In mei 2026 trok Google de stekker eruit voor iedereen. De rest volgde in een paar maanden:
- Juni 2026: het Search Console-rapport, het zoekverschijningsfilter en de Rich Results Test-ondersteuning verdwijnen.
- 15 juni 2026: de documentatiepagina over FAQPage gaat offline.
- Augustus 2026: ook de Search Console API stopt met FAQ-ondersteuning.
Die tijdlijn staat ook in het overzicht bij Search Engine Roundtable.
Moet je je markup verwijderen?
Nee. Google negeert FAQPage-markup voor de weergave, maar het veroorzaakt geen fouten en schaadt je SEO niet.
Vuistregel: verwijderen is optioneel, niet verplicht.
Dat onderscheid is belangrijk.
Het schema blijft vrij om een andere rol te spelen: voer voor AI.
Waarom werkt FAQ-structuur nog voor AI-engines?
Omdat elke vraag gekoppeld is aan één zelfstandig, afgebakend antwoord.
Precies zo’n blok kan een taalmodel makkelijk oppikken. Een AI-engine die een antwoord samenstelt, zoekt passages die op zichzelf staan en een vraag volledig beantwoorden.
Een Q&A-paar is daar de zuiverste vorm van.
Hoe het technisch werkt (en hoe niet)
Hier gaan veel GEO-adviezen de mist in.
AI-modellen lezen je JSON-LD niet als gestructureerde data.
Er is geen publiek bewijs dat assistenten je JSON-LD als aparte datalaag behandelen.
Google zegt zelf dat je geen speciale schema.org-markup nodig hebt voor AI Overviews of AI Mode. Het schema is dus geen magische citatieknop.
Waar de winst dan wel zit
Wie FAQPage-schema implementeert, dwingt zichzelf in een strak patroon: een duidelijke vraag, dan een kort en compleet antwoord.
Dat zichtbare patroon op de pagina is wat AI-engines extraheren.
Het schema is geen oorzaak, maar een discipline.
Daarbovenop noemt Google structured data die overeenkomt met de zichtbare tekst nog altijd bij de goede praktijken voor zijn AI-functies.
Je ziet het verschil in een antwoord van Perplexity. Kijk naar het bronlabel achter elke bullet:
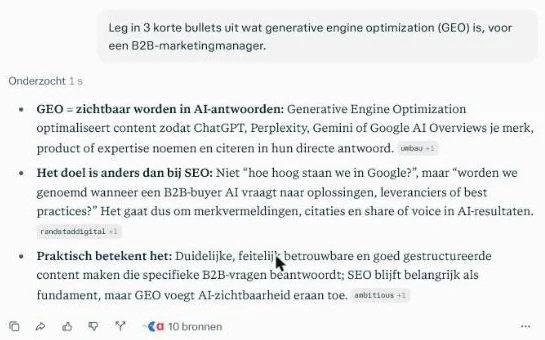 Perplexity op onze eigen GEO-vraag, oktober 2026. Elke bullet leunt op een afgebakende passage uit een bron.
Elke bullet is een losgeknipt antwoordblok. Hoe zelfstandiger je antwoord, hoe makkelijker het daar belandt.
Over het opknippen zelf gaat ook ons stuk over content chunking voor AI-zoekmachines.
Hoe implementeer je FAQPage-schema?
Met een blokje JSON-LD in de <head> of <body> van je pagina.
Elke vraag wordt een Question, elk antwoord een acceptedAnswer. Volgens Schema.org is FAQPage een subtype van WebPage: een pagina met een of meer veelgestelde vragen.
De gouden regel: het schema moet exact overeenkomen met de vragen en antwoorden die zichtbaar op de pagina staan.
Verborgen FAQ’s of afwijkende antwoorden zijn een slecht idee, voor mensen en voor AI. Meer over het formaat lees je bij JSON-LD-markup.
Copy-paste voorbeeld voor B2B
Pas dit voorbeeld aan naar jouw situatie:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [
    {
      "@type": "Question",
      "name": "Voor welke bedrijven is jullie oplossing geschikt?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "Onze oplossing is gebouwd voor B2B-bedrijven met een complexe verkoopcyclus en meerdere beslissers. Typisch werken we met organisaties van 20 tot 500 medewerkers in dienstverlening, software en industrie."
      }
    },

    {
      "@type": "Question",
      "name": "Hoe snel zien we resultaat?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "Eerste vertoningen op lange, specifieke vragen en in AI Overviews zie je vaak binnen dagen tot weken. Brede zoektermen en aanvragen vragen meestal enkele maanden, afhankelijk van je sector en concurrentie."
      }
    },

    {
      "@type": "Question",
      "name": "Wat kost een samenwerking?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "Een traject start typisch vanaf een vast maandbedrag dat we afstemmen op je doelen en scope. Tijdens een gratis intake bepalen we samen welke aanpak past bij je budget en ambitie."
      }
    }
  ]
}
</script>
Drie vragen volstaan om te starten.
Voeg er meer toe zodra je echte klantvragen hebt verzameld. Elke extra vraag krijgt een eigen Question-object binnen mainEntity.
Valideren zonder Rich Results Test
Google’s Rich Results Test ondersteunt FAQ niet langer. Gebruik een algemene validator, zoals de Schema Markup Validator van Schema.org.
Die controleert of je JSON-LD syntactisch klopt. Zo ziet dat eruit op onze eigen site:
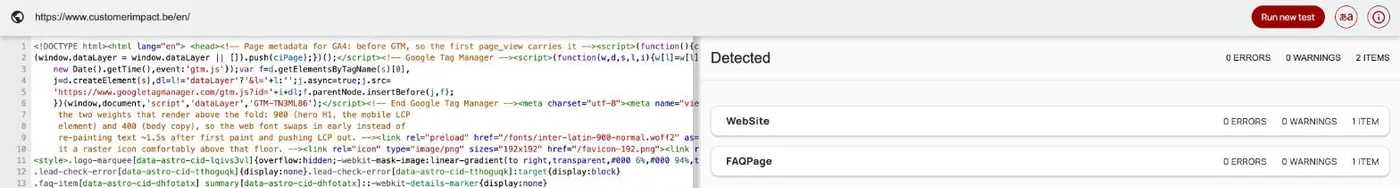 Schema Markup Validator op customerimpact.be, oktober 2026: FAQPage-markup zonder fouten of waarschuwingen.
Nul fouten en nul waarschuwingen: dat is het doel. Veelvoorkomende fouten en hun oplossing staan in schema-markup valideren.
Implementatie in vier stappen
Zo pak je het aan op een bestaande pagina:
- Verzamel de vragen die kopers echt stellen in mails, calls en offertes.
- Schrijf zichtbare antwoorden van twee tot vier zinnen op de pagina.
- Zet ze in JSON-LD met exact dezelfde tekst.
- Valideer met de Schema Markup Validator en controleer na publicatie opnieuw.
Gebruik je ook stappenplannen, kijk dan naar HowTo-schema voor AI en de alternatieven voor FAQ- en HowTo-schema.
Welke vragen zet je in je FAQ voor B2B?
De vragen die je kopers letterlijk intypen of aan een AI-assistent stellen.
Niet de vragen die jou goed uitkomen.
Dat verschil bepaalt of je geciteerd wordt of genegeerd.
Vier soorten vragen die werken
In B2B komen vier types steeds terug:
- Geschiktheidsvragen: “Voor welk type bedrijf is dit?” AI matcht er koper en oplossing mee.
- Vergelijkende vragen: “Wat is het verschil tussen X en Y?” Daar begint veel aankooponderzoek.
- Bezwaar- en risicovragen: “Wat als het niet werkt?” Openheid bouwt vertrouwen, bij lezer en model.
- Prijs- en proceskaders: geen exact tarief, wel een bruikbaar kader.
Bij geschiktheid hoort ook “Werkt dit voor een team van X mensen?”. Bij bezwaren: “Hoe lang duurt de implementatie?”.
Stel bijvoorbeeld dat je IT-dienstverlener bent. Dan is “Werken jullie ook met bedrijven zonder eigen IT-afdeling?” een sterke geschiktheidsvraag.
Zo formuleer je vraag en antwoord
Formuleer elke vraag zoals een mens ze stelt, in volzinnen, niet als trefwoord.
Houd elk antwoord kort en volledig: twee tot vier zinnen die op zichzelf staan.
Stel: je noteert “implementatie ERP kosten” als vraag. Maak er dan van: “Wat kost de implementatie van een ERP voor een kmo?”
Die volzin sluit aan op hoe kopers prompten. Een AI-assistent krijgt zelden een losse zoekterm, maar vaak een volledige vraag.
Let op: schrijf nooit “zoals hierboven”. Die verwijzing breekt zodra een AI-engine je passage loskoppelt.
Die zelfstandigheid is precies wat een model nodig heeft. Meer over vraagkoppen lees je in koppen als vragen voor AI-extractie.
Wil je dit afstemmen op je doelgroep, dan helpt onze gids over GEO voor B2B. En een FAQ die ook verkoopt, bouw je met een FAQ-sectie voor conversie.
Wat zijn de grenzen van FAQ-schema?
FAQ-schema is geen garantie op citaties en geen vervanging voor goede content.
Het is een versterker, geen motor.
Wie denkt dat een blokje JSON-LD de zichtbaarheid in ChatGPT verdrievoudigt, komt bedrogen uit.
De cijfers over het directe effect spreken elkaar tegen. Dat zegt genoeg: er is geen wondermiddel.
Wat wel altijd werkt
Een pagina met het beste antwoord op een vraag, in heldere zelfstandige blokken, wint.
Het schema maakt dat antwoord iets makkelijker vindbaar en ondubbelzinnig.
Begin dus nooit bij het schema.
Begin bij de vraag van je koper en een antwoord dat het waard is om geciteerd te worden.
Een snelle beslisregel
| Situatie | Wat doe je? |
|---|---|
| Bestaande FAQPage-markup | Laten staan, geen actie nodig |
| Nieuwe pagina met echte klantvragen | Zichtbare FAQ plus FAQPage-schema |
| Pagina zonder echte vragen | Geen FAQ verzinnen; schrijf eerst het antwoord |
| Verborgen of afwijkende FAQ | Aanpassen tot schema en tekst gelijk zijn |
Daarna is FAQ-schema lage inspanning, zonder risico, binnen een breder GEO-fundament.
Hoe dat fundament eruitziet, lees je in onze complete GEO-gids. Specifiek voor Google: gevonden worden in Google’s AI Overviews.
Voor Perplexity, dat zijn bronnen zichtbaar toont, lees je gevonden worden in Perplexity.
Veelgestelde vragen over FAQPage-schema
Toont Google nog FAQ rich results?
Nee. Sinds 7 mei 2026 toont Google geen FAQ rich results meer, voor geen enkele site. De markup wordt genegeerd voor de weergave.
Is FAQPage-schema schadelijk voor mijn SEO?
Nee. Bestaande markup veroorzaakt geen fouten en geen ranking-schade. Verwijderen mag, maar hoeft niet.
Lezen ChatGPT en Perplexity mijn JSON-LD?
Daar is geen publiek bewijs voor. Ze extraheren de zichtbare Q&A-tekst; het schema helpt vooral om die structuur strak te houden.
Waarmee valideer ik FAQPage-schema nu?
Met de Schema Markup Validator van Schema.org. Google’s Rich Results Test ondersteunt FAQ sinds juni 2026 niet meer.
De korte samenvatting
Google toont geen FAQ rich results meer sinds mei 2026, maar FAQPage-schema is daarmee niet zinloos.
AI-engines lezen je JSON-LD niet als data. De strakke Q&A-structuur die het schema afdwingt, is wel uitstekend extraheerbaar.
Voor B2B is het goedkope verzekering. Begin bij de vragen die je kopers echt stellen en laat het schema het bevestigen.
Wil je weten hoe klaar je hele site is voor AI-zoekmachines? Bekijk onze aanpak voor vindbaarheid in AI-zoekmachines of neem contact op.
Gratis website-scan
Geef je website in en krijg binnen enkele minuten een automatische scan met concrete technische en SEO-verbeterpunten. Geen verkooppraatje.
Je gegevens gebruiken we alleen voor je scan. Geen spam, uitschrijven kan altijd.